Limitando a dimensão do subespaço
Neste passo a passo, mostraremos o efeito da dimensão do subespaço na técnica de recuperação de configurações autoconsistente.
A priori, não sabemos qual é a dimensão correta do subespaço para obter um nível-alvo de precisão. No entanto, sabemos que aumentar a dimensão do subespaço aumenta a precisão do método. Portanto, podemos estudar a precisão das previsões em função da dimensão do subespaço. Especifique a molécula e suas propriedades.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "pyscf": "pyscf", "qiskit_addon_sqd": "qiskit-addon-sqd"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import warnings

import pyscf
import pyscf.cc
import pyscf.mcscf

warnings.filterwarnings("ignore")

# Specify molecule properties
open_shell = False
spin_sq = 0

# Build N2 molecule
mol = pyscf.gto.Mole()
mol.build(
    atom=[["N", (0, 0, 0)], ["N", (1.0, 0, 0)]],
    basis="6-31g",
    symmetry="Dooh",
)

# Define active space
n_frozen = 2
active_space = range(n_frozen, mol.nao_nr())

# Get molecular integrals
scf = pyscf.scf.RHF(mol).run()
num_orbitals = len(active_space)
n_electrons = int(sum(scf.mo_occ[active_space]))
num_elec_a = (n_electrons + mol.spin) // 2
num_elec_b = (n_electrons - mol.spin) // 2
cas = pyscf.mcscf.CASCI(scf, num_orbitals, (num_elec_a, num_elec_b))
mo = cas.sort_mo(active_space, base=0)
hcore, nuclear_repulsion_energy = cas.get_h1cas(mo)
eri = pyscf.ao2mo.restore(1, cas.get_h2cas(mo), num_orbitals)

# Compute exact energy
exact_energy = cas.run().e_tot
converged SCF energy = -108.835236570775
CASCI E = -109.046671778080  E(CI) = -32.8155692383188  S^2 = 0.0000000
Gere algumas bitstrings aleatórias para simular amostras de QPU.
import numpy as np
from qiskit_addon_sqd.counts import generate_bit_array_uniform

# Create a seed to control randomness throughout this workflow
rng = np.random.default_rng(24)

# Generate random samples
bit_array = generate_bit_array_uniform(
    10_000, num_orbitals * 2, rand_seed=rng
)
Chame o SQD com tamanhos de lote crescentes.
from qiskit_addon_sqd.fermion import diagonalize_fermionic_hamiltonian

list_samples_per_batch = [50, 200, 400, 600]

# SQD options
max_iterations = 5

# Eigenstate solver options
num_batches = 10
max_davidson_cycles = 200

energies = []
subspace_dimensions = []

for samples_per_batch in list_samples_per_batch:
    result = diagonalize_fermionic_hamiltonian(
        hcore,
        eri,
        bit_array,
        samples_per_batch=samples_per_batch,
        norb=num_orbitals,
        nelec=(num_elec_a, num_elec_b),
        num_batches=num_batches,
        max_iterations=max_iterations,
        symmetrize_spin=True,
        seed=rng,
    )
    energies.append(result.energy)
    subspace_dimensions.append(np.prod(result.sci_state.amplitudes.shape))
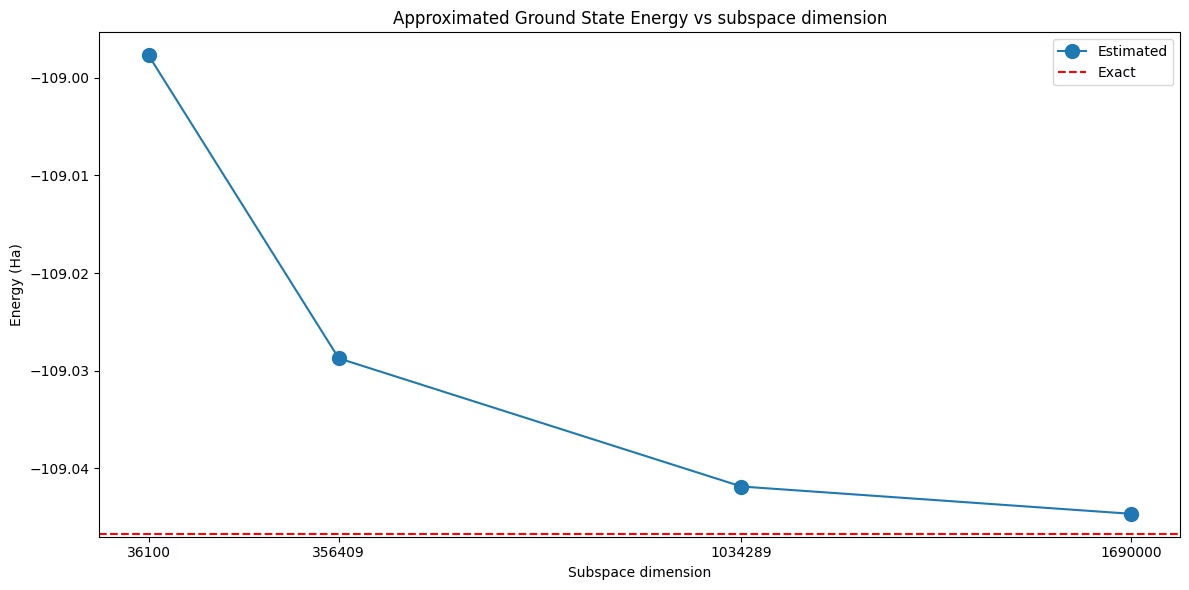
Este gráfico mostra que aumentar a dimensão do subespaço leva a resultados mais precisos.
import matplotlib.pyplot as plt

# Data for energies plot
x1 = subspace_dimensions
y1 = np.array(energies) + nuclear_repulsion_energy

fig, axs = plt.subplots(1, 1, figsize=(12, 6))

# Plot energies
axs.plot(x1, y1, marker=".", markersize=20, label="Estimated")
axs.set_xticks(x1)
axs.set_xticklabels(x1)
axs.axhline(y=exact_energy, color="red", linestyle="--", label="Exact")
axs.set_title("Approximated Ground State Energy vs subspace dimension")
axs.set_xlabel("Subspace dimension")
axs.set_ylabel("Energy (Ha)")
axs.legend()

plt.tight_layout()
plt.show()
Definindo um limite explícito com max_dim
Na varredura acima, a dimensão do subespaço foi controlada apenas indiretamente. samples_per_batch define quantas bitstrings são sorteadas para cada lote, mas a dimensão do subespaço resultante é determinada por quantas strings de spin alfa e spin beta distintas essas bitstrings contêm, e o conjunto de configurações disponíveis para subamostragem cresce de uma iteração de recuperação de configurações para a seguinte. É por isso que as dimensões do subespaço no eixo horizontal acima são números irregulares que nós não escolhemos.
O argumento max_dim de diagonalize_fermionic_hamiltonian limita a dimensão diretamente. Ele limita o número de strings CI mantidas em cada setor de spin e, como o subespaço é gerado pelo produto cartesiano dos dois setores, sua dimensão é o produto das dimensões dos dois setores:
-
max_dim=dlimita ambos os setores adstrings, de modo que a dimensão do subespaço é no máximod ** 2. -
max_dim=(d_a, d_b)limita os setores de spin alfa e spin beta separadamente, de modo que a dimensão do subespaço é no máximod_a * d_b. Quandosymmetrize_spin=True, os dois limites devem ser iguais. -
max_dim=None, o padrão, não impõe nenhum limite.
Quando um lote contém mais strings do que o limite permite, as menos importantes são descartadas: as strings passadas por include_configurations são mantidas primeiro, seguidas das strings herdadas da iteração anterior (veja carryover_threshold), e as vagas restantes são preenchidas com as strings amostradas em ordem decrescente de frequência com que foram amostradas.
Como max_dim limita o tamanho da maior diagonalização que o solucionador de autoestados será solicitado a realizar, é uma maneira conveniente de manter o solucionador dentro de um orçamento de tempo de execução e memória: escolha samples_per_batch com folga e deixe que max_dim decida o quanto o subespaço pode crescer.
A seguir, repetimos o estudo, desta vez mantendo samples_per_batch fixo e aumentando max_dim.
list_max_dim = [100, 200, 400, 800]

# Use a generous number of samples per batch, so that max_dim is what limits
# the dimension of the subspace
samples_per_batch = 600

energies_max_dim = []
subspace_dimensions_max_dim = []

for max_dim in list_max_dim:
    result = diagonalize_fermionic_hamiltonian(
        hcore,
        eri,
        bit_array,
        samples_per_batch=samples_per_batch,
        norb=num_orbitals,
        nelec=(num_elec_a, num_elec_b),
        num_batches=num_batches,
        max_iterations=max_iterations,
        symmetrize_spin=True,
        max_dim=max_dim,
        seed=rng,
    )
    energies_max_dim.append(result.energy)
    subspace_dimensions_max_dim.append(
        int(np.prod(result.sci_state.amplitudes.shape))
    )

print(f"max_dim:            {list_max_dim}")
print(f"subspace dimension: {subspace_dimensions_max_dim}")
max_dim:            [100, 200, 400, 800]
subspace dimension: [10000, 40000, 160000, 640000]
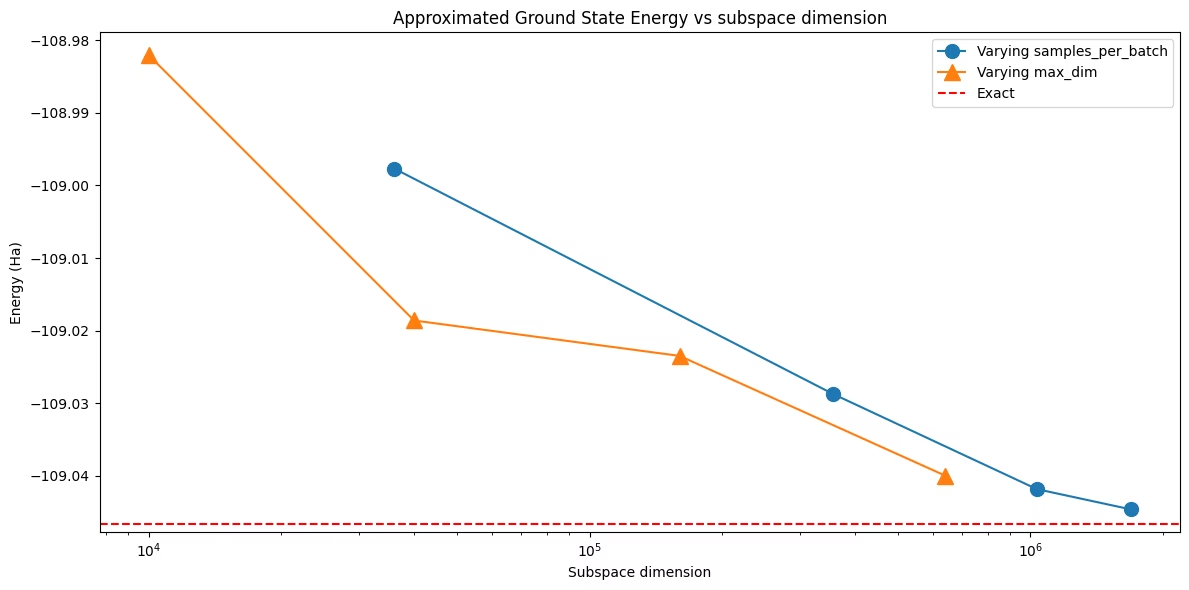
Agora a dimensão do subespaço é exatamente max_dim ** 2 em todas as execuções: ela foi escolhida, em vez de descoberta. Plotar as duas varreduras juntas mostra que a precisão é governada pela própria dimensão do subespaço, seja qual for o argumento usado para chegar a ela. As duas curvas, porém, não precisam coincidir exatamente. As execuções com max_dim sorteiam 600 bitstrings por lote e depois mantêm as strings amostradas com mais frequência, então, para uma dada dimensão, podem reter um conjunto de configurações melhor do que uma execução que chegou a essa dimensão amostrando menos bitstrings desde o início.
fig, axs = plt.subplots(1, 1, figsize=(12, 6))

axs.plot(
    subspace_dimensions,
    np.array(energies) + nuclear_repulsion_energy,
    marker=".",
    markersize=20,
    label="Varying samples_per_batch",
)
axs.plot(
    subspace_dimensions_max_dim,
    np.array(energies_max_dim) + nuclear_repulsion_energy,
    marker="^",
    markersize=12,
    label="Varying max_dim",
)
axs.axhline(y=exact_energy, color="red", linestyle="--", label="Exact")
axs.set_xscale("log")
axs.ticklabel_format(axis="y", useOffset=False)
axs.set_title("Approximated Ground State Energy vs subspace dimension")
axs.set_xlabel("Subspace dimension")
axs.set_ylabel("Energy (Ha)")
axs.legend()

plt.tight_layout()
plt.show()