Atualize as propriedades do backend com benchmarking em tempo real
Estimativa de uso: 3 minutos no ibm_kingston (OBSERVAÇÃO: Isso é apenas uma estimativa. Seu tempo de execução pode variar.)
Resultados de aprendizado
-
Por que as propriedades relatadas por uma QPU podem estar defasadas em relação ao comportamento atual do dispositivo, e quando vale a pena medi-las novamente por conta própria
-
O que cada um dos cinco experimentos de caracterização padrão (leitura, benchmarking randomizado de um qubit, benchmarking randomizado em camadas de dois qubits, e ) mede
-
Como executar o conjunto completo de caracterização em uma única chamada ou passo a passo, e obter de volta um objeto backend com propriedades atualizadas
-
Como comparar as propriedades medidas com as relatadas, e por que algumas diferenças refletem a metodologia de medição em vez de deriva do dispositivo
Pré-requisitos
-
O fluxo de trabalho dos padrões Qiskit
-
Modos de execução do Qiskit Runtime, em particular o batch mode
-
Como explorar informações da QPU, como propriedades do backend e dados de calibração
Contexto
Toda QPU IBM Quantum® relata um conjunto de propriedades que descrevem o quão bem cada um de seus qubits está funcionando atualmente: tempos de relaxação (), tempos de coerência (), erros de leitura e erros de gate de um e dois qubits. Esses números importam na prática. O transpiler os usa para decidir em quais qubits físicos seu circuito deve ser executado, técnicas de mitigação de erro dependem deles, e você pode usá-los para julgar se um dispositivo está funcionando bem o suficiente para um experimento.
As propriedades informadas vêm de procedimentos de calibração que geralmente são executados cerca de uma vez por dia. Qubits supercondutores, no entanto, podem sofrer deriva em escalas de tempo mais curtas, e defeitos transitórios (chamados sistemas de dois níveis) podem degradar temporariamente um qubit que parecia excelente no momento da calibração. Além disso, um job frequentemente é transpilado bem antes de realmente ser executado, então decisões baseadas nas propriedades informadas podem se apoiar em informações desatualizadas. O tutorial Benchmarking em tempo real para seleção de qubits mostra o quanto essas propriedades podem flutuar de um dia para o outro, e constrói manualmente um fluxo de trabalho de caracterização completo a partir de Qiskit Experiments individuais.
Este tutorial mostra a versão simplificada desse fluxo de trabalho, usando o utilitário BackendCharacterization do Qiskit Device Benchmarking, que empacota a construção do experimento, o envio de jobs e o ajuste de curvas em algumas chamadas. Você gasta aproximadamente 70 segundos de tempo de QPU e obtém de volta um objeto backend cujas propriedades refletem o dispositivo agora mesmo, pronto para ser comparado com os valores relatados ou passado adiante para ferramentas subsequentes.
Os experimentos de caracterização
O conjunto mede cinco propriedades, cada uma com um experimento padrão:
-
Erro de leitura (
readout): Cada qubit é preparado em ou e imediatamente medido. A probabilidade de ler o estado errado fornece o erro de preparação e medição de estado (SPAM). -
Erro de gate de um qubit (
rb_1q): O benchmarking randomizado (RB) executa sequências de gates de Clifford de um qubit aleatórios que idealmente se compõem para a identidade. A forma como a probabilidade de sobrevivência decai com o comprimento da sequência produz o erro médio por gate, independente dos erros de SPAM. -
Erro de gate de dois qubits (
rb_2q): A mesma ideia de RB aplicada a camadas completas de gates de dois qubits não sobrepostos executados simultaneamente, como em um experimento de fidelidade de camada. Como muitos gates são executados de uma vez, as taxas de erro resultantes incluem efeitos de crosstalk e estão mais próximas do que um circuito profundo realmente experimenta. -
(
t1): Cada qubit é excitado e medido após atrasos crescentes. O decaimento da população do estado excitado fornece o tempo de relaxação. -
(
t2): Um experimento de eco de Hahn coloca cada qubit em uma superposição, aplica um pulso de eco na metade de um atraso e mede quão rapidamente a coerência de fase é perdida. Por padrão, um único eco é usado; uma variante multi-eco (estilo CPMG) é demonstrada no final deste tutorial.
O que a atualização faz e não faz
Tenha três pontos em mente ao usar esse fluxo de trabalho:
-
As propriedades atualizadas existem apenas no objeto backend retornado a você. Nada muda no próprio dispositivo ou nos dados de calibração que a IBM Quantum relata a outros usuários.
-
Os valores medidos são um instantâneo obtido com uma metodologia específica. Alguns deles, notavelmente os erros de dois qubits em camadas e os valores de de eco único em paralelo, são medidos de forma diferente dos dados de calibração relatados, então parte de qualquer diferença observada é metodológica, não deriva. Este tutorial aponta onde isso acontece.
-
A própria caracterização custa tempo de QPU (cerca de 70 segundos para o conjunto completo em um processador Heron r2), que é o preço de informações atualizadas.
O fluxo de trabalho segue as quatro etapas de um padrão Qiskit:
-
Etapa 1: Mapear entradas clássicas para um problema quântico. Escolha o dispositivo e o conjunto de propriedades a medir.
-
Etapa 2: Otimizar o problema para execução em hardware quântico. O utilitário constrói os circuitos de experimento diretamente nos gates nativos do dispositivo e os paraleliza no chip.
-
Etapa 3: Executar usando primitivas Qiskit. Os experimentos são executados como jobs do Sampler dentro de um batch.
-
Etapa 4: Pós-processar e retornar o resultado no formato clássico desejado. Ajuste os dados de medição em mapas de erro por qubit, atualize o backend e compare as propriedades medidas com as relatadas.
Requisitos
Antes de iniciar este tutorial, certifique-se de ter instalado o seguinte:
-
Qiskit SDK v2.0 ou posterior, com suporte a visualização
-
Qiskit Runtime v0.40 ou posterior (
pip install qiskit-ibm-runtime) -
Qiskit Device Benchmarking, que também instala o Qiskit Experiments (
pip install git+https://github.com/qiskit-community/qiskit-device-benchmarking.git)
Configuração
Importe as bibliotecas necessárias.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"numpy": "numpy", "qiskit_device_benchmarking": "git+https://github.com/qiskit-community/qiskit-device-benchmarking.git", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import logging
import sys

import numpy as np
from qiskit_ibm_runtime import Batch, QiskitRuntimeService

from qiskit_device_benchmarking.utilities.characterization_utils import (
    BackendCharacterization,
    plot_characterization_comparison,
)
O conjunto de caracterização constrói vários experimentos, submete múltiplos jobs e ajusta os resultados, o que pode levar alguns minutos no total. Ative o registro em nível INFO para que cada estágio imprima seu progresso à medida que acontece.
logger = logging.getLogger("qiskit_device_benchmarking")
logger.setLevel(logging.INFO)
logger.addHandler(logging.StreamHandler(stream=sys.stdout))
Exemplo de simulador em pequena escala
Este tutorial não inclui um exemplo de simulador. O fluxo de trabalho mede as imperfeições físicas de um dispositivo específico: com que rapidez seus qubits relaxam e perdem a coerência de fase (defasam), e com que frequência suas portas e leituras falham. Um simulador ideal não tem nenhuma dessas imperfeições, então não há nada a caracterizar. Você poderia anexar um modelo de ruído sintético a um backend falso, mas os experimentos então recuperariam apenas os números que você mesmo inseriu. Por esse motivo, seguimos diretamente para o hardware, dividido nas quatro etapas de um padrão Qiskit.
Exemplo de hardware em grande escala
Etapa 1: Mapear entradas clássicas para um problema quântico
Neste fluxo de trabalho, o "problema" é o próprio dispositivo: as entradas clássicas são a QPU que você deseja caracterizar e a lista de propriedades a medir, e os experimentos quânticos são os circuitos de caracterização gerados a partir delas.
Primeiro, selecione um backend. Este tutorial usa ibm_kingston, um processador Heron r2 de 156 qubits; você pode substituir por qualquer dispositivo IBM Quantum ao qual tenha acesso (ou escolher um com service.least_busy()).
service = QiskitRuntimeService()
device = "ibm_kingston"
backend = service.backend(device)
Em seguida, escolha quais propriedades medir. Você pode passar qualquer subconjunto dos seguintes experimentos:
-
readout: experimento SPAM (preparação e medição de estado) -
rb_1q: benchmarking randomizado isolado de um qubit -
rb_2q: benchmarking randomizado de dois qubits simultâneo a partir de um experimento de fidelidade em camadas -
t2: experimento de eco de Hahn (um único eco por padrão) -
t1: experimento de relaxação
Execute o conjunto completo para obter um quadro completo do dispositivo; remova entradas da lista se você se importar apenas com algumas propriedades e quiser economizar tempo de QPU.
experiments = ["readout", "rb_1q", "rb_2q", "t1", "t2"]
Etapa 2: Otimizar o problema para execução em hardware quântico
Na maioria dos tutoriais, é aqui que você transpilaria seus circuitos. Aqui, BackendCharacterization cuida disso internamente. Ele constrói os circuitos de experimento diretamente nos gates nativos do dispositivo, executa os experimentos de qubit único em todos os qubits em paralelo e agenda o benchmarking de dois qubits em camadas disjuntas do mapa de acoplamento, de modo que todo o dispositivo seja coberto com um punhado de jobs. Por causa dessa paralelização, todo o conjunto consome apenas cerca de 70 segundos de tempo de QPU.
Inicialize a classe que gerencia o fluxo de trabalho:
# Initialize the class used to run the experiments
characterizer = BackendCharacterization(backend)
Etapa 3: Executar usando primitivas do Qiskit
O método run_experiments constrói os circuitos e os submete como jobs do Sampler. Execute-o dentro de um contexto Batch para que os jobs sejam agendados juntos na QPU, e o método retorna assim que todos os jobs forem submetidos. (Você também pode executá-lo fora de um batch, ou dentro de uma Session.)
Você pode ver um aviso sobre um backend sendo passado enquanto um gerenciador de contexto de session está aberto. Isso é esperado e pode ser ignorado com segurança.
# Run the characterization experiments inside a Batch
with Batch(backend=backend):
    jobs = characterizer.run_experiments(experiments=experiments)
base_primitive.get_mode_service_backend:WARNING:2026-07-14 14:23:02,051: A backend was passed in as the mode but a session context manager is open so this job will run inside this session/batch instead of in job mode.
Building readout experiments
Building 1Q RB experiments
Building 2Q RB experiments
Building T1 experiments
Building T2 experiments
Layered two-qubit RB submitted: ['d9b7tfu6hjac73ffba2g', 'd9b7tjug26ic73dfju3g', 'd9b7u3u6hjac73ffban0', 'd9b7u7rv6alc73csmicg']
Readout job submitted: d9b7u8bv6alc73csmidg
T1 experiment submitted: ['d9b7u8ug26ic73dfjuqg']
T2 (Hahn) experiment submitted: ['d9b7u9fu62qs738othg0']
Single-qubit RB submitted: ['d9b7v8m6hjac73ffbc40', 'd9b7veeg26ic73dfk040']
O método retorna os jobs submetidos como um dicionário indexado por experimento, o que é útil para rastreá-los no painel do IBM Quantum Platform ou para depuração.
# Print all the job IDs for debugging purposes
jobs
{'rb_2q': [<RuntimeJobV2('d9b7tfu6hjac73ffba2g', 'sampler')>,
  <RuntimeJobV2('d9b7tjug26ic73dfju3g', 'sampler')>,
  <RuntimeJobV2('d9b7u3u6hjac73ffban0', 'sampler')>,
  <RuntimeJobV2('d9b7u7rv6alc73csmicg', 'sampler')>],
 'readout': [<RuntimeJobV2('d9b7u8bv6alc73csmidg', 'sampler')>],
 't1': [<RuntimeJobV2('d9b7u8ug26ic73dfjuqg', 'sampler')>],
 't2': [<RuntimeJobV2('d9b7u9fu62qs738othg0', 'sampler')>],
 'rb_1q': [<RuntimeJobV2('d9b7v8m6hjac73ffbc40', 'sampler')>,
  <RuntimeJobV2('d9b7veeg26ic73dfk040', 'sampler')>]}
Etapa 4: Pós-processar e retornar o resultado no formato clássico desejado
Analise os resultados
O método analyze_results espera os jobs terminarem e ajusta os dados de medição: decaimentos exponenciais para e , decaimentos de probabilidade de sobrevivência para os experimentos de RB e matrizes de atribuição para a leitura. Ele retorna um dicionário de mapas de erro, uma entrada por propriedade medida, cada uma mapeando um qubit (ou par de qubits) para seu valor medido.
error_maps = characterizer.analyze_results()
print(f"The following error maps are available: {list(error_maps.keys())}")
readout_q0 = error_maps["readout_error"][0]
print(f"For example, readout error for qubit 0 is {readout_q0}")
The following error maps are available: ['readout_error', 'oneq_error_x', 'oneq_error_sx', 'lf_error_map', 't1_map', 't2_map']
For example, readout error for qubit 0 is 0.007600000000000051
Os mapas cobrem o erro de leitura, os erros das gates x e sx de qubit único, os erros em camadas de dois qubits (lf_error_map, do experimento de fidelidade em camadas), e os tempos e em segundos.
Atualize as propriedades do backend
O método update_backend grava os valores medidos nas propriedades de uma cópia do backend e a retorna. O objeto backend original mantém os dados de calibração informados, para que possamos comparar os dois, como mostrado abaixo. Lembre-se de que essa atualização é puramente local à sua sessão do Python; ela não altera nada no dispositivo ou para outros usuários.
backend_updated = characterizer.update_backend()
Updating readout error
Updating single-qubit X error
Updating single-qubit SX error
Updating two-qubit error
Updating T1
Updating T2
Compare as propriedades medidas com as informadas
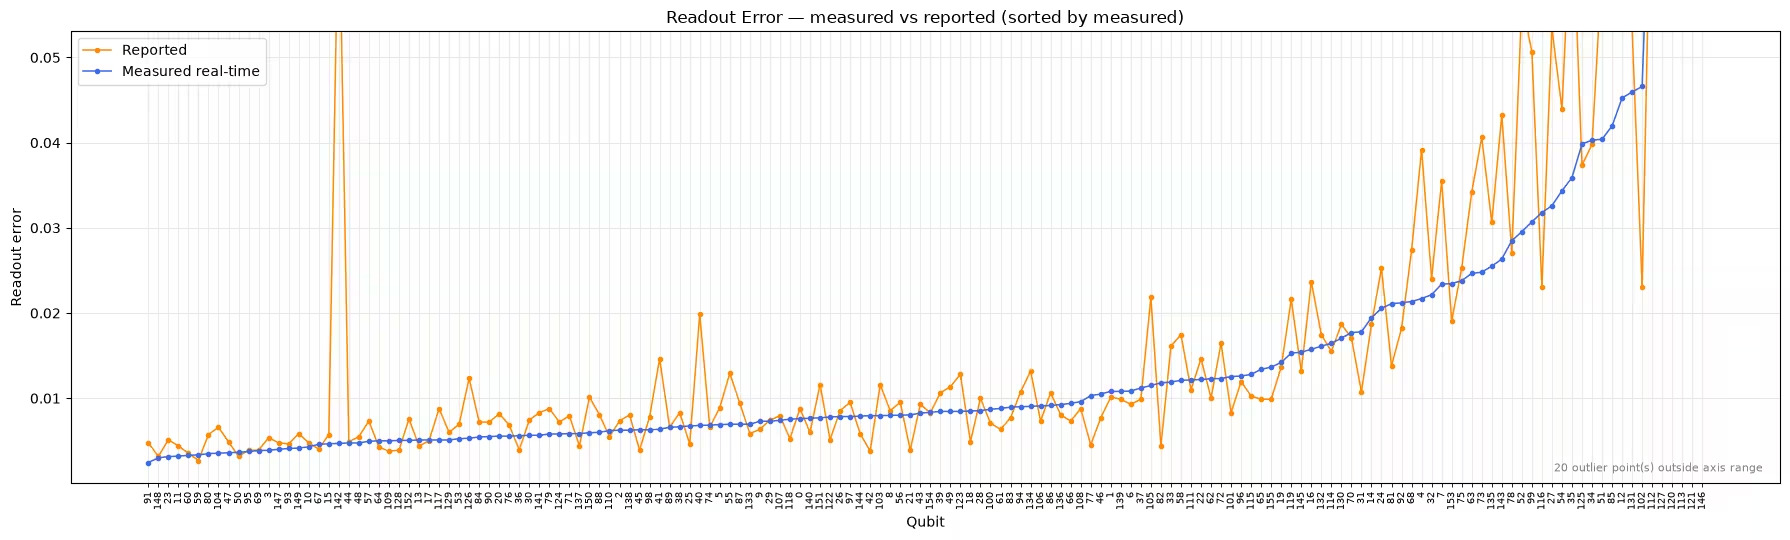
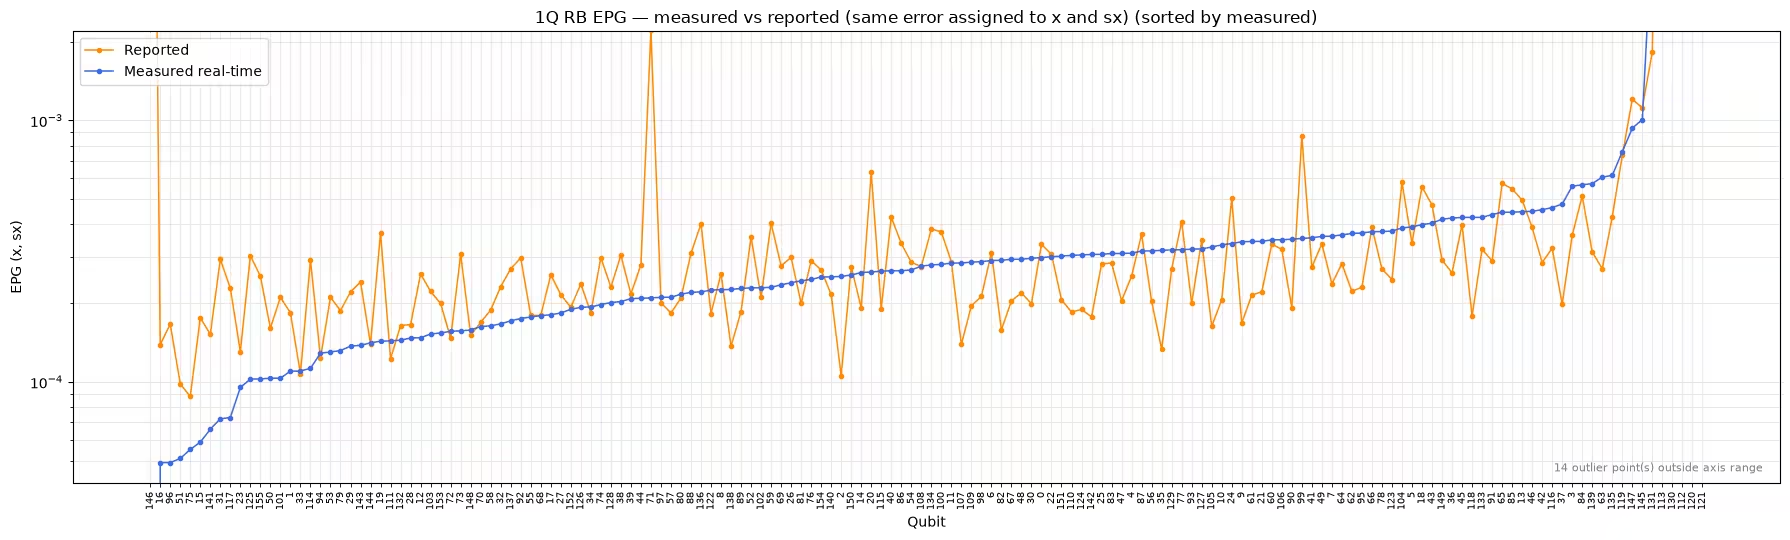
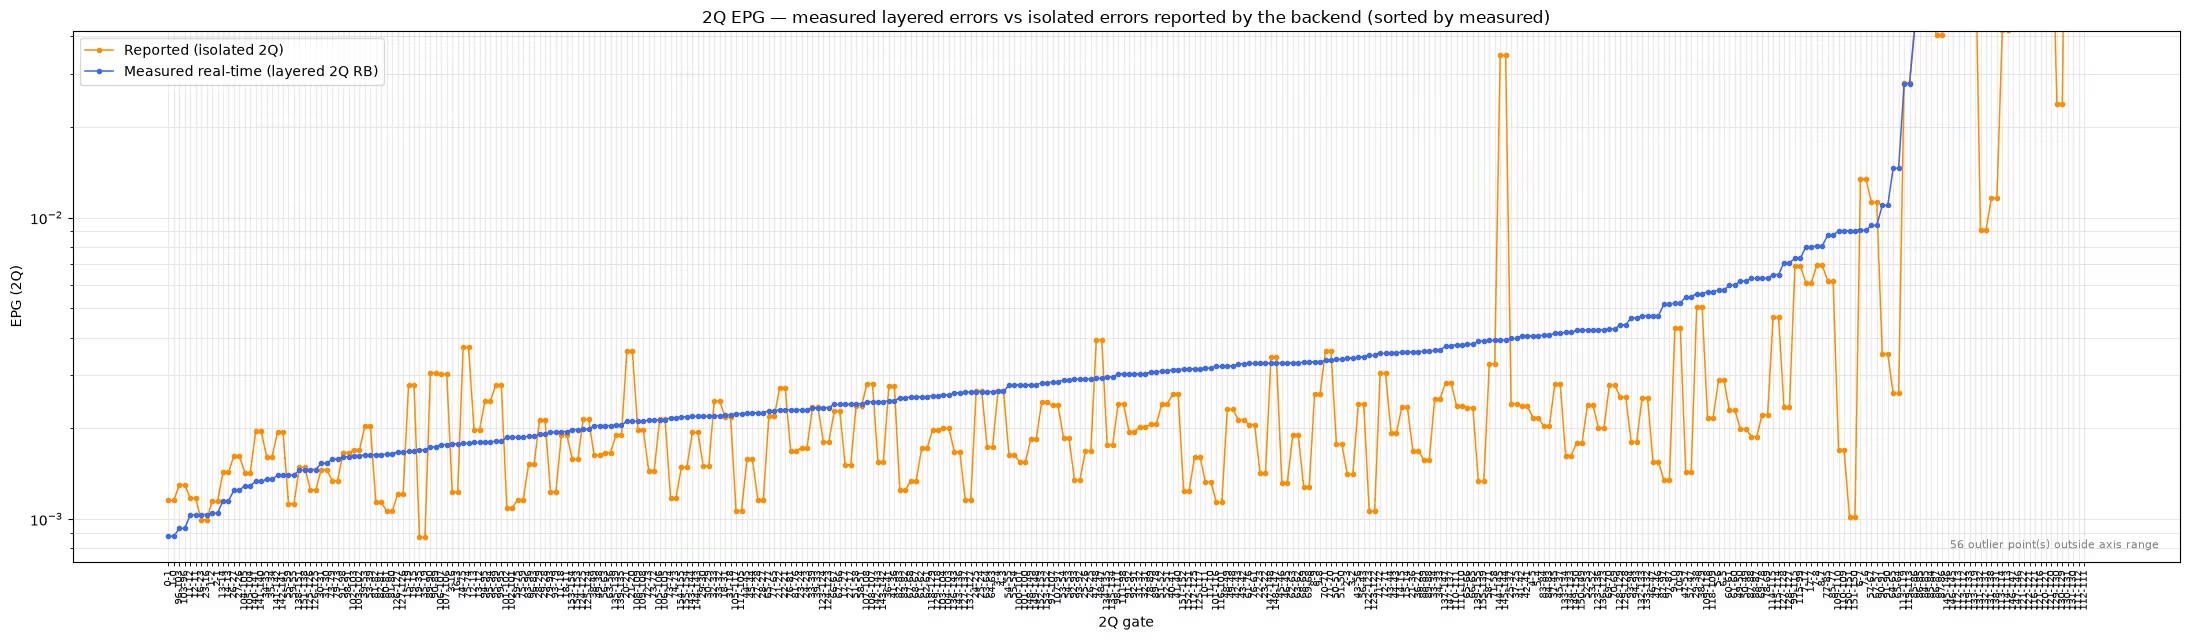
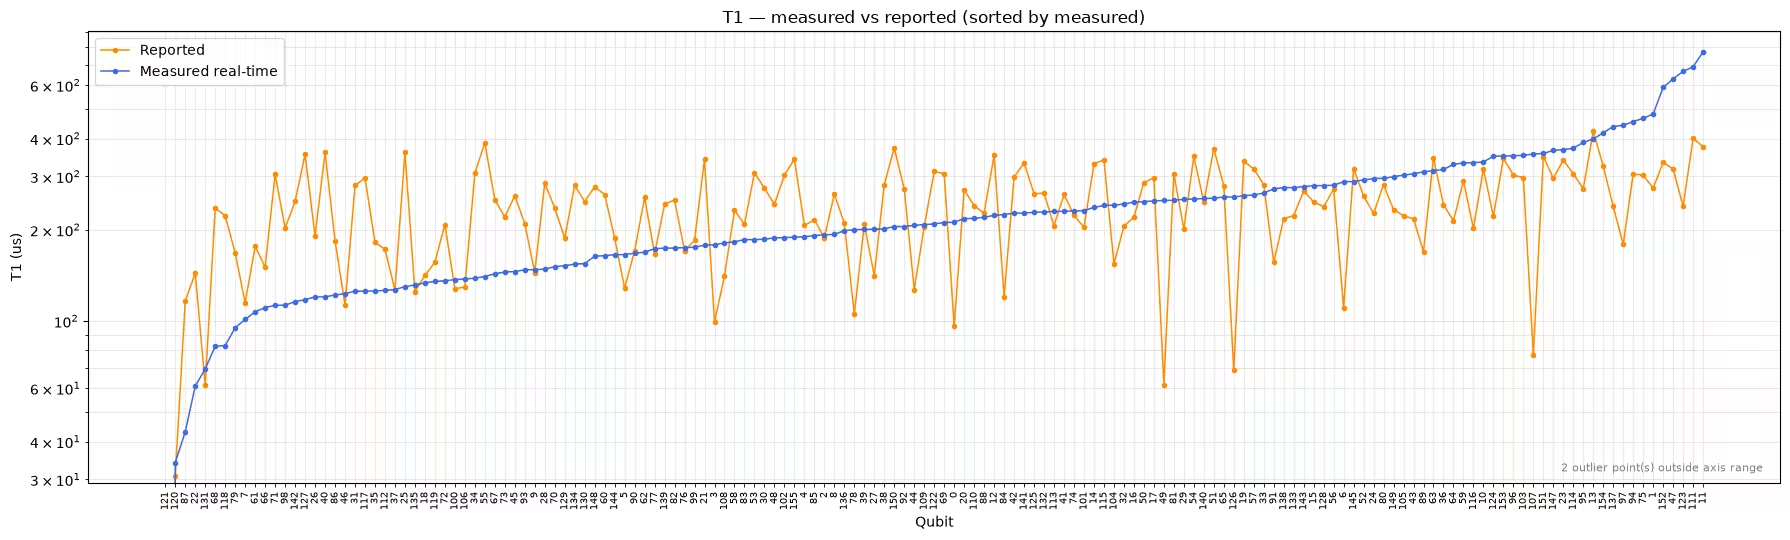
Por fim, plote as propriedades medidas em tempo real em relação aos valores que o backend informa. Em cada painel, os qubits (ou pares de qubits) são ordenados pelo valor medido, de modo que a curva medida é suave por construção e a dispersão dos valores informados ao seu redor mostra onde os dois discordam. Um único gráfico é mostrado para RB de qubit único porque o mesmo erro medido por gate é atribuído tanto às gates x quanto sx. Os limites dos eixos são escolhidos a partir da maior parte dos dados, para que alguns valores extremos discrepantes não comprimam os gráficos; quaisquer pontos fora do intervalo são contados em uma anotação no gráfico (ou passe ylim para substituir os limites).
plot_characterization_comparison(
    old_props=backend.properties().to_dict(),
    new_props=backend_updated.properties().to_dict(),
    plots=["readout", "rb_1q", "rb_2q", "t1", "t2"],
)
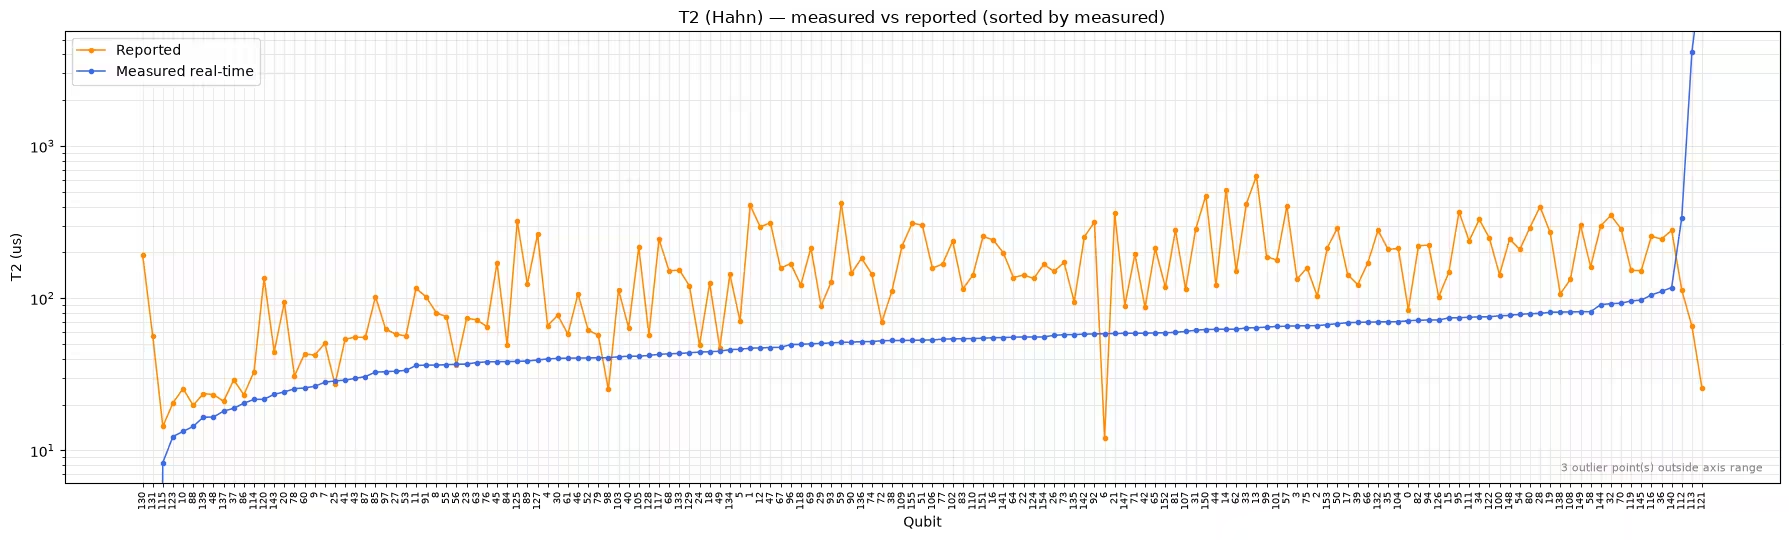
Esses gráficos exigem uma leitura cuidadosa, porque nem toda diferença entre as duas curvas significa que o dispositivo sofreu deriva:
-
Erros de leitura e de qubit único: Os valores medidos acompanham os informados para a maioria dos qubits, enquanto o valor informado para um punhado de qubits está muito distante da curva medida. Essas discordâncias localizadas são a deriva que este fluxo de trabalho foi projetado para detectar.
-
: Os dois conjuntos de dados se dispersam um em torno do outro sem deslocamento sistemático, o que é consistente com flutuando naturalmente ao longo do tempo.
-
Erros de dois qubits: Os valores medidos ficam sistematicamente acima dos informados. Isso é esperado porque os valores informados são medidos em gates isoladas, enquanto o experimento de fidelidade em camadas executa muitas gates simultaneamente e, portanto, inclui crosstalk. Os números em camadas são mais relevantes para circuitos profundos, mas não são diretamente comparáveis aos dados de calibração informados.
-
: Os valores medidos ficam bem abaixo dos informados para a maioria dos qubits. Novamente, a metodologia desempenha um papel importante, como examinado na próxima seção.
Inspecione os resultados de experimentos individuais
Você também pode inspecionar os resultados brutos dos experimentos de caracterização individuais por meio da propriedade experiment_data, que retorna os objetos ExperimentData subjacentes do Qiskit Experiments. Por exemplo, o seguinte exibe a curva de decaimento medida de um único qubit, o que é útil para verificar a qualidade de um ajuste antes de confiar no número que ele produziu.
t1_data = characterizer.experiment_data["t1"]

# Each qubit has its own fit figure
n_figs = len(t1_data.figure_names)
print(f"{n_figs} figures available, e.g. {t1_data.figure_names[0]}")

# Show the T1 decay curve of the first qubit
t1_data.figure(0)
156 figures available, e.g. T1_Q0_c78ef792.svg

Meça T2 com um trem de desacoplamento dinâmico
Por padrão, o experimento aplica um único eco de Hahn e mede todos os qubits em paralelo, o que, como mostrou o gráfico de comparação acima, pode gerar valores de perceptivelmente mais baixos do que os informados pelo backend. Uma hipótese é o número de ecos: os valores informados podem ser calibrados com desacoplamento dinâmico, que suprime ruído de baixa frequência. Para testar isso, execute uma caracterização apenas de com t2_num_echoes definido como um valor maior, o que aplica um trem de pulsos de eco no estilo CPMG. Os atrasos representam o tempo total de evolução livre em ambos os casos, portanto os valores de ajustados são diretamente comparáveis aos resultados de eco único.
# Run a T2-only characterization using a CPMG-style train of 8 echoes
characterizer_dd = BackendCharacterization(backend)
backend_updated_dd = characterizer_dd.run_and_update(
    experiments=["t2"], t2_num_echoes=8
)
Building T2 experiments
T2 (Hahn) experiment submitted: ['d9b96s6g26ic73dflcn0']
Updating T2
# Compare the multi-echo T2 against the backend-reported values
plot_characterization_comparison(
    old_props=backend.properties().to_dict(),
    new_props=backend_updated_dd.properties().to_dict(),
    plots=["t2"],
    title_prefix="8-echo CPMG",
)

# Compare medians across the reported values, the single-echo run,
# and the 8-echo run
reported_t2s = [
    prop["value"]
    for qubit in backend.properties().to_dict()["qubits"]
    for prop in qubit
    if prop["name"] == "T2"
]
t2_reported = np.median(reported_t2s)
t2_single = np.median(list(error_maps["t2_map"].values())) * 1e6
t2_dd = (
    np.median(list(characterizer_dd.analyze_results()["t2_map"].values()))
    * 1e6
)
print(
    f"Median T2 — reported: {t2_reported:.0f} us | "
    f"single echo: {t2_single:.0f} us | 8-echo CPMG: {t2_dd:.0f} us"
)
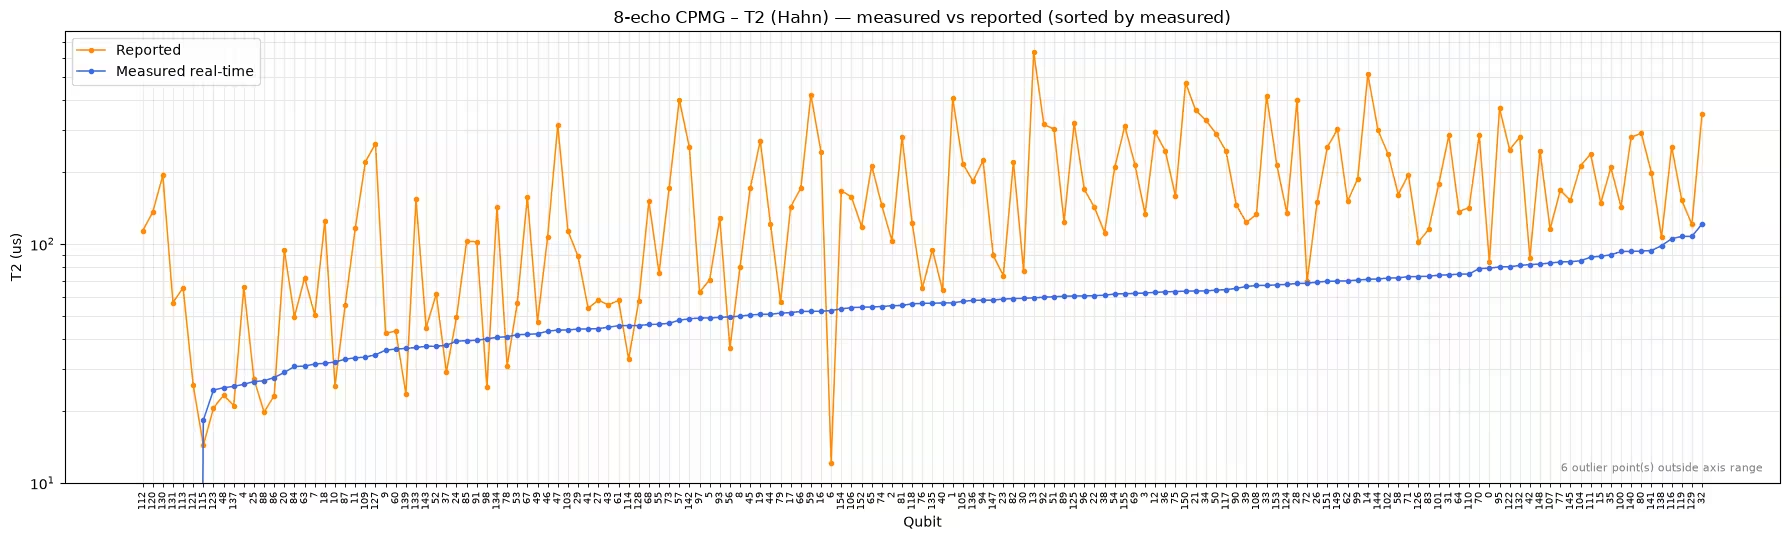
Median T2 — reported: 142 us | single echo: 53 us | 8-echo CPMG: 56 us
Nesta execução, os ecos extras mudaram pouco o resultado: a mediana de 8 ecos (56 µs) está próxima da de eco único (53 µs), e ambas permanecem bem abaixo da mediana informada (142 µs). O número de ecos sozinho não explica essa diferença; outras diferenças metodológicas estão envolvidas, como detalhes do procedimento de calibração, medir todos os qubits em paralelo em vez de isoladamente, e assim por diante.
A lição prática é tratar comparações de (e erro de dois qubits em camadas) entre metodologias com cuidado. Os valores atualizados são um instantâneo autoconsistente obtido em condições próximas a uma carga de trabalho real, o que os torna bastante adequados para comparar qubits entre si ou acompanhar um dispositivo ao longo do tempo. Uma diferença em relação aos dados de calibração informados, no entanto, não é automaticamente evidência de deriva.
Etapas 1-4 condensadas em uma única chamada
Para o uso do dia a dia, você raramente precisa dos resultados intermediários. O método run_and_update encadeia tudo o que você fez acima (construir, submeter, ajustar e atualizar) em uma única chamada que retorna o backend atualizado. Ele aceita a mesma lista experiments (e repassa opções como t2_num_echoes), e também pode ser envolvido em um contexto Batch ou Session.
A célula a seguir não retorna até que todos os jobs e o pós-processamento estejam concluídos.
# Initialize a fresh characterizer
characterizer = BackendCharacterization(backend)

# Run all of the experiments and update the backend in a single call
backend_updated = characterizer.run_and_update(experiments=experiments)
Building readout experiments
Building 1Q RB experiments
Building 2Q RB experiments
Building T1 experiments
Building T2 experiments
Layered two-qubit RB submitted: ['d9b7oqnu62qs738otat0', 'd9b7p76g26ic73dfjolg', 'd9b7pnm6hjac73ffb57g', 'd9b7q4fu62qs738otce0']
Readout job submitted: d9b7q4mg26ic73dfjprg
T1 experiment submitted: ['d9b7q57u62qs738otcfg']
T2 (Hahn) experiment submitted: ['d9b7q5m6hjac73ffb5pg']
Single-qubit RB submitted: ['d9b7r4e6hjac73ffb71g', 'd9b7reu6hjac73ffb7d0']
Updating readout error
Updating single-qubit X error
Updating single-qubit SX error
Updating two-qubit error
Updating T1
Updating T2
O objeto backend_updated atualizado está agora pronto para ser usado onde quer que as propriedades do backend alimentem seu fluxo de trabalho. Experimente esse processo em conjunto com o tutorial Benchmarking em tempo real para seleção de qubits para escolher os qubits com melhor desempenho ao transpilar um circuito. Como o dispositivo continua sofrendo deriva, atualize as propriedades próximo ao momento em que você realmente executa sua carga de trabalho.
Próximos passos
Se você achou este trabalho interessante, talvez se interesse pelo seguinte material:
- Use as propriedades atualizadas para escolher melhores qubits no tutorial Real-time benchmarking for qubit selection
- Aprenda como os dados de calibração informados são expostos no guia QPU information
- Explore os experimentos de caracterização individuais na documentação do Qiskit Experiments
- Navegue por mais benchmarks em nível de dispositivo no repositório Qiskit Device Benchmarking