Melhore valores esperados com a absorção de ruído propagado (PNA)
Estimativa de uso: 10 minutos em um processador Heron (NOTA: Isso é apenas uma estimativa. O tempo de execução pode variar.)
Resultados de aprendizagem
-
O que é a absorção de ruído propagado (PNA) e como ela mitiga o ruído de portas de dois qubits ao absorver canais de ruído inverso aprendidos no observável medido
-
Como usar o
samplomaticpara agrupar (box) e anotar camadas de circuito para twirling, mudanças de base e injeção de ruído -
Como aprender o ruído de camada com
[NoiseLearnerV3](/guides/directed-execution-model#noiselearnerv3) e propagá-lo em um observável de mitigação de ruído comqiskit-addon-pna -
Como amostrar circuitos aleatorizados com as classes
QuantumProgrameExecutoremqiskit-ibm-runtime, e combinar PNA com TREX e pós-seleção
Pré-requisitos
-
O fluxo de trabalho de padrões Qiskit
-
Uso da primitiva Estimator para calcular valores esperados de um observável
-
Técnicas de mitigação de erros, como Pauli twirling e TREX, abordadas em Combine opções de mitigação de erros com a primitiva Estimator
Contexto
Neste tutorial, demonstramos como aproveitar ferramentas avançadas de mitigação de erros no Qiskit para melhorar a estimativa de valores esperados em experimentos quânticos com ruído.
O que é a absorção de ruído propagado (PNA)?
A absorção de ruído propagado é uma técnica para mitigar erros de porta ao propagar o observável através do canal de ruído inverso que afeta as portas de dois qubits, resultando em um observável de mitigação de ruído.
Podemos usar a mitigação de erros quânticos para extrair valores esperados úteis de hardware quântico com ruído sem exigir tolerância a falhas completa. O PNA foca especificamente em absorver os efeitos do ruído no próprio observável, em vez de modificar as operações do circuito.
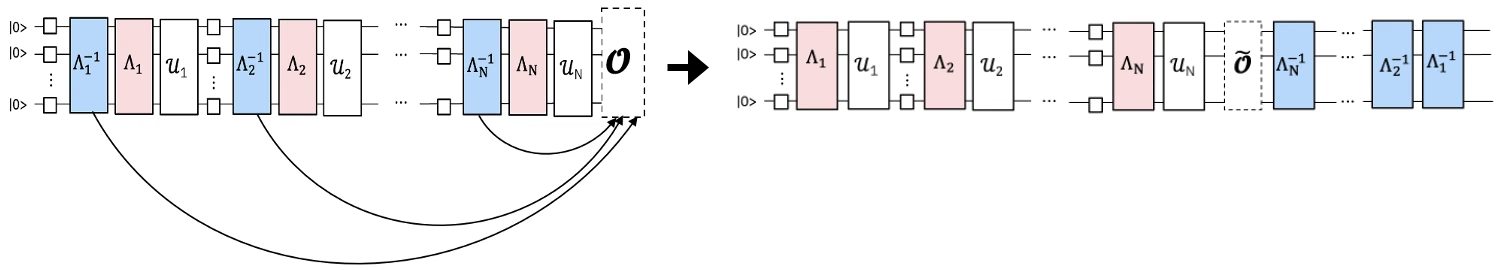
Cada porta com ruído em um circuito quântico pode ser modelada como uma porta ideal seguida por um canal de ruído. O PNA aprende ou caracteriza esses canais de ruído e define seus inversos. Em vez de inserir as operações inversas na execução do hardware (o que geralmente é inviável), o PNA propaga os canais de ruído inverso para frente através do circuito e os aplica ao observável. Esse processo transforma o observável em um novo operador , de forma que medir no circuito com ruído produza o mesmo valor esperado que medir em um circuito ideal, sem ruído.
Isso pode ser resumido como:
- Modele cada porta com ruído como uma operação ideal seguida por um canal de ruído .
- Aprenda ou estime cada usando ferramentas de caracterização de ruído.
- Defina e propague os mapas de ruído inverso para frente através do circuito usando técnicas de transferência de Pauli.
- Absorva esses inversos no observável, resultando em um operador mitigado por ruído .
Quando o ruído é descrito como um canal de Pauli (ou, de forma mais geral, como um canal esparso de Pauli-Lindblad), essa propagação pode ser realizada com eficiência usando a propagação de Pauli. A propagação de Pauli oferece uma estrutura para aproximar como os canais de ruído inverso se transformam ao passar por camadas de operações Clifford e não Clifford, controlando ao mesmo tempo a complexidade computacional.
Ao transferir a mitigação para o observável, o PNA evita a grande sobrecarga de amostragem que, de outra forma, resultaria da inserção de operações de correção física no circuito. Em vez disso, o circuito original com ruído é executado, enquanto o observável é transformado em um novo operador cujo valor esperado cancela os efeitos do ruído.
O fluxo de trabalho do PNA
O processo pode ser entendido por meio dos seguintes estágios conceituais. O primeiro esquema ilustra um experimento padrão com ruído.

Se aprendermos o modelo de ruído, podemos aplicar seu inverso e cancelar o ruído.

Em vez de implementar o canal de ruído inverso amostrando-o na QPU, como no cancelamento probabilístico de erros (PEC), aplicamos esse canal classicamente ao observável medido usando propagação de Pauli. O observável resultante mitiga efetivamente o ruído de porta aprendido quando medido.
Mitigação de erros modular com Samplomatic e Executor
A abordagem PNA se baseia em uma arquitetura modular de mitigação de erros no Qiskit. Essa arquitetura usa a biblioteca samplomatic junto com as classes QuantumProgram e Executor (adicionadas ao Qiskit Runtime na versão qiskit-ibm-runtime v0.47.0) para tornar técnicas como a absorção de ruído propagado e o Pauli twirling composáveis e reutilizáveis em diferentes experimentos.
Em vez de incorporar a lógica de mitigação dentro da própria definição do circuito, a mitigação é expressa de forma declarativa por meio de anotações samplomatic e gerenciada programaticamente pelo Executor, que controla como os circuitos aleatorizados são gerados, executados e pós-processados.
Neste tutorial, implementamos um padrão Qiskit para demonstrar como o PNA pode propagar canais de ruído de Pauli inverso e modificar o observável de acordo, para melhorar a estimativa de valores esperados em QPUs com ruído.
Visão geral do fluxo de trabalho
-
Etapa 1: Mapear para o problema quântico
- Construa um modelo de Ising kicked trotterizado espelhado e um observável-alvo.
-
Etapa 2: Caracterizar e propagar o ruído
-
Use
samplomaticpara identificar e anotar camadas exclusivas de dois qubits e medições no circuito. -
Aprenda o ruído que afeta cada camada exclusiva usando
NoiseLearnerV3. -
Mapeie cada anotação
InjectNoisepara seu modelo de ruído aprendido correspondente. -
Use
qiskit-addon-pnapara propagar os canais de ruído inverso para frente através do circuito e absorvê-los no observável-alvo.
-
-
Etapa 3: Executar experimentos quânticos
- Defina um
QuantumProgrampara especificar a amostragem aleatorizada por meio desamplexe execute os experimentos no backend usando oExecutor.
- Defina um
-
Etapa 4: Reconstruir e analisar resultados
- Compare estratégias de mitigação (PNA, PNA+TREX, PNA+PS, PNA+PS+TREX) e visualize a melhoria em relação aos resultados não mitigados.
Requisitos
Antes de iniciar este tutorial, certifique-se de ter os seguintes itens instalados:
-
Qiskit SDK v2.2 ou posterior, com suporte a visualização
-
Qiskit Runtime v0.47 ou posterior (
pip install qiskit-ibm-runtime) -
Samplomatic v0.13 ou posterior (
pip install samplomatic) -
Addon PNA do Qiskit (
pip install qiskit-addon-pna) -
Utilitários de addon do Qiskit (
pip install qiskit-addon-utils)
Configuração
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "qiskit": "qiskit", "qiskit_addon_pna": "qiskit-addon-pna", "qiskit_addon_utils": "qiskit-addon-utils", "qiskit_ibm_runtime": "qiskit-ibm-runtime", "samplomatic": "samplomatic"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit import QuantumCircuit
from qiskit.quantum_info import Pauli, SparsePauliOp
from qiskit.transpiler import generate_preset_pass_manager, PassManager
from qiskit_ibm_runtime import (
    QiskitRuntimeService,
    QuantumProgram,
    Executor,
    NoiseLearnerV3,
)
from qiskit_addon_utils.exp_vals.measurement_bases import (
    get_measurement_bases,
)
from qiskit_addon_utils.exp_vals.expectation_values import (
    executor_expectation_values,
)
from qiskit_addon_utils.noise_management import trex_factors
from qiskit_addon_utils.noise_management.post_selection import PostSelector
from qiskit_addon_utils.noise_management.post_selection.transpiler.passes import (
    AddPostSelectionMeasures,
    AddSpectatorMeasures,
)
from qiskit_addon_pna import generate_noise_mitigating_observable
import samplomatic
from samplomatic.transpiler import generate_boxing_pass_manager
from samplomatic.annotations import InjectNoise
from samplomatic.utils import get_annotation, find_unique_box_instructions
import numpy as np
import matplotlib.pyplot as plt

# Selects a connected chain of low-error qubits on the target backend.
# The mirrored kicked-Ising circuit is a 1D chain, so we only need a line
# of connected physical qubits; the helper walks the backend's coupling map
# and grows a chain along the lowest-error two-qubit edges, so it works for
# any backend rather than relying on a hardcoded layout.
def find_qubit_chain(backend, length):
    """Find a connected chain of ``length`` physical qubits on ``backend``.

    The chain is grown greedily along the lowest-error two-qubit edges, so it
    favors better-performing qubits. Because the mirrored kicked-Ising circuit
    is a 1D chain, a connected line is all we need.
    """
    target = backend.target

    # Identify the native two-qubit gate and build a per-edge error lookup.
    two_qubit_gate = next(
        name
        for name in target.operation_names
        if target[name]
        and all(q is not None and len(q) == 2 for q in target[name])
    )
    edge_error = {
        frozenset(qargs): (
            1.0 if props is None or props.error is None else props.error
        )
        for qargs, props in target[two_qubit_gate].items()
    }

    graph = backend.coupling_map.graph.to_undirected(multigraph=False)
    neighbors = {n: list(graph.neighbors(n)) for n in graph.node_indices()}

    def first_chain_from(start):
        path, visited = [start], {start}

        def grow():
            if len(path) == length:
                return True
            node = path[-1]
            order = sorted(
                neighbors[node],
                key=lambda m: edge_error.get(frozenset((node, m)), 1.0),
            )
            for nxt in order:
                if nxt not in visited:
                    visited.add(nxt)
                    path.append(nxt)
                    if grow():
                        return True
                    path.pop()
                    visited.remove(nxt)
            return False

        return path if grow() else None

    def chain_cost(path):
        return sum(
            edge_error.get(frozenset((path[i], path[i + 1])), 1.0)
            for i in range(len(path) - 1)
        )

    # Try low-degree qubits first (the natural ends of long chains) and keep
    # the lowest-error chain found.
    best_path, best_cost = None, float("inf")
    for start in sorted(neighbors, key=lambda n: len(neighbors[n])):
        chain = first_chain_from(start)
        if chain is not None and (cost := chain_cost(chain)) < best_cost:
            best_path, best_cost = chain, cost

    if best_path is None:
        raise ValueError(
            f"Could not find a connected chain of {length} qubits "
            f"on '{backend.name}'."
        )
    return best_path
Exemplo de simulador em pequena escala
O PNA mitiga o ruído físico de portas de dois qubits de um processador quântico específico. O fluxo de trabalho depende de dois serviços de hardware que não têm um análogo significativo em um simulador ideal:
-
O
NoiseLearnerV3caracteriza experimentalmente o canal de ruído esparso de Pauli-Lindblad associado a cada camada exclusiva de dois qubits do circuito transpilado. Em um simulador sem ruído, não há ruído a aprender, e o canal inverso propagado seria a identidade. -
A primitiva
Executoramostra os circuitos twirled e aleatorizados gerados pelosamplomaticem um backend.
Em princípio, você poderia substituir por um modelo de ruído sintético. Por exemplo, você poderia anexar instruções PauliLindbladError com o Qiskit Aer e passar o circuito com ruído resultante diretamente para generate_noise_mitigating_observable. No entanto, isso apenas valida a contabilidade clássica em relação ao ruído que você mesmo injetou, e obscurece o objetivo da técnica. Por esse motivo, pulamos o exemplo do simulador e demonstramos o fluxo de trabalho completo do PNA diretamente em hardware, com cada etapa do padrão Qiskit detalhada abaixo.
Exemplo de hardware em grande escala
Agora executamos o fluxo de trabalho completo do PNA em um modelo de Ising kicked de 30 sítios, executado em hardware IBM Quantum®, seguindo as quatro etapas de um padrão Qiskit.
Etapa 1: Mapear para um problema quântico
Gerar o circuito de Trotter espelhado e o observável
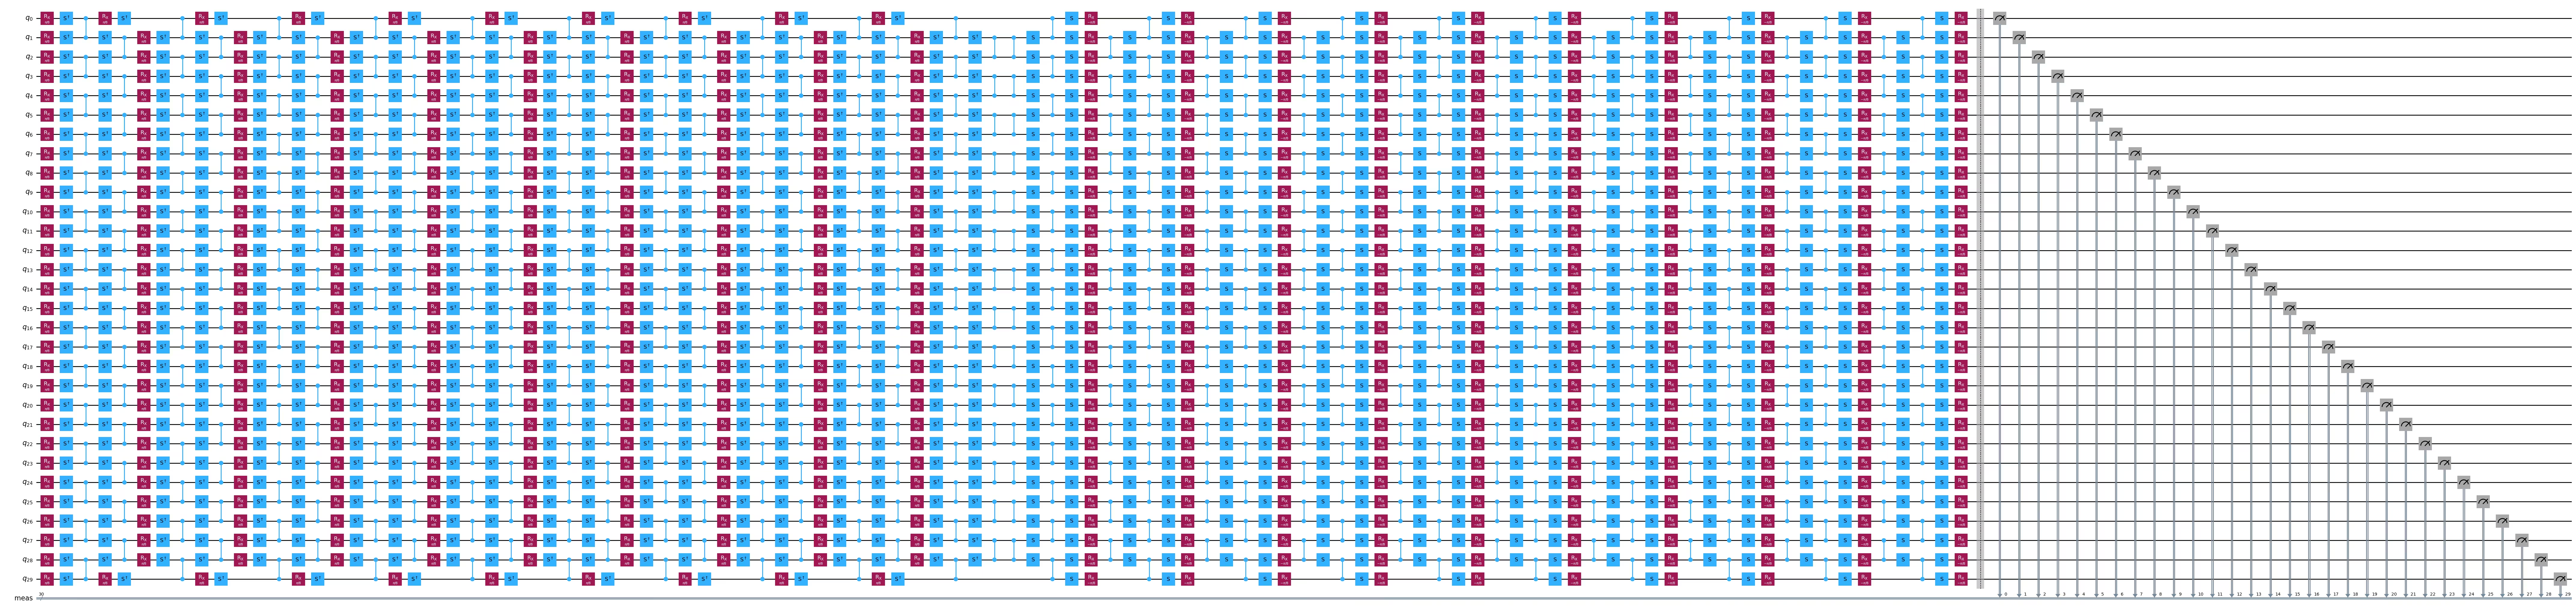
Para este experimento, estudaremos a dinâmica temporal de um modelo de Ising kicked de 30 sítios em uma cadeia de spins 1D. O Hamiltoniano considerado é:
,
onde descreve o acoplamento de spins vizinhos mais próximos, , e o campo transversal global, , é definido como . Quanto mais distante estiver de um ângulo Clifford (ou seja, ), mais difícil se torna propagar os geradores de anti-ruído através do circuito.
Para a escolha do observável, consideraremos a magnetização média por sítio, , onde é o número de sítios.
num_qubits = 30
num_trotter_steps = 10
rx_angle = np.pi / 8

# Avg single-site magnetization
id_pauli = Pauli("I" * num_qubits)
observable = (
    SparsePauliOp([id_pauli.dot(Pauli("Z"), [i]) for i in range(num_qubits)])
    / num_qubits
)

# Implement Trotterized kicked-Ising model
circuit = QuantumCircuit(num_qubits)
for _step in range(num_trotter_steps):
    circuit.rx(rx_angle, range(num_qubits))
    for first_qubit in (1, 2):
        for idx in range(first_qubit, num_qubits, 2):
            # equivalent to Rzz(-pi/2):
            circuit.sdg([idx - 1, idx])
            circuit.cz(idx - 1, idx)
# Append the inverse circuit to complete the mirroring
circuit.compose(circuit.inverse(), inplace=True)
circuit.measure_active()
circuit.draw("mpl", fold=-1)
Etapa 2: Otimizar o problema para execução em hardware
O próximo passo é preparar nosso circuito de Trotter espelhado para execução em hardware IBM Quantum real. Executar em uma QPU exige mais do que simplesmente construir o circuito abstrato, pois precisamos otimizá-lo para que:
-
Ele respeite o conjunto de portas nativas e a conectividade do backend. A transpilação mapeia o circuito lógico em um circuito ISA suportado pelo backend-alvo. Isso garante que cada porta e interação entre qubits seja fisicamente realizável.
-
Possamos caracterizar o ruído no nível das camadas do circuito. O PNA depende do aprendizado e da propagação de canais de ruído inverso. Para fazer isso com eficiência, dividimos o circuito transpilado em camadas exclusivas de dois qubits "encaixotadas" (boxed). Essas caixas nos permitem associar cada camada do circuito ao seu próprio modelo de ruído aprendido.
-
Possamos alimentar o PNA com modelos de ruído realistas. Depois que o circuito é encaixotado, usamos o serviço
NoiseLearnerV3para aprender experimentalmente os canais de ruído de Pauli que afetam cada camada exclusiva de dois qubits. Esses modelos aprendidos são então vinculados de volta ao circuito por meio das anotações do Samplomatic.
No geral, essa etapa preenche a lacuna entre um circuito espelhado idealizado e um circuito pronto para hardware com modelos de ruído aprendidos. Com essa configuração, o PNA pode propagar canais de ruído inverso através do circuito e ajustar o observável de acordo.
Conecte-se ao backend e transpile para um circuito ISA
Primeiro inicializamos o IBM Quantum Compute Service e selecionamos um backend. Autentique-se com sua própria conta seguindo as instruções para salvar suas credenciais, após o que QiskitRuntimeService() as capturará automaticamente.
# Initialize IBM Quantum Compute Service using your saved credentials
service = QiskitRuntimeService()

backend = service.least_busy(
    operational=True, simulator=False, min_num_qubits=num_qubits
)
# Re-fetch with fractional gates enabled (least_busy does not forward this)
# Fractional gates are enabled so the non-Clifford Rx rotations are supported natively.
backend = service.backend(backend.name, use_fractional_gates=True)
print(f"Selected backend: {backend.name}")
Selected backend: ibm_fez
Em seguida, escolhemos uma cadeia conectada de qubits no backend e transpilamos o circuito para ela.
Usando o auxiliar find_qubit_chain definido na seção de Configuração, selecionamos uma linha de num_qubits qubits físicos conectados. Em seguida, transpilamos com optimization_level=0 e fixamos essa cadeia como o initial_layout, o que preserva exatamente a estrutura de camadas de portas de dois qubits do circuito espelhado. É dessa estrutura que dependem as etapas de encaixotamento e aprendizado de ruído, então um nível de otimização mais alto (que cancelaria as portas espelhadas) deve ser evitado aqui.
# Find a connected, low-error chain of qubits on the chosen backend
layout = find_qubit_chain(backend, num_qubits)

# Transpile the circuit for the target backend, pinning the chain as the layout.
# optimization_level=0 preserves the mirrored two-qubit-gate layers that the
# boxing and noise-learning steps rely on.
pm = generate_preset_pass_manager(
    backend=backend, optimization_level=0, initial_layout=layout
)
isa_circuit = pm.run(circuit)
isa_observable = observable.apply_layout(isa_circuit.layout)
isa_circuit.draw("mpl", fold=-1)
Twirl das camadas de portas de dois qubits e medições, e localização de camadas exclusivas
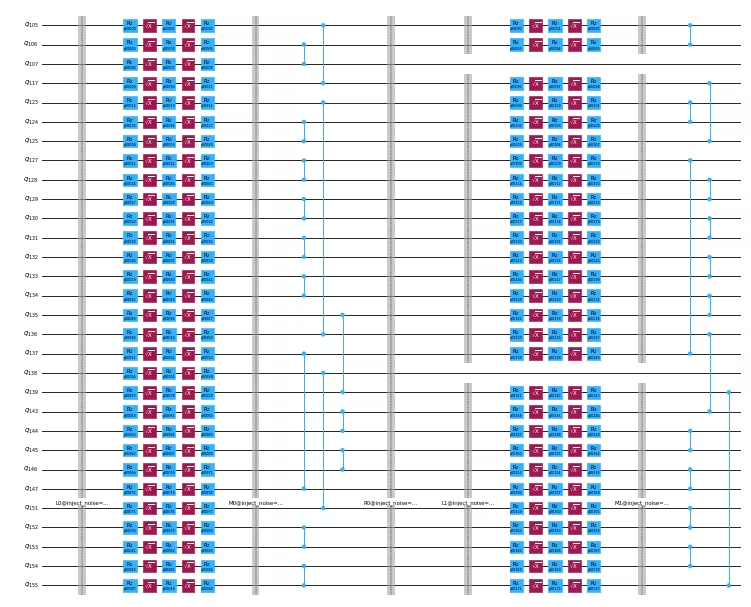
Usamos samplomatic para encaixotar o circuito e identificar camadas exclusivas de dois qubits. Uma caixa (box) é uma construção que agrupa instruções para que intenções ou anotações específicas possam depois ser aplicadas uniformemente a todas as portas dentro da mesma caixa.
Aqui, chamamos o método generate_boxing_pass_manager, que vai além de simplesmente identificar camadas de dois qubits. Ele realiza várias tarefas importantes:
-
Agrupa todas as camadas de dois qubits no circuito,
-
Aplica as anotações
TwirleChangeBasisa essas camadas, -
Agrupa operações de medição em suas próprias seções encaixotadas, e
-
Aplica a anotação
InjectNoisea cada camada de dois qubits.
Essas anotações definem como o ruído, as mudanças de base e o twirling são tratados em todo o circuito. Elas também estabelecem a estrutura usada posteriormente para aprender e mitigar o ruído.
As principais opções de configuração são:
-
enable_gates/enable_measures: True: Encaixota todas as camadas de portas de dois qubits e as medições finais. Portas de um qubit são absorvidas à esquerda ("left-dressed") dentro das caixas. -
measure_annotations: all: Inclui as anotaçõesTwirleChangeBasisna caixa de medição. -
twirling_strategy: active: Aplica twirl a todos os qubits ativos em cada caixa que contém portas de emaranhamento. -
inject_noise_targets: gates: Adiciona anotaçõesInjectNoisea todas as caixas anotadas comTwirlque contêm portas de emaranhamento. -
inject_noise_strategy: uniform_modification: Escala todas as camadas de ruído de forma equivalente em todo o circuito.
# Box up circuit with Twirl and InjectNoise annotations
pm = generate_boxing_pass_manager(
    enable_gates=True,
    enable_measures=True,
    measure_annotations="all",
    twirling_strategy="active",
    inject_noise_targets="gates",
    inject_noise_strategy="uniform_modification",
)
boxed_circuit = pm.run(isa_circuit)
draw_circ = QuantumCircuit(boxed_circuit.num_qubits)
draw_circ.append(boxed_circuit.data[0], qargs=boxed_circuit.data[0].qubits)
draw_circ.append(boxed_circuit.data[1], qargs=boxed_circuit.data[1].qubits)
draw_circ.draw("mpl", fold=-1, scale=0.3, idle_wires=False)

Gere o circuito de modelo (template) e o samplex, que definem como o circuito será amostrado.
Aqui também adicionamos medições espectadoras e de pós-seleção, necessárias para realizar a pós-seleção nas amostras produzidas pelo Executor.
# Build template circuit and samplex for later use with the "Executor"
template_circuit, samplex = samplomatic.build(boxed_circuit)

# Add post-selection instructions to the template circuit
post_selection_pm = PassManager(
    [
        AddSpectatorMeasures(backend.coupling_map),
        AddPostSelectionMeasures(x_pulse_type="rx"),
    ]
)
template_circuit = post_selection_pm.run(template_circuit)
draw_circ = template_circuit.copy_empty_like()
draw_circ.data = template_circuit.data[:324]
draw_circ.draw("mpl", fold=-1, scale=0.3, idle_wires=False)
Aprenda o ruído usando NoiseLearnerV3
Antes de podermos aplicar o PNA para mitigação de erros, primeiro precisamos caracterizar o ruído que atua em cada camada exclusiva de dois qubits e na camada de medição do nosso circuito. Para isso, usamos o programa NoiseLearnerV3 para aprender experimentalmente modelos de ruído para cada camada identificada anteriormente. O learner realiza experimentos no estilo de benchmarking que estimam o canal de ruído que afeta cada camada e retorna um objeto de resultado contendo o modelo aprendido.
Começamos identificando as camadas exclusivas em nosso circuito usando find_unique_box_instructions de samplomatic. Isso garante que aprendamos o ruído apenas uma vez por tipo distinto de camada, minimizando o número de experimentos e o custo total de shots. A lista resultante de camadas é passada ao noise learner.
Existem alguns parâmetros-chave que controlam como o ruído é aprendido:
-
num_randomizations: Número de circuitos aleatórios usados por configuração de aprendizado. -
shots_per_randomization: Número de shots realizados por circuito de aprendizado aleatório. -
layer_pair_depths: As profundidades de circuito (medidas em número de pares) a serem usadas nos experimentos de aprendizado. -
post_selection: Habilita a pós-seleção baseada em arestas usando portasrxpara aplicar pulsos pós-medição.
# Noise learning parameters
num_randomizations_nl = 64
shots_per_randomization_nl = 128

# Match the deepest noise-learning depth to the depth of the circuit being
# mitigated. ``layer_pair_depths`` are measured in layer pairs (a layer + its
# inverse), so the deepest value is half the circuits's two-qubit-layer depth.
# Learning to this depth improves the quality of the mitigation.

depth_2q = isa_circuit.depth(lambda instr: instr.operation.num_qubits == 2)
max_layer_pair_depth = depth_2q // 2

# Use a fixed schedule of learning depths, but drop any that exceed the circuit's
# depth and always cap the deepest value at ``max_layer_pair_depth`` so we never
# learn deeper than the circuit being mitigated
candidate_depths = [1, 2, 4, 8, 12, 16, 24, 32, 40, 48]
layer_pair_depths = sorted(
    {d for d in candidate_depths if d < max_layer_pair_depth}
    | {max_layer_pair_depth}
)

# Find the unique instructions (layers) from the boxed-up circuit
unique_2q_layers_and_meas = find_unique_box_instructions(
    boxed_circuit, normalize_annotations=None, undress_boxes=True
)

# Configure and run the noise learner on the unique layers.
# Options can be passed directly as a dictionary.
noise_learner_options = {
    "num_randomizations": num_randomizations_nl,
    "shots_per_randomization": shots_per_randomization_nl,
    "layer_pair_depths": layer_pair_depths,
    "post_selection": {
        "enable": True,
        "strategy": "edge",
        "x_pulse_type": "rx",
    },
    "environment": {"job_tags": ["TUT_PNA"]},
}

noise_learner = NoiseLearnerV3(backend, noise_learner_options)
noise_learner_job = noise_learner.run(unique_2q_layers_and_meas)
noise_learner_result = noise_learner_job.result()
Visualize as taxas de ruído aprendidas
Depois de aprender os modelos de ruído, podemos inspecionar a distribuição das taxas de erro inferidas para operações de um e de dois qubits. O código abaixo extrai as representações de Pauli-Lindblad dos resultados de ruído aprendidos e coleta as taxas de ruído correspondentes.
Para cada camada aprendida:
- Convertemos o modelo de ruído em uma lista esparsa de tuplas
(pstr, qubits, rate), ondepstré a string de Pauli que atua nos qubits dados erateé a taxa de erro associada. - Separamos as taxas em termos de um qubit (
len(pstr) == 1) e de dois qubits (len(pstr) == 2). - As listas de taxas são então ordenadas, e seus valores medianos são calculados.
Plotamos as distribuições de taxas de ruído de um qubit (vermelho) e de dois qubits (azul) em escala logarítmica, com seus valores medianos marcados por linhas verticais, para que possamos comparar as magnitudes relativas dos geradores de Pauli-Lindblad aprendidos. A ordenação das taxas de um e dois qubits depende do dispositivo e das camadas específicas sendo caracterizadas; nesta execução, os geradores de um qubit (peso 1) apresentam a maior taxa mediana.
hw_rates_1q = []
hw_rates_2q = []
for nlr in noise_learner_result[:2]:
    plm_list = nlr.to_pauli_lindblad_map().to_sparse_list()
    hw_rates_1q += [
        rate for (pstr, qubits, rate) in plm_list if len(pstr) == 1
    ]
    hw_rates_2q += [
        rate for (pstr, qubits, rate) in plm_list if len(pstr) == 2
    ]
hw_rates_1q = sorted(hw_rates_1q)
hw_rates_2q = sorted(hw_rates_2q)
median_1q = hw_rates_1q[len(hw_rates_1q) // 2]
median_2q = hw_rates_2q[len(hw_rates_2q) // 2]
fig, ax = plt.subplots(1, 1, figsize=(14, 5))
ax.scatter(
    (hw_rates_1q),
    [(i) / (len(hw_rates_1q) - 1) for i in range(len(hw_rates_1q))],
    color="red",
    label="1q rates",
)
ax.set_xscale("log")
ax.set_ylim(0, 1.1)
ax.vlines(median_1q, 0, 1, color="red")
ax.text(median_1q * 1.1, 0.1, f"{median_1q:.2e}")
ax.scatter(
    (hw_rates_2q),
    [(i) / (len(hw_rates_2q) - 1) for i in range(len(hw_rates_2q))],
    color="blue",
    label="2q rates",
)
ax.set_xscale("log")
ax.set_ylim(0, 1.1)
ax.vlines(median_2q, 0, 1, color="blue")
ax.text(median_2q * 1.1, 0.2, f"{median_2q:.2e}")
ax.set_title("Learned noise rates")
ax.set_xlabel("Noise rate")
ax.set_yticks([])
plt.legend()
<matplotlib.legend.Legend at 0x125336120>

Associe as caixas do circuito ao ruído aprendido
Depois de obtermos modelos de ruído para cada camada exclusiva de dois qubits, precisamos vinculá-los às anotações InjectNoise correspondentes dentro do circuito encaixotado.
A diretiva InjectNoise é uma anotação samplomatic que usa os dressers de um qubit para injetar ruído no circuito de forma controlada e configurável. Ela permite a modelagem modular de ruído em diferentes camadas.
Cada anotação InjectNoise inclui:
InjectNoise.ref- um identificador exclusivo para a anotação. Ele é usado pelo objetosamplexpara atribuir corretamente o modelo de ruído correspondente.InjectNoise.modifier_ref(opcional) - uma referência secundária que permite escalar o modelo de ruído atribuído por um fator multiplicativo.
Nesta etapa, construímos um mapeamento de cada InjectNoise.ref para seu modelo de ruído aprendido correspondente (PauliLindbladMap). Esse mapeamento garante que cada camada de porta de emaranhamento no circuito seja pareada com o modelo de ruído apropriado, para que os efeitos do ruído sejam aplicados com precisão durante a amostragem e as etapas subsequentes de mitigação de ruído.
# map inject noise refs to pauli lindblad maps
refs_to_noise_models = {}
for instruction, result in zip(
    unique_2q_layers_and_meas, noise_learner_result, strict=False
):
    if inject_noise_annot := get_annotation(
        instruction.operation, InjectNoise
    ):
        refs_to_noise_models[inject_noise_annot.ref] = (
            result.to_pauli_lindblad_map()
        )
Propague o observável através do anti-ruído aprendido
Como discutido acima, isso é feito em duas etapas. Primeiro, propagamos um gerador de anti-ruído até o final do circuito. Depois disso, propagamos o observável através desse gerador evoluído. Esse processo é repetido para cada gerador de anti-ruído no circuito. Nesta implementação, cada gerador em uma determinada camada é propagado até o final do circuito em paralelo. Além disso, o multiprocessamento do Python é usado para realizar tanto a propagação para frente do anti-ruído quanto a retropropagação do observável em paralelo. Isso evita um acúmulo de geradores evoluídos na memória e também maximiza os recursos computacionais.
Ao executar o PNA, você sempre precisa fornecer um circuito com ruído e um observável. Se o seu circuito com ruído for um circuito encaixotado com anotações InjectNoise, você precisa fornecer o mapeamento que criamos na etapa acima. Também é possível passar um circuito não encaixotado contendo instruções PauliLindbladError de qiskit-aer. Nesse caso, refs_to_noise_models não precisa ser fornecido. Além das entradas principais, considere também o seguinte:
-
max_err_terms: O número de termos a manter em cada gerador de anti-ruído à medida que é propagado para frente. Permitir que esse valor seja maior geralmente aumenta a precisão, mas esse comportamento não tem garantia de ser monotônico. -
max_obs_terms: O número de termos a manter no observável de mitigação de ruído, , à medida que é retropropagado através do anti-ruído evoluído. Valores maiores geralmente aumentam a precisão, mas não há garantia de que isso ocorra de forma monotônica. -
num_processes: O número de núcleos dedicados ao processo. Lembre-se de que os geradores são propagados para frente e aplicados ao observável em paralelo. -
search_step: A etapa de retropropagação usa um método guloso (greedy) para conjugar aproximadamente dois operadores na base de Pauli. Esse método pode ser acelerado aumentandosearch_step. Consulte a documentação dopauli-proppara mais informações. -
num_to_measure: Embora essa variável não seja uma entrada degenerate_noise_mitigating_observable, nós a usamos para controlar quantos termos de realmente queremos medir. Aqui medimos apenas os 30 termos principais, que são os termos originais do nosso observável. Os termos agora foram reescalonados de forma que medi-los tenha o efeito de mitigar o ruído de porta aprendido. Embora meçamos apenas 30 termos de , muitas vezes ainda é útil permitir que ele cresça, pois isso aumenta a precisão dos fatores de escala dos termos principais.
# PNA parameters
num_processes = 8
max_err_terms = 10_000
max_obs_terms = 10_000
num_to_measure = num_qubits

obs_tilde_isa = generate_noise_mitigating_observable(
    boxed_circuit,
    isa_observable,
    refs_to_noise_models,
    max_err_terms=max_err_terms,
    max_obs_terms=max_obs_terms,
    num_processes=num_processes,
    print_progress=True,
    search_step=8,
)
p_2_v = {p: v for v, p in enumerate(layout)}
obs_tilde_virtual = SparsePauliOp.from_sparse_list(
    [
        (pstr, [p_2_v[p] for p in p_qubits], coeff)
        for (pstr, p_qubits, coeff) in obs_tilde_isa.to_sparse_list()
    ],
    num_qubits=num_qubits,
)
obs_tilde_virtual = obs_tilde_virtual[
    np.argsort(np.abs(obs_tilde_virtual.coeffs))[::-1]
][:num_to_measure]
Finished! 13740 / 13740 generators propagated.
obs_tilde_isa = obs_tilde_isa[np.argsort(np.abs(obs_tilde_isa.coeffs))][::-1]
plt.xscale("log")
plt.yscale("log")
plt.title(r"$\tilde{O}$ coeff magnitudes")
plt.ylabel("Magnitude")
plt.xlabel("Pauli term index")
plt.plot(np.abs(obs_tilde_isa.coeffs), ".")
[<matplotlib.lines.Line2D at 0x124b0a120>]

Transforme as bases de medição para a forma canônica
Em seguida, encontramos um conjunto mínimo de bases a medir de forma que possamos cobrir totalmente cada termo de Pauli no observável medido (muitos observáveis podem ser medidos simultaneamente se comutarem qubit a qubit). Como estamos medindo apenas os termos do nosso observável original, que é a soma de todos os Paulis de Z único, é necessária apenas uma base: a base all-Z.
Além de encontrar um conjunto de bases de medição de Pauli, precisamos mapear esses termos de Pauli para a forma canônica esperada pelo Executor. Para mais informações sobre a ordenação canônica de qubits, visite a documentação do Samplomatic.
meas_box = boxed_circuit.data[-1]
canonical_qubits = [
    idx
    for idx, qubit in enumerate(boxed_circuit.qubits)
    if qubit in meas_box.qubits
]
c_2_p = {
    c: p for c, p in enumerate(canonical_qubits)
}  # canonical -> physical
p_2_v = {p: v for v, p in enumerate(layout)}  # physical -> virtual
c_2_v = {c: p_2_v[p] for c, p in c_2_p.items()}  # canonical -> virtual
meas_bases, bases_reverser = get_measurement_bases(obs_tilde_virtual)
meas_bases_canonical = [
    np.array([base[c_2_v[c]] for c in range(num_qubits)], dtype=np.uint8)
    for base in meas_bases
]
Etapa 3: Executar experimentos quânticos
Especifique como amostrar no QuantumProgram
Agora configuramos o QuantumProgram, que serve como o contêiner central para todos os circuitos e configurações de amostragem que serão executados pelo Executor. Esse objeto define como as instâncias de circuito aleatorizadas são geradas, agrupadas em lotes e executadas para produzir os resultados de medição usados no PNA.
Um QuantumProgram pode conter vários itens, cada um consistindo em um circuito de modelo (template) e um objeto samplex correspondente que define como as aleatorizações são aplicadas. Essa abstração permite que o Executor trate todo o fluxo de trabalho como um único programa modular — desde a geração de circuitos aleatorizados até a coleta e agregação de shots.
Nesta etapa, criamos um QuantumProgram que executa nosso experimento PNA usando o circuito de modelo e o samplex que construímos anteriormente. A configuração inclui os seguintes elementos:
-
template_circuit: O circuito contendo todas as portas necessárias para implementar todas as aleatorizações desejadas (a partir de aleatorizações de twirling, parâmetros e assim por diante). -
samplex: Um objeto que define uma distribuição de probabilidade sobre todas as possíveis aleatorizações de circuito das quais amostrar. -
samplex_arguments: Bindings necessários para definir completamente osamplex-
basis_changes: Aqui é onde especificamos um conjunto de bases para medir que cobrirá todos os termos de Pauli no observável medido. -
noise_scales.ref: Definimos a escala de cada camada de ruído para0.0para evitar que qualquer ruído adicional seja injetado em nossas amostras. -
pauli_lindblad_maps: Necessário senoise_scalesfor passado. Isso simplesmente mapeia camadas de ruído para o modelo de ruído associado.
-
-
shape: Uma tupla de forma para estender a forma implícita definida porsamplex_arguments. Eixos não triviais introduzidos por essa extensão enumeram randomizações.
# Control the # of shots during execution
shots_per_randomization_exec = 64
num_randomizations_exec = 6144

# Zero out the noise to prevent noise from being injected during execution.
# We only added InjectNoise annotations so PNA could associate the noise
# to layers in the circuit
samplex_inputs = {f"noise_scales.{ref}": 0.0 for ref in refs_to_noise_models}
samplex_inputs |= {"pauli_lindblad_maps": refs_to_noise_models}

# Specify the bases to measure. The samplex exposes one basis-change input per
# ChangeBasis-annotated box; here a single all-Z basis covers every term. We
# look up the basis-change interface name rather than hardcoding an index, since
# the name depends on the circuit's box structure.
bases_broadcastable = np.expand_dims(np.array(meas_bases_canonical), axis=1)
samplex_inputs |= {
    spec.name: bases_broadcastable
    for spec in samplex.inputs().get_specs(r"^basis_changes\.")
}

# Convert samplex_inputs into a dict to pass to QuantumProgram
samplex_arguments = (
    samplex.inputs().make_broadcastable().bind(**samplex_inputs)
)

# Instantiate the QuantumProgram with the specified parameters
program = QuantumProgram(shots=shots_per_randomization_exec)
program.append_samplex_item(
    circuit=template_circuit,
    samplex=samplex,
    samplex_arguments=samplex_arguments,
    shape=(num_randomizations_exec,),
)
Amostre o circuito usando o Executor
Agora que definimos nosso QuantumProgram, executar o experimento é simples. Simplesmente instanciamos o objeto Executor, fornecemos a ele o backend e executamos o programa.
# Execute (sample) the circuit
executor = Executor(backend)
job_exec = executor.run(program)
exec_results = job_exec.result()
Etapa 4: Reconstruir e analisar resultados
Para calcular um valor esperado com mitigação de erro, fazemos o seguinte:
-
Calcular os fatores de escala TREX com base no ruído aprendido que afeta as medições,
-
Gerar uma máscara para manter apenas amostras pós-selecionadas, e
-
Usar a função
executor_expectation_valuesdeqiskit-addon-utilspara combinar todos os dados em um valor esperado com mitigação de erro.
# Computing the TREX factors
measurement_noise_map = noise_learner_result[2].to_pauli_lindblad_map()
trex_rescale_factors = trex_factors(measurement_noise_map, bases_reverser)

# Post-select the results
post_selector = PostSelector.from_circuit(
    circuit=template_circuit, coupling_map=backend.coupling_map
)

# Compute the ps mask for filtering results
mask = post_selector.compute_mask(exec_results[0], strategy="edge")

# Compute expvals using post selected results
results = executor_expectation_values(
    exec_results[0]["meas"],
    bases_reverser,
    meas_basis_axis=0,
    avg_axis=1,
    measurement_flips=exec_results[0]["measurement_flips.meas"],
    pauli_signs=exec_results[0].get("pauli_signs", None),
    postselect_mask=mask,
    rescale_factors=trex_rescale_factors,
)
Comparar estratégias de mitigação: PNA, PNA+TREX, PNA+PS, PNA+PS+TREX
Calculamos e visualizamos valores esperados para várias variantes de mitigação usando os resultados do Executor.
bases_reverser_unmit = {Pauli("Z" * num_qubits): [observable]}
args = [
    (bases_reverser_unmit, None, None),
    (bases_reverser, None, None),
    (bases_reverser, None, trex_rescale_factors),
    (bases_reverser, mask, None),
    (bases_reverser, mask, trex_rescale_factors),
]

evs = []
for reverser, postsel_mask, factors in args:
    # Compute expvals using post selected results
    res_ps = executor_expectation_values(
        exec_results[0]["meas"],
        reverser,
        meas_basis_axis=0,
        avg_axis=1,
        measurement_flips=exec_results[0]["measurement_flips.meas"],
        pauli_signs=exec_results[0].get("pauli_signs", None),
        postselect_mask=postsel_mask,
        rescale_factors=factors,
    )
    res_ps = np.array(res_ps)
    evs.append(res_ps[:, 0][0])

experiments = ["PNA", "PNA+TREX", "PNA+PS", "PNA+PS+TREX"]
colors = ["#d9d9d9", "#b0b0b0", "#7f7f7f", "#4c4c4c"]
plt.bar(experiments, evs[1:], color=colors)
plt.axhline(y=1, color="green", linestyle="--", linewidth=2, label="Ideal")
plt.axhline(
    y=evs[0], color="red", linestyle="--", linewidth=2, label="Unmitigated"
)
plt.ylabel("Expectation value", fontsize=14)

plt.title(
    r"30q Mirrored Ising, 10 Trotter steps, $\theta_{rx}=\frac{\pi}{8}$",
    fontsize=14,
)
plt.legend(loc="upper left", bbox_to_anchor=(1.05, 1), borderaxespad=0.0)
plt.xticks(rotation=45)
plt.tight_layout()
plt.show()

Os resultados demonstram os benefícios cumulativos de combinar diferentes técnicas de mitigação de erro. A abordagem PNA simples já restaura o valor esperado próximo ao benchmark ideal, indicando que propagar canais de ruído inverso para o observável compensa efetivamente os erros de porta de dois qubits.
-
Adicionar a reponderação TREX (PNA+TREX) melhora ligeiramente a estimativa ao corrigir o desequilíbrio de amostragem nos circuitos aleatorizados.
-
A pós-seleção (PNA+PS) proporciona um impulso mais perceptível ao filtrar resultados de medição inconsistentes que provavelmente resultam de erros residuais.
-
Finalmente, combinar ambos (PNA+PS+TREX) produz o resultado mais preciso, quase igualando o valor ideal, mostrando como essas estratégias de mitigação se reforçam mutuamente.
No geral, a comparação destaca que o PNA serve como uma base robusta para a estimativa de valor esperado ciente do ruído, enquanto o TREX e a pós-seleção oferecem refinamentos complementares para ganhos adicionais de precisão.
Próximos passos
Se você achou este trabalho interessante, pode se interessar pelo seguinte material: