Fórmulas de múltiplos produtos para reduzir o erro de Trotter
Uso estimado: Quatro minutos em um processador Heron r2 (NOTA: Esta é apenas uma estimativa. O tempo de execução real pode variar.)
Resultados de aprendizado
-
Como as fórmulas de múltiplos produtos (MPFs) reduzem o erro de Trotter na simulação Hamiltoniana ao combinar valores esperados de vários circuitos rasos
-
Quando as MPFs são benéficas em relação às fórmulas de produto padrão e quando não são a ferramenta certa
-
Como calcular coeficientes de MPF estáticos e dinâmicos usando o pacote
qiskit_addon_mpf -
Como executar um workflow de MPF de ponta a ponta em hardware da IBM Quantum®, incluindo transpilação, mitigação de erros e pós-processamento
Pré-requisitos
-
Métodos de compilação para circuitos de simulação Hamiltoniana — apresenta os circuitos de Trotter (fórmula de produto) no Qiskit.
-
Fórmulas de produto no Qiskit, em particular as classes de síntese
SuzukiTrottereLieTrotter.
Contexto
O que são fórmulas de múltiplos produtos?
Ao simular sistemas quânticos em um computador quântico, uma tarefa central é aproximar o operador de evolução temporal para um Hamiltoniano . A abordagem padrão usa fórmulas de produto (PFs), também conhecidas como decomposições de Trotter-Suzuki. Elas decompõem em termos cujas unitárias individuais são eficientes de implementar, e então aproximam a evolução completa como um produto ordenado dessas unitárias mais simples.
A fórmula de produto de primeira ordem (Lie-Trotter) é:
que incorre em um erro quadrático: . Fórmulas simétricas de ordem superior , onde rotula a ordem da fórmula de produto simétrica (veja Ref. [1]), convergem mais rápido como , mas ao custo de circuitos mais profundos por etapa.
Para reduzir o erro em uma ordem fixa , geralmente se divide o tempo total de evolução em etapas de Trotter menores. Cada etapa aproxima por uma fórmula de produto e as etapas são concatenadas:
Para uma fórmula simétrica de ordem , o erro residual de Trotter então escala como . Portanto, aumentar suprime rapidamente o erro de Trotter — mas também aprofunda o circuito linearmente, e em hardware ruidoso isso significa mais ruído de porta acumulado. Essa tensão entre o erro de Trotter (favorece maior) e o ruído de hardware (favorece menor) é precisamente o que as fórmulas de múltiplos produtos são projetadas para resolver. Note que as MPFs tratam da combinação de resultados de diferentes escolhas de em uma ordem fixa — elas não alteram a ordem da fórmula de produto subjacente.
Fórmulas de múltiplos produtos (MPFs) [1] constroem uma combinação linear ponderada de valores esperados obtidos de vários circuitos de Trotter mais rasos, cada um usando um número diferente de etapas de Trotter (um conjunto de contagens de etapas):
onde é o valor esperado de um observável no tempo estimado a partir de um circuito de Trotter com etapas, e os coeficientes são escolhidos de modo que os termos de erro de Trotter dominantes na combinação se cancelem. Revisitaremos essa expressão na Etapa 4, onde a avaliamos explicitamente para combinar nossos resultados de Trotter. O ponto prático fundamental é que o circuito mais profundo na MPF precisa apenas de etapas, o que é muito menor do que o único que seria necessário para alcançar diretamente o mesmo erro de Trotter efetivo. Os circuitos mais rasos tornam a abordagem MPF mais adequada para hardware ruidoso.
Como os coeficientes são determinados?
Existem duas famílias de coeficientes de MPF:
Coeficientes estáticos são independentes do Hamiltoniano, do estado inicial e do tempo de evolução. Eles são encontrados resolvendo um sistema linear que impõe o cancelamento dos termos de erro de Trotter dominantes. Para um conjunto de etapas de Trotter usado com uma fórmula de produto simétrica de ordem , a expansão do erro de Trotter em potências inversas de leva a equações de restrição da forma:
onde os expoentes inteiros são as ordens dos termos sucessivos de erro de Trotter para a fórmula de produto escolhida. Para uma PF simétrica de ordem , o erro dominante em escala como , com correções subsequentes em — então os expoentes são . Para PFs não simétricas, tanto potências ímpares quanto pares contribuem e . Veja a Ref. [1] para a derivação completa. A primeira equação no sistema acima garante a ausência de viés (a MPF reproduz o valor esperado exato no limite ), e as equações restantes cancelam sucessivamente os primeiros termos de erro de Trotter. Quando a norma resultante é muito grande (o que amplifica o ruído de amostragem), você pode, em vez disso, resolver uma otimização aproximada que limita enquanto minimiza .
Coeficientes dinâmicos [2], [3] dependem adicionalmente do Hamiltoniano, do estado inicial e do tempo de evolução . Eles minimizam a distância de norma de Frobenius entre o estado verdadeiro evoluído no tempo e a aproximação MPF:
onde é a matriz de Gram das sobreposições entre estados evoluídos por Trotter para diferentes contagens de etapas , e mede a sobreposição com o estado exato (aproximado). Neste tutorial, essas quantidades são computadas de forma eficiente usando métodos de rede tensorial, especificamente os backends baseados em TeNPy em qiskit_addon_mpf.
Quando usar MPFs
As MPFs são mais benéficas quando:
-
A profundidade do circuito é o gargalo. Se o ruído do hardware limita a profundidade que você pode executar, use MPFs para alcançar maior precisão de Trotter efetiva a partir de circuitos mais rasos.
-
Você precisa de valores esperados precisos, não de preparação completa do estado. As MPFs operam no nível de valores esperados — elas combinam números clássicos, não estados quânticos. Portanto, são ideais para a estimativa de observáveis ao usar a primitiva Estimator.
-
Você combina um número modesto de contagens de etapas de Trotter. Normalmente, combinar – contagens de etapas diferentes é suficiente para cancelar vários termos de erro de Trotter dominantes, mantendo gerenciável.
Quando as MPFs podem não ajudar
-
Tempos de evolução muito curtos. Quando é pequeno o suficiente para que uma única fórmula de Trotter de baixa ordem já seja precisa, o overhead de executar vários circuitos é desnecessário.
-
Tarefas de preparação de estado. As MPFs produzem um valor esperado corrigido, não um estado quântico corrigido. Se você precisa do estado real evoluído no tempo (por exemplo, como entrada para outra sub-rotina quântica), as MPFs não se aplicam.
-
Contagens de etapas de Trotter que violam o regime de convergência. A derivação de coeficientes estáticos expande cada individual como uma série em ; essa expansão só converge bem quando . Se for escolhido muito pequeno para o dado, o circuito mais raso fica muito fora do regime perturbativo, os termos de erro de ordem superior que a MPF deixa sem cancelar se tornam grandes, e o cancelamento pode exigir coeficientes grandes. A norma é o diagnóstico prático: quando , o overhead de amostragem pode superar a redução do erro de Trotter. Veja o guia sobre como escolher etapas de Trotter para detalhes.
O que este tutorial aborda
Este tutorial percorre um workflow de MPF de ponta a ponta em duas etapas. Primeiro, um exemplo de simulador em pequena escala (cadeia de Heisenberg de 10 qubits) demonstra como configurar o problema, calcular coeficientes de MPF estáticos e dinâmicos, e comparar os valores esperados resultantes com a diagonalização exata. Em seguida, um exemplo de hardware em grande escala (cadeia XXZ de 50 qubits) mostra como transpilar, executar em hardware da IBM Quantum com mitigação de erros, e pós-processar os resultados usando os coeficientes de MPF. Ao longo do tutorial, usamos o pacote qiskit_addon_mpf junto com ferramentas padrão do Qiskit.
Requisitos
Antes de iniciar este tutorial, certifique-se de ter o seguinte instalado:
-
Qiskit SDK v2.0 ou posterior, com suporte a visualização
-
Qiskit Runtime v0.22 ou posterior (
pip install qiskit-ibm-runtime) -
Simulador Qiskit Aer (
pip install qiskit-aer) -
Addon MPF do Qiskit com o backend TeNPy (
pip install "qiskit-addon-mpf[tenpy]") -
Qiskit addon utilities (
pip install qiskit-addon-utils) -
SciPy (
pip install scipy)
Configuração
Abaixo reunimos todas as importações de pacotes usadas ao longo deste tutorial em uma única célula. Também definimos um pass do transpiler CollectAndCollapse que funde rotações rxx e ryy adjacentes em uma única XXPlusYYGate. Esse pass é aplicado tanto durante a construção do circuito na Etapa 1 (para manter a contagem de portas baixa) quanto indiretamente quando extraímos a estrutura em camadas para a MPF dinâmica na Etapa 4 (o TeNPy espera portas de dois qubits, não pares de rotações não fundidas).
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "qiskit": "qiskit", "qiskit_addon_mpf": "qiskit-addon-mpf", "qiskit_addon_utils": "qiskit-addon-utils", "qiskit_aer": "qiskit-aer", "qiskit_ibm_runtime": "qiskit-ibm-runtime", "scipy": "scipy", "tenpy": "physics-tenpy"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import warnings

import numpy as np
import matplotlib.pyplot as plt
from functools import partial
from copy import deepcopy

from qiskit import QuantumCircuit
from qiskit.quantum_info import Pauli, SparsePauliOp, Statevector
from qiskit.synthesis import SuzukiTrotter
from qiskit.transpiler import CouplingMap, PassManager
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager
from qiskit.circuit.library import XXPlusYYGate
from qiskit.transpiler.passes.optimization.collect_and_collapse import (
    CollectAndCollapse,
    collect_using_filter_function,
    collapse_to_operation,
)

from qiskit_aer import AerSimulator
from qiskit_ibm_runtime import EstimatorV2 as Estimator, QiskitRuntimeService

from qiskit_addon_utils.problem_generators import (
    generate_xyz_hamiltonian,
    generate_time_evolution_circuit,
)
from qiskit_addon_utils.slicing import slice_by_depth
from qiskit_addon_mpf.static import setup_static_lse
from qiskit_addon_mpf.dynamic import setup_dynamic_lse
from qiskit_addon_mpf.costs import (
    setup_exact_problem,
    setup_sum_of_squares_problem,
    setup_frobenius_problem,
)
from qiskit_addon_mpf.backends.tenpy_layers import (
    LayerModel,
    LayerwiseEvolver,
)
from qiskit_addon_mpf.backends.tenpy_tebd import MPOState, MPS_neel_state

from scipy.linalg import expm

# Suppress TeNPy's `unit_cell_width` future-API warning. The default
# (`unit_cell_width=len(sites)`) is correct for Chain lattices, which is what
# `CouplingMap.from_line(...)` produces here, so the warning is informational.
warnings.filterwarnings(
    "ignore",
    message=r".*unit_cell_width.*",
    category=UserWarning,
)

# --- Helper: collect XX + YY rotations into a single gate ---
def filter_function(node):
    return node.op.name in {"rxx", "ryy"}

collect_function = partial(
    collect_using_filter_function,
    filter_function=filter_function,
    split_blocks=True,
    min_block_size=1,
)

def collapse_to_xx_plus_yy(block):
    param = 0.0
    for node in block.data:
        param += node.operation.params[0]
    return XXPlusYYGate(param)

collapse_function = partial(
    collapse_to_operation,
    collapse_function=collapse_to_xx_plus_yy,
)

pm = PassManager()
pm.append(CollectAndCollapse(collect_function, collapse_function))
Exemplo de simulador em pequena escala
Passo 1: Mapear entradas clássicas para um problema quântico
Começamos com um modelo de Heisenberg de 10 qubits em uma linha, usando o estado de Néel como estado inicial. O Hamiltoniano é:
onde é a força de acoplamento entre vizinhos mais próximos. Medimos o correlator ZZ em um par de qubits no meio da cadeia, e usamos etapas de Trotter com uma fórmula de produto de segunda ordem.
L = 10

# Generate coupling map and Hamiltonian
coupling_map = CouplingMap.from_line(L, bidirectional=False)

hamiltonian = generate_xyz_hamiltonian(
    coupling_map,
    coupling_constants=(1.0, 1.0, 1.0),
    ext_magnetic_field=(0.0, 0.0, 0.0),
)
print(hamiltonian)
SparsePauliOp(['IIIIIIIXXI', 'IIIIIIIYYI', 'IIIIIIIZZI', 'IIIIIXXIII', 'IIIIIYYIII', 'IIIIIZZIII', 'IIIXXIIIII', 'IIIYYIIIII', 'IIIZZIIIII', 'IXXIIIIIII', 'IYYIIIIIII', 'IZZIIIIIII', 'IIIIIIIIXX', 'IIIIIIIIYY', 'IIIIIIIIZZ', 'IIIIIIXXII', 'IIIIIIYYII', 'IIIIIIZZII', 'IIIIXXIIII', 'IIIIYYIIII', 'IIIIZZIIII', 'IIXXIIIIII', 'IIYYIIIIII', 'IIZZIIIIII', 'XXIIIIIIII', 'YYIIIIIIII', 'ZZIIIIIIII'],
              coeffs=[1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j,
 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j,
 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j])
# Observable: ZZ on the middle pair of qubits
observable = SparsePauliOp.from_sparse_list(
    [("ZZ", (L // 2 - 1, L // 2), 1.0)], num_qubits=L
)
print(observable)
SparsePauliOp(['IIIIZZIIII'],
              coeffs=[1.+0.j])
# MPF parameters
mpf_trotter_steps = [1, 2, 4]
order = 2
symmetric = False

trotter_times = np.arange(0.5, 1.55, 0.1)
exact_evolution_times = np.arange(trotter_times[0], 1.55, 0.05)
Construir circuitos de Trotter
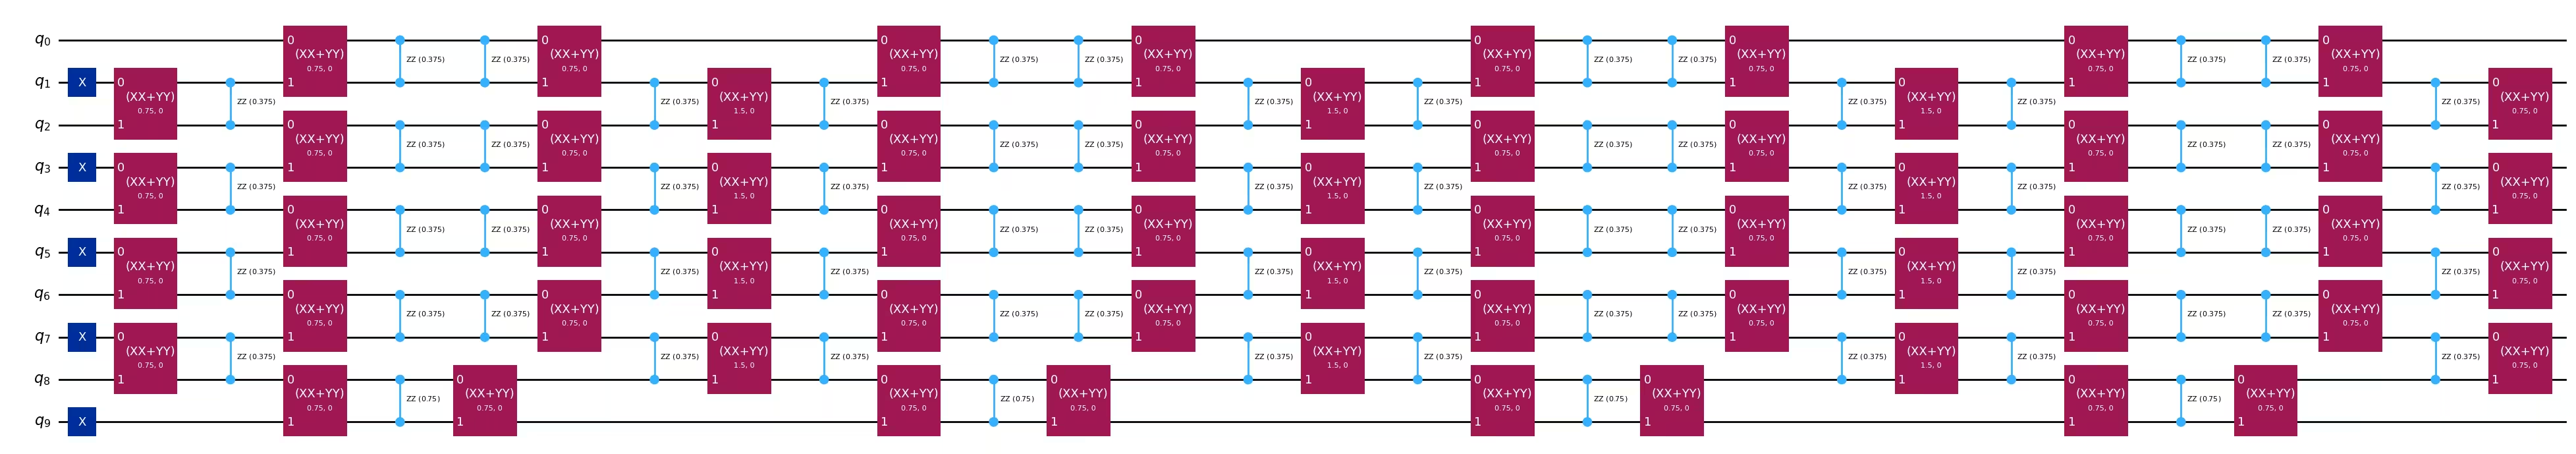
Criamos os circuitos que implementam as evoluções temporais aproximadas de Trotter para cada ponto de tempo e cada contagem de etapas de Trotter. O pass CollectAndCollapse definido na seção Configuração reúne rotações XX e YY em portas únicas XX+YY, para preparar uma simulação de rede tensorial mais eficiente posteriormente.
# Initial Neel state preparation
initial_state_circ = QuantumCircuit(L)
initial_state_circ.x([i for i in range(L) if i % 2 != 0])

all_circs = []
for total_time in trotter_times:
    mpf_trotter_circs = [
        generate_time_evolution_circuit(
            hamiltonian,
            time=total_time,
            synthesis=SuzukiTrotter(reps=num_steps, order=order),
        )
        for num_steps in mpf_trotter_steps
    ]

    mpf_trotter_circs = pm.run(
        mpf_trotter_circs
    )  # Collect XX and YY into XX + YY

    mpf_circuits = [
        initial_state_circ.compose(circuit) for circuit in mpf_trotter_circs
    ]
    all_circs.append(mpf_circuits)
mpf_circuits[-1].draw("mpl", fold=-1)
Passo 2: Otimizar o problema para execução em hardware quântico
Para o exemplo em pequena escala, usamos como alvo o simulador Aer. Duas transformações ocorrem antes que os circuitos estejam prontos para execução:
-
Coleta de portas no nível de simulação Hamiltoniana. Na célula de Configuração, construímos um pass
CollectAndCollapseque funde rotaçõesrxxeryyadjacentes em uma únicaXXPlusYYGate. Já aplicamos esse pass ao construir os circuitos de Trotter na Etapa 1 (a chamadapm.run(...)). Isso reduz a contagem de portas de dois qubits e produz uma estrutura mais adequada para simulação de rede tensorial no cálculo de coeficientes dinâmicos posteriormente. -
Redução para a ISA do simulador. Abaixo executamos o pass manager predefinido do Qiskit em
optimization_level=3para reduzir cada circuito de Trotter para a arquitetura de conjunto de instruções (ISA) do simulador.
aer_sim = AerSimulator()
pm_sim = generate_preset_pass_manager(backend=aer_sim, optimization_level=3)

isa_circs_all_times = [
    pm_sim.run([deepcopy(c) for c in mpf_circuits])
    for mpf_circuits in all_circs
]
Etapa 3: Executar usando as primitivas do Qiskit
Para o exemplo em pequena escala, executamos os circuitos de Trotter reduzidos para ISA através da primitiva EstimatorV2 apoiada pelo Aer. Isso nos dá um valor de referência sem ruído para cada par — esses são os valores que a MPF combinará na Etapa 4. Varremos os tempos de evolução para que possamos depois plotar a curva completa da série temporal de cada fórmula de produto individual e da MPF.
estimator = Estimator(mode=aer_sim)

mpf_expvals_all_times, mpf_stds_all_times = [], []
for isa_circuits in isa_circs_all_times:
    result = estimator.run(
        [(circuit, observable) for circuit in isa_circuits], precision=0.005
    ).result()
    mpf_expvals_all_times.append([res.data.evs for res in result])
    mpf_stds_all_times.append([res.data.stds for res in result])
Etapa 4: Pós-processar e retornar o resultado no formato clássico desejado
A Etapa 4 é onde a MPF é efetivamente construída. Embora os coeficientes sejam calculados aqui (e, para a variante dinâmica, esse cálculo pode ser intenso), conceitualmente eles são uma receita clássica para combinar as medições quânticas da Etapa 3 em um único valor esperado corrigido — portanto, tratamos todo o workflow de coeficientes e combinação como pós-processamento.
Para avaliar quão bem a MPF acompanha a dinâmica verdadeira, primeiro calculamos os valores esperados exatos evoluídos no tempo exponenciando diretamente o Hamiltoniano. Isso só é tratável porque ; no exemplo de hardware em grande escala abaixo, teremos que confiar em estimativas de rede tensorial.
exact_expvals = []
for t in exact_evolution_times:
    exp_H = expm(-1j * t * hamiltonian.to_matrix())
    initial_state = Statevector(initial_state_circ).data
    time_evolved_state = exp_H @ initial_state

    exact_obs = (
        time_evolved_state.conj()
        @ observable.to_matrix()
        @ time_evolved_state
    ).real
    exact_expvals.append(exact_obs)
Coeficientes MPF estáticos
As MPFs estáticas usam coeficientes que são independentes do tempo de evolução, do Hamiltoniano e do estado inicial. Configuramos o sistema linear descrito no Contexto e resolvemos para os coeficientes. A matriz é determinada pelas contagens de etapas de Trotter , pela ordem da fórmula de produto e por se a fórmula é simétrica (o que controla os expoentes ).
Para nosso exemplo em pequena escala, usamos com uma fórmula de Suzuki-Trotter não simétrica de ordem (então e , dando ). O sistema se torna:
A primeira linha impõe a ausência de viés (); a segunda e a terceira linhas cancelam os termos de erro de Trotter dominante e de próxima ordem , respectivamente.
Configurar o LSE
Usamos setup_static_lse de qiskit_addon_mpf.static para montar a matriz e o vetor do lado direito descritos acima. A matriz depende não apenas de , mas também da nossa escolha de fórmula de produto — em particular sua ordem e se ela é simétrica. A flag symmetric controla o padrão de expoentes (fórmulas simétricas produzem apenas termos de erro de Trotter de potência par; veja a Ref. [1]). Note que, como mostrado na Ref. [2], definir symmetric=True não é estritamente necessário mesmo quando a PF subjacente é simétrica — o LSE não simétrico continua válido (ele impõe restrições extras desnecessárias).
Para nosso exemplo, já definimos order = 2 e symmetric = False na Etapa 1.
lse = setup_static_lse(mpf_trotter_steps, order=order, symmetric=symmetric)
Inspecione a matriz e o vetor construídos para confirmar que correspondem ao sistema escrito acima.
lse.A
array([[1.      , 1.      , 1.      ],
       [1.      , 0.25    , 0.0625  ],
       [1.      , 0.125   , 0.015625]])
lse.b
array([1., 0., 0.])
Com o LSE em mãos, resolvemos para os coeficientes estáticos via lse.solve() (esta é a solução direta ).
mpf_coeffs = lse.solve()
print(
    f"The static coefficients associated with the ansatze are: {mpf_coeffs}"
)
The static coefficients associated with the ansatze are: [ 0.04761905 -0.57142857 1.52380952]
Otimizar para usando um modelo exato
Alternativamente ao cálculo de , você pode usar setup_exact_model para construir uma instância de cvxpy.Problem que usa o LSE como restrições e cuja solução ótima produzirá .
model_exact, coeffs_exact = setup_exact_problem(lse)
model_exact.solve()
print(coeffs_exact.value)
[ 0.04761905 -0.57142857 1.52380952]
print(
    "L1 norm of the exact coefficients:",
    np.linalg.norm(coeffs_exact.value, ord=1),
)
L1 norm of the exact coefficients: 2.1428571428556378
Otimizar para usando um modelo aproximado
Pode acontecer que a norma para o conjunto escolhido de valores de seja considerada muito alta. Se esse for o caso e você não puder escolher um conjunto diferente de valores de , você pode usar uma solução aproximada que restringe a norma a um limite escolhido enquanto minimiza . Confira o guia sobre Como usar o modelo aproximado.
model_approx, coeffs_approx = setup_sum_of_squares_problem(
    lse, max_l1_norm=1.5
)
model_approx.solve()
print(coeffs_approx.value)
print(
    "L1 norm of the approximate coefficients:",
    np.linalg.norm(coeffs_approx.value, ord=1),
)
[-1.10294118e-03 -2.48897059e-01  1.25000000e+00]
L1 norm of the approximate coefficients: 1.5
Coeficientes MPF dinâmicos
A MPF estática cancela termos de erro de Trotter de forma agnóstica ao Hamiltoniano e ao estado, portanto não necessariamente produz o menor erro de aproximação possível para um dado Hamiltoniano e estado inicial. A MPF dinâmica (Refs. [2], [3]) encontra, em vez disso, coeficientes dependentes do tempo que minimizam a distância de norma de Frobenius em cada tempo . Como mostrado no Contexto, isso requer a matriz de sobreposição entre estados evoluídos por Trotter e a sobreposição com o estado exato — ambas estimadas usando backends de rede tensorial (TeNPy) em qiskit_addon_mpf.
Para configurar o LSE dinâmico, precisamos de três ingredientes:
-
Uma fábrica de evolver aproximado que o addon executará para cada para produzir como um MPS/MPO. Nós a construímos a partir da estrutura em camadas do circuito de Trotter de ordem (uma camada por
slice_by_depth), envolvida como umLayerwiseEvolvercom parâmetros de truncamento do TeNPy. -
Uma fábrica de evolver exato que produz uma referência de alta precisão . Usamos um circuito de Suzuki-Trotter de quarta ordem com passo de tempo pequeno (
dt=0.1,order=4) como proxy para a evolução exata. -
Uma fábrica de identidade e um MPS de estado inicial que iniciam a simulação do TeNPy.
A célula abaixo constrói a fábrica de evolver aproximado.
# Create approximate time-evolution circuits
single_2nd_order_circ = generate_time_evolution_circuit(
    hamiltonian, time=1.0, synthesis=SuzukiTrotter(reps=1, order=order)
)
single_2nd_order_circ = pm.run(single_2nd_order_circ)  # collect XX and YY

# Find layers in the circuit
layers = slice_by_depth(single_2nd_order_circ, max_slice_depth=1)

# Create tensor network models
models = [
    LayerModel.from_quantum_circuit(layer, conserve="Sz") for layer in layers
]

# Create the time-evolution object
approx_factory = partial(
    LayerwiseEvolver,
    layers=models,
    options={
        "preserve_norm": False,
        "trunc_params": {
            "chi_max": 64,
            "svd_min": 1e-8,
            "trunc_cut": None,
        },
        "max_delta_t": 2,
    },
)
As opções de LayerwiseEvolver que determinam os detalhes da simulação de rede tensorial devem ser escolhidas com cuidado para evitar a configuração de um problema de otimização mal definido.
Aproximamos o estado exato evoluído no tempo com uma fórmula de Suzuki-Trotter de quarta ordem usando um pequeno passo de tempo dt=0.1. Os parâmetros de truncamento do TeNPy podem afetar a precisão, portanto é importante explorar uma variedade de valores.
single_4th_order_circ = generate_time_evolution_circuit(
    hamiltonian, time=1.0, synthesis=SuzukiTrotter(reps=1, order=4)
)
single_4th_order_circ = pm.run(single_4th_order_circ)
exact_model_layers = [
    LayerModel.from_quantum_circuit(layer, conserve="Sz")
    for layer in slice_by_depth(single_4th_order_circ, max_slice_depth=1)
]

exact_factory = partial(
    LayerwiseEvolver,
    layers=exact_model_layers,
    dt=0.1,
    options={
        "preserve_norm": False,
        "trunc_params": {
            "chi_max": 64,
            "svd_min": 1e-8,
            "trunc_cut": None,
        },
        "max_delta_t": 2,
    },
)
Por fim, definimos uma identity_factory que produz o estado MPO inicial e preparamos o estado inicial de Néel como um MPS que corresponde à rede usada pelo modelo de Trotter em camadas.
def identity_factory():
    return MPOState.initialize_from_lattice(models[0].lat, conserve=True)

mps_initial_state = MPS_neel_state(models[0].lat)
Com as fábricas prontas, agora calculamos os coeficientes dinâmicos em cada tempo de evolução. Para cada , setup_dynamic_lse constrói as matrizes de sobreposição relevantes via TeNPy, e setup_frobenius_problem retorna um cvxpy.Problem que minimiza o custo de norma de Frobenius. O solver retorna coeficientes adaptados a esse tempo; nós os coletamos em mpf_dynamic_coeffs_list. Se o solver falhar para um dado , recorremos a coeficientes zero para que o loop continue.
mpf_dynamic_coeffs_list = []
for t in trotter_times:
    print(f"Computing dynamic coefficients for time={t}")
    lse = setup_dynamic_lse(
        mpf_trotter_steps,
        t,
        identity_factory,
        exact_factory,
        approx_factory,
        mps_initial_state,
    )
    problem, coeffs = setup_frobenius_problem(lse)
    try:
        problem.solve()
        mpf_dynamic_coeffs_list.append(coeffs.value)
    except Exception as error:
        mpf_dynamic_coeffs_list.append(np.zeros(len(mpf_trotter_steps)))
        print(error, "Calculation Failed for time", t)
    print("")
Computing dynamic coefficients for time=0.5

Computing dynamic coefficients for time=0.6

Computing dynamic coefficients for time=0.7

Computing dynamic coefficients for time=0.7999999999999999

Computing dynamic coefficients for time=0.8999999999999999

Computing dynamic coefficients for time=0.9999999999999999

Computing dynamic coefficients for time=1.0999999999999999

Computing dynamic coefficients for time=1.1999999999999997

Computing dynamic coefficients for time=1.2999999999999998

Computing dynamic coefficients for time=1.4

Computing dynamic coefficients for time=1.4999999999999998
Combinar valores esperados de Trotter com os coeficientes de MPF
Agora avaliamos para cada conjunto de coeficientes (estático-exato, estático-aproximado e dinâmico), propagamos os erros padrão por circuito, e plotamos a série temporal resultante em comparação com a curva de diagonalização exata.
sym = {1: "^", 2: "s", 4: "p"}
# Get expectation values at all times for each Trotter step
for k, step in enumerate(mpf_trotter_steps):
    trotter_curve, trotter_curve_error = [], []
    for trotter_expvals, trotter_stds in zip(
        mpf_expvals_all_times, mpf_stds_all_times
    ):
        trotter_curve.append(trotter_expvals[k])
        trotter_curve_error.append(trotter_stds[k])

    plt.errorbar(
        trotter_times,
        trotter_curve,
        yerr=trotter_curve_error,
        alpha=0.5,
        markersize=4,
        marker=sym[step],
        color="grey",
        label=f"{mpf_trotter_steps[k]} Trotter steps",
    )

# Get expectation values at all times for the static MPF with exact coeffs
exact_mpf_curve, exact_mpf_curve_error = [], []
for trotter_expvals, trotter_stds in zip(
    mpf_expvals_all_times, mpf_stds_all_times
):
    mpf_std = np.sqrt(
        sum(
            [
                (coeff**2) * (std**2)
                for coeff, std in zip(coeffs_exact.value, trotter_stds)
            ]
        )
    )
    exact_mpf_curve_error.append(mpf_std)
    exact_mpf_curve.append(trotter_expvals @ coeffs_exact.value)

plt.errorbar(
    trotter_times,
    exact_mpf_curve,
    yerr=exact_mpf_curve_error,
    markersize=4,
    marker="o",
    label="Static MPF - Exact",
    color="purple",
)

# Get expectation values at all times for the static MPF with approximate coeffs
approx_mpf_curve, approx_mpf_curve_error = [], []
for trotter_expvals, trotter_stds in zip(
    mpf_expvals_all_times, mpf_stds_all_times
):
    mpf_std = np.sqrt(
        sum(
            [
                (coeff**2) * (std**2)
                for coeff, std in zip(coeffs_approx.value, trotter_stds)
            ]
        )
    )
    approx_mpf_curve_error.append(mpf_std)
    approx_mpf_curve.append(trotter_expvals @ coeffs_approx.value)

plt.errorbar(
    trotter_times,
    approx_mpf_curve,
    yerr=approx_mpf_curve_error,
    markersize=4,
    marker="o",
    label="Static MPF - Approx",
    color="orange",
)

# Get expectation values at all times for the dynamic MPF
dynamic_mpf_curve, dynamic_mpf_curve_error = [], []
for trotter_expvals, trotter_stds, dynamic_coeffs in zip(
    mpf_expvals_all_times, mpf_stds_all_times, mpf_dynamic_coeffs_list
):
    mpf_std = np.sqrt(
        sum(
            [
                (coeff**2) * (std**2)
                for coeff, std in zip(dynamic_coeffs, trotter_stds)
            ]
        )
    )
    dynamic_mpf_curve_error.append(mpf_std)
    dynamic_mpf_curve.append(trotter_expvals @ dynamic_coeffs)

plt.errorbar(
    trotter_times,
    dynamic_mpf_curve,
    yerr=dynamic_mpf_curve_error,
    markersize=4,
    marker="o",
    label="Dynamic MPF",
    color="pink",
)

# Exact expectation values
plt.plot(
    exact_evolution_times,
    exact_expvals,
    color="red",
    linestyle="--",
    label="Exact time-evolution",
)

plt.title(f"$\\langle Z_{{{L//2-1}}} Z_{{{L//2}}} \\rangle$ vs time")
plt.xlabel("Time")
plt.ylabel("Expectation Value")
plt.legend(loc="upper center", bbox_to_anchor=(0.5, -0.2), ncol=2)
plt.grid(alpha=0.1)
plt.tight_layout()
plt.show()

O gráfico acima ilustra a interação entre o erro de Trotter e o erro de amostragem.
-
Erro de Trotter. As fórmulas de produto individuais (marcadores cinzas) se desviam cada vez mais da curva exata à medida que o tempo cresce. O circuito tem o maior desvio e é o mais raso, mas também já está no regime em que , então o termo de erro dominante é grande. As combinações MPF (marcadores coloridos) cancelam vários desses termos de erro de Trotter dominantes, então acompanham a curva exata muito mais de perto do que qualquer circuito individual . A lacuna restante reflete os termos de Trotter de ordem superior que a MPF não cancela: uma MPF estática de ordem , elimina apenas as duas primeiras ordens de erro, e em grande a cauda não cancelada acaba dominando — portanto a MPF não garante que circuitos muito rasos permaneçam precisos em tempos arbitrários.
-
Erro de amostragem. As barras de erro mais largas nas curvas de MPF são uma consequência direta da combinação linear: a propagação dos erros padrão independentes por circuito dá uma variância total . Portanto, quanto maior o (e, na prática, o , que é o que controlamos), mais shots são necessários para alcançar uma dada incerteza-alvo. Essa é a troca por trás da opção de solver aproximado no Contexto: limitamos para manter esse overhead gerenciável. Crucialmente, ao contrário do erro de Trotter, o erro de amostragem diminui com , então sempre pode ser reduzido gastando mais shots.
No exemplo de hardware em grande escala abaixo, o ruído de hardware entra como uma fonte de erro adicional em cada , que é igualmente amplificado pelos coeficientes de MPF. Veremos como a mitigação de erros interage com as MPFs nessa seção.
Exemplo de hardware em grande escala
Nesta seção, escalamos o problema além do que é possível simular exatamente. Reproduzimos alguns dos resultados mostrados na Ref. [3], usando uma cadeia XXZ de 50 qubits no tempo . Seguimos o mesmo workflow de quatro etapas do exemplo em pequena escala, agora direcionando para hardware quântico real com mitigação de erros. Como no modelo, cada etapa é marcada em linha no código, e uma única etapa pode abranger múltiplas células quando seus resultados intermediários valem a pena ser inspecionados. O mapeamento espelha o exemplo em pequena escala: definir um Hamiltoniano, escolher parâmetros de Trotter, calcular coeficientes de MPF (estáticos e dinâmicos), e construir circuitos. As principais diferenças são:
-
Um Hamiltoniano XXZ em 50 sítios com acoplamentos aleatórios extraídos de (Ref. [3]).
-
Uma fórmula de Trotter de segunda ordem simétrica com (então ,
symmetric=True). -
Um único tempo de evolução fixo . Com isso dá , mantendo os constituintes rasos dentro do regime de convergência de Trotter onde o modelo de erro dominante em que a MPF se baseia é válido.
-
Uma execução adicional de comparação de circuito único com etapas de Trotter, usada como referência. Escolhemos porque sua profundidade de dois qubits em hardware é maior do que o constituinte MPF mais profundo () mais o overhead de executar múltiplos circuitos MPF — profundo o suficiente para ser limitado por ruído, que é o regime no qual se espera que a combinação MPF supere a referência de circuito único. É uma comparação de "circuito único profundo" contra a combinação MPF, não um circuito que visa o erro de Trotter efetivo da MPF (o que exigiria muito mais etapas).
Observe que, embora ainda estejamos na Etapa 1 aqui (mapeamento e construção de circuito), também pré-calculamos os coeficientes dinâmicos junto com os estáticos nesta célula. Os coeficientes dinâmicos dependem de e , mas não das medições quânticas, então podem ser calculados a qualquer momento antes da Etapa 4. Fazemos isso agora para manter toda a configuração específica de MPF em um só lugar.
# -------------------------Step 1-------------------------
L = 50
coupling_map = CouplingMap.from_line(L, bidirectional=False)

# XXZ Hamiltonian with random couplings (Ref. [3])
np.random.seed(0)
even_edges = list(coupling_map.get_edges())[::2]
odd_edges = list(coupling_map.get_edges())[1::2]

Js = np.random.uniform(0.5, 1.5, size=L)
hamiltonian = SparsePauliOp(Pauli("I" * L))
for i, edge in enumerate(even_edges + odd_edges):
    hamiltonian += SparsePauliOp.from_sparse_list(
        [
            ("XX", (edge), 2 * Js[i]),
            ("YY", (edge), 2 * Js[i]),
            ("ZZ", (edge), 4 * Js[i]),
        ],
        num_qubits=L,
    )

observable = SparsePauliOp.from_sparse_list(
    [("ZZ", (L // 2 - 1, L // 2), 1.0)], num_qubits=L
)

total_time = 3
mpf_trotter_steps = [3, 4, 6]
order = 2
symmetric = True

# Static coefficients
lse = setup_static_lse(mpf_trotter_steps, order=order, symmetric=symmetric)
mpf_coeffs = lse.solve()
print(f"Static coefficients: {mpf_coeffs}")
print(f"L1 norm: {np.linalg.norm(mpf_coeffs, ord=1)}")

model_approx, coeffs_approx = setup_sum_of_squares_problem(
    lse, max_l1_norm=2.0
)
model_approx.solve()
print(f"Approximate coefficients: {coeffs_approx.value}")
print(f"L1 norm (approx): {np.linalg.norm(coeffs_approx.value, ord=1)}")

# -------------------------Dynamic coefficients-------------------------
single_2nd_order_circ = generate_time_evolution_circuit(
    hamiltonian, time=1.0, synthesis=SuzukiTrotter(reps=1, order=order)
)
single_2nd_order_circ = pm.run(single_2nd_order_circ)

layers = slice_by_depth(single_2nd_order_circ, max_slice_depth=1)
models = [
    LayerModel.from_quantum_circuit(layer, conserve="Sz") for layer in layers
]

approx_factory = partial(
    LayerwiseEvolver,
    layers=models,
    options={
        "preserve_norm": False,
        "trunc_params": {"chi_max": 64, "svd_min": 1e-8, "trunc_cut": None},
        "max_delta_t": 4,
    },
)

single_4th_order_circ = generate_time_evolution_circuit(
    hamiltonian, time=1.0, synthesis=SuzukiTrotter(reps=1, order=4)
)
single_4th_order_circ = pm.run(single_4th_order_circ)
exact_model_layers = [
    LayerModel.from_quantum_circuit(layer, conserve="Sz")
    for layer in slice_by_depth(single_4th_order_circ, max_slice_depth=1)
]

exact_factory = partial(
    LayerwiseEvolver,
    layers=exact_model_layers,
    dt=0.1,
    options={
        "preserve_norm": False,
        "trunc_params": {"chi_max": 64, "svd_min": 1e-8, "trunc_cut": None},
        "max_delta_t": 3,
    },
)

def identity_factory():
    return MPOState.initialize_from_lattice(models[0].lat, conserve=True)

mps_initial_state = MPS_neel_state(models[0].lat)

print(f"Computing dynamic coefficients for time={total_time}")
lse_dyn = setup_dynamic_lse(
    mpf_trotter_steps,
    total_time,
    identity_factory,
    exact_factory,
    approx_factory,
    mps_initial_state,
)
problem, coeffs_dyn = setup_frobenius_problem(lse_dyn)
try:
    problem.solve()
    mpf_dynamic_coeffs = coeffs_dyn.value
except Exception as error:
    mpf_dynamic_coeffs = np.zeros(len(mpf_trotter_steps))
    print(error, "Calculation Failed")

# -------------------------Step 1 (cont): Build circuits-------------------------
mpf_circuits = []
for k in mpf_trotter_steps:
    circuit = QuantumCircuit(L)
    circuit.x([i for i in range(L) if i % 2])
    trotter_circ = generate_time_evolution_circuit(
        hamiltonian,
        synthesis=SuzukiTrotter(reps=k, order=order),
        time=total_time,
    )
    circuit.compose(trotter_circ, qubits=range(L), inplace=True)
    mpf_circuits.append(circuit)

# Baseline "single deep circuit" comparison run with k=10 Trotter steps.
# Its two-qubit depth is deeper than the deepest MPF constituent (k_max=6) plus
# the overhead of running multiple circuits, pushing it into the noise-limited
# regime where MPF is expected to outperform. It does NOT target the MPF's effective
# Trotter error (which would require many more steps).
comp_circuit = QuantumCircuit(L)
comp_circuit.x([i for i in range(L) if i % 2])
trotter_circ = generate_time_evolution_circuit(
    hamiltonian,
    synthesis=SuzukiTrotter(reps=10, order=order),
    time=total_time,
)
comp_circuit.compose(trotter_circ, qubits=range(L), inplace=True)
mpf_circuits.append(comp_circuit)
Static coefficients: [ 0.42857143 -1.82857143  2.4       ]
L1 norm: 4.65714285714286
Approximate coefficients: [-0.4942491   0.40206845  1.09218065]
L1 norm (approx): 1.9884981979026675
Computing dynamic coefficients for time=3
Agora otimizamos os circuitos para o backend escolhido. Usamos o pass manager predefinido do Qiskit em optimization_level=3, que seleciona automaticamente um bom conjunto de qubits físicos e roteia cada circuito para a topologia do dispositivo.
# -------------------------Step 2-------------------------
service = QiskitRuntimeService()
# backend = service.least_busy(operational=True, simulator=False, min_num_qubits=L)
backend = service.backend("ibm_fez")
print(backend)

transpiler = generate_preset_pass_manager(
    optimization_level=3, backend=backend
)
transpiled_circuits = [transpiler.run(circ) for circ in mpf_circuits]

isa_observables = [
    observable.apply_layout(circ.layout) for circ in transpiled_circuits
]
<IBMBackend('ibm_fez')>
Executar circuitos mais profundos em hardware real requer mitigação de erros agressiva. Habilitamos desacoplamento dinâmico, twirling de portas e medição, mitigação de erro de medição e extrapolação de ruído zero (ZNE). Observe que os fatores de ruído de ZNE que usamos aqui (1, 1.2, 1.4) são menores do que em um cenário de circuito raso, já que os constituintes MPF mais profundos já estão próximos do limiar de ruído e grandes amplificações de ruído os empurrariam além do ponto em que a extrapolação ZNE é confiável.
Enviamos os quatro circuitos (três constituintes MPF em mais a referência ) em um único job do Estimator.
# -------------------------Step 3-------------------------
estimator = Estimator(mode=backend)
estimator.options.default_shots = 30000

# Error suppression/mitigation
estimator.options.dynamical_decoupling.enable = True
estimator.options.twirling.enable_gates = True
estimator.options.twirling.enable_measure = True
estimator.options.twirling.num_randomizations = "auto"
estimator.options.twirling.strategy = "active-accum"
estimator.options.resilience.measure_mitigation = True
estimator.options.experimental.execution_path = "gen3-turbo"

estimator.options.resilience.zne_mitigation = True
estimator.options.resilience.zne.noise_factors = (1, 1.2, 1.4)
estimator.options.resilience.zne.extrapolator = "linear"

estimator.options.environment.job_tags = ["TUT_MPF"]

job_50 = estimator.run(
    [
        (circ, observable)
        for circ, observable in zip(transpiled_circuits, isa_observables)
    ]
)
Extraímos os valores esperados e desvios padrão por circuito do resultado do job, e então os combinamos com cada conjunto de coeficientes de MPF exatamente como no exemplo em pequena escala: , com variância propagada .
# -------------------------Step 4-------------------------
result = job_50.result()
evs = [res.data.evs for res in result]
std = [res.data.stds for res in result]

print(evs)
print(std)
[array(-0.07916195), array(-0.04479681), array(-0.2560756), array(-0.06045848)]
[array(0.04605538), array(0.10056336), array(0.14426151), array(0.04059092)]
exact_mpf_std = np.sqrt(
    sum([(coeff**2) * (std**2) for coeff, std in zip(mpf_coeffs, std[:3])])
)
print(
    "Exact static MPF expectation value: ",
    evs[:3] @ mpf_coeffs,
    "+-",
    exact_mpf_std,
)
approx_mpf_std = np.sqrt(
    sum(
        [
            (coeff**2) * (std**2)
            for coeff, std in zip(coeffs_approx.value, std[:3])
        ]
    )
)
print(
    "Approximate static MPF expectation value: ",
    evs[:3] @ coeffs_approx.value,
    "+-",
    approx_mpf_std,
)
dynamic_mpf_std = np.sqrt(
    sum(
        [
            (coeff**2) * (std**2)
            for coeff, std in zip(mpf_dynamic_coeffs, std[:3])
        ]
    )
)
print(
    "Dynamic MPF expectation value: ",
    evs[:3] @ mpf_dynamic_coeffs,
    "+-",
    dynamic_mpf_std,
)
Exact static MPF expectation value:  -0.5665938395816946 +- 0.3925273058119915
Approximate static MPF expectation value:  -0.25856647611537903 +- 0.164249927266166
Dynamic MPF expectation value:  -0.12667812062949296 +- 0.06059471006973169
sym = {3: "^", 4: "s", 6: "p"}
for k, step in enumerate(mpf_trotter_steps):
    plt.errorbar(
        k,
        evs[k],
        yerr=std[k],
        alpha=0.5,
        markersize=4,
        marker=sym[step],
        color="grey",
        label=f"{mpf_trotter_steps[k]} Trotter steps",
    )

plt.errorbar(
    3,
    evs[-1],
    yerr=std[-1],
    alpha=0.5,
    markersize=8,
    marker="x",
    color="blue",
    label="10 Trotter steps",
)

plt.errorbar(
    4,
    evs[:3] @ mpf_coeffs,
    yerr=exact_mpf_std,
    markersize=4,
    marker="o",
    color="purple",
    label="Static MPF",
)

plt.errorbar(
    5,
    evs[:3] @ coeffs_approx.value,
    yerr=approx_mpf_std,
    markersize=4,
    marker="o",
    color="orange",
    label="Approximate static MPF",
)

plt.errorbar(
    6,
    evs[:3] @ mpf_dynamic_coeffs,
    yerr=dynamic_mpf_std,
    markersize=4,
    marker="o",
    color="pink",
    label="Dynamic MPF",
)

exact_obs = -0.24384471447172074  # Calculated via Tensor Network calculation
plt.axhline(
    y=exact_obs, linestyle="--", color="red", label="Exact time-evolution"
)

plt.title(
    f"$\\langle Z_{{{L//2-1}}} Z_{{{L//2}}} \\rangle$ at time {total_time} for the different methods"
)
plt.xlabel("Method")
plt.ylabel("Expectation Value")
plt.legend(loc="upper center", bbox_to_anchor=(0.5, -0.2), ncol=2)
plt.grid(alpha=0.1)
plt.tight_layout()
plt.show()

Algumas observações sobre os resultados de hardware acima:
-
Ir mais fundo não é gratuito em hardware. As referências de circuito único contam a história diretamente: o circuito é essencialmente exato ( versus a referência ), no entanto a referência mais profunda é pior (, com um desvio de ), não melhor. Uma vez que o erro de Trotter já é pequeno, adicionar etapas principalmente aprofunda o circuito e acumula mais ruído de porta e decoerência. Este é precisamente o regime para o qual as MPFs foram criadas: alcançar a precisão de um circuito profundo usando apenas constituintes rasos.
-
Uma MPF de norma pequena supera o circuito único profundo. A MPF estática aproximada (limitada a ) chega a , dentro de da referência e muito mais próxima do que a referência . A MPF dinâmica () também supera confortavelmente essa referência. Ambas combinam apenas os circuitos rasos , mas recuperam uma resposta que o circuito único profundo não conseguiu.
-
A norma do coeficiente importa mais do que a otimalidade matemática. A MPF estática exata tem e é o pior estimador de todos (, com um desvio de mais de ): a grande norma de coeficiente amplifica o ruído de porta residual, a decoerência e o erro de ZNE em cada por aproximadamente o mesmo fator, superando o ganho obtido com o cancelamento do erro de Trotter. Limitar a norma (o solver estático aproximado, ) elimina esse efeito e fornece a melhor estimativa — mesmo que seus coeficientes não cancelem mais o erro de Trotter dominante exatamente.
-
Circuitos rasos individuais ainda podem ser competitivos. O único constituinte () é ele próprio essencialmente exato aqui — nesta execução, ele é até marginalmente mais próximo do que a MPF estática aproximada. O problema é que você não sabe de antemão qual único está no ponto ideal de "convergido, mas ainda não limitado por ruído", e a escolha aparentemente segura de simplesmente ir mais fundo () para garantir a convergência de Trotter é exatamente aquela que falha. A MPF fornece uma combinação fundamentada de circuitos rasos que não requer adivinhar a profundidade correta.
A conclusão prática é que, em hardware, as MPFs devem ser combinadas com forte mitigação de erros em cada individual, a norma do coeficiente deve ser mantida modesta (use o solver aproximado, ou a MPF dinâmica), e as etapas de Trotter devem ser escolhidas de forma que — aqui em dá , mantendo os constituintes dentro do regime convergente onde o modelo de erro dominante em que a MPF estática se baseia é válido. Com essas escolhas, as MPFs de norma pequena aqui igualam um circuito único convergido, enquanto a referência ingênua de "apenas ir mais fundo" não o faz, recuperando a vantagem de profundidade versus precisão mostrada na Ref. [3]. Observe também que execuções individuais são ruidosas — em uma submissão diferente do mesmo job (ou um backend diferente), a ordenação exata pode mudar; as tendências robustas são que MPFs com pequeno se saem bem, a MPF estática exata com grande é amplificada pelo ruído de hardware, e o circuito único excessivamente profundo é limitado por ruído.
Próximos passos
Se você achou este trabalho interessante, talvez se interesse pelo seguinte material:
- Como escolher as etapas de Trotter para uma MPF — orientação prática sobre como selecionar valores de para evitar instabilidades
- Como usar o modelo aproximado — ajuste da restrição de norma e opções do solver para a MPF estática aproximada
- Referência da API do
qiskit-addon-mpf— documentação completa dos módulos estático, dinâmico e de backend
Referências
[1] Vazquez, A. C., Egger, D. J., Ochsner, D., & Woerner, S. Well-conditioned multi-product formulas for hardware-friendly Hamiltonian simulation. Quantum, 7, 1067 (2023)
[2] Zhuk, S., Robertson, N. F., & Bravyi, S. Trotter error bounds and dynamic multi-product formulas for Hamiltonian simulation. Physical Review Research, 6(3), 033309 (2024)
[3] Robertson, N. F., et al. Tensor network enhanced dynamic multiproduct formulas. arXiv:2407.17405 (2024)