Classifique risco de crédito com a Rimay Quantum Feature Extraction da Kipu Quantum
Qiskit Functions são um recurso experimental disponível apenas para usuários dos planos IBM Quantum® Premium Plan, Flex Plan e On-Prem (por meio da API da IBM Quantum Platform). Elas estão em status de versão preliminar e sujeitas a alterações.
Estimativa de uso: 2 minutos em um processador Nighthawk r2. (OBSERVAÇÃO: esta é apenas uma estimativa. Seu tempo de execução pode variar.)
Resultados de aprendizagem
-
Preparar dados tabulares com colunas categóricas e numéricas para a Qiskit Function Rimay.
-
Ajustar um mapeamento de recursos quânticos nos dados de treinamento e mapear os dados de teste na mesma execução.
-
Treinar modelos clássicos em recursos transformados quanticamente, isoladamente e combinados com os recursos originais.
-
Comparar os resultados com uma linha de base puramente clássica.
Pré-requisitos
Antes de começar este tutorial, você deve estar familiarizado com os seguintes tópicos:
-
Classificação supervisionada com scikit-learn
Contexto
Muitos problemas de aprendizado de máquina na indústria envolvem conjuntos de dados tabulares pequenos ou médios, nos quais adicionar mais dados não é uma opção e a acurácia do modelo atinge um platô. A pontuação de risco de crédito é um exemplo típico. Um credor usa algumas dezenas de atributos para decidir se o solicitante provavelmente vai pagar o crédito.
Rimay, uma Qiskit Function da Kipu Quantum, adiciona uma etapa de pré-processamento quântico a esse tipo de pipeline. Ela implementa o algoritmo de extração quântica de características contradiabática digitalizada [1]. Cada característica de entrada é mapeada para um qubit. Os valores das características e a informação mútua entre elas definem os campos locais e os acoplamentos de um Hamiltoniano de vidro de spin. A dinâmica contradiabática então evolui o sistema quântico em direção a seus estados de baixa energia, e os valores esperados de um e dois corpos medidos no final tornam-se as novas características transformadas quanticamente. Essas características capturam correlações não lineares entre as entradas, e você pode alimentá-las em qualquer modelo clássico.
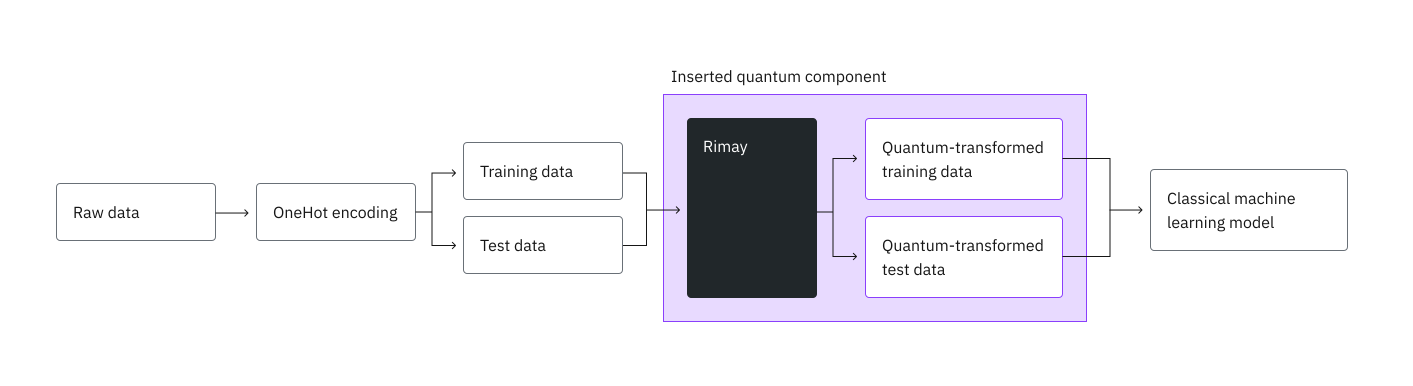
Este tutorial usa o conjunto de dados German credit do OpenML [2], com 1000 solicitantes e 20 atributos, para treinar um classificador random forest. Primeiro você estabelece uma linha de base clássica, depois envia os dados para a Rimay e, por fim, treina o mesmo tipo de modelo nas características transformadas quanticamente, sozinhas e combinadas com as características originais.
Requisitos
Antes de começar este tutorial, certifique-se de que você tem os seguintes pacotes instalados:
-
Cliente IBM Quantum Compute (
pip install qiskit-ibm-runtime) -
Qiskit Functions (
pip install qiskit-ibm-catalog) -
scikit-learn (
pip install scikit-learn) -
pandas (
pip install pandas) -
Matplotlib (
pip install matplotlib)
Você também precisa de acesso à função Rimay do Qiskit Functions Catalog.
Configuração
Importe os pacotes e defina dois auxiliares: um que treina um random forest e outro que calcula as métricas usadas ao longo do tutorial.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "pandas": "pandas", "qiskit_ibm_catalog": "qiskit-ibm-catalog", "sklearn": "scikit-learn"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
from qiskit_ibm_catalog import QiskitFunctionsCatalog
from sklearn.datasets import fetch_openml
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import (
    accuracy_score,
    f1_score,
    precision_score,
    recall_score,
    roc_auc_score,
)
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import OneHotEncoder

def train_random_forest(x, y, n_estimators, max_depth):
    """Train a random forest classifier with fixed hyperparameters."""
    model = RandomForestClassifier(
        n_estimators=n_estimators,
        max_depth=max_depth,
        min_samples_split=5,
        min_samples_leaf=1,
        max_features="sqrt",
        random_state=42,
        n_jobs=-1,
    )
    return model.fit(x, y)

def evaluate(model, x, y):
    """Return the classification metrics of a trained model on a test set."""
    y_pred = model.predict(x)
    y_proba = model.predict_proba(x)[:, 1]
    return {
        "Accuracy": accuracy_score(y, y_pred),
        "AUC": roc_auc_score(y, y_proba),
        "F1 score": f1_score(y, y_pred),
        "Precision": precision_score(y, y_pred),
        "Recall": recall_score(y, y_pred),
    }
Configurar as credenciais do IBM Quantum
Autentique-se com sua chave de API do IBM Quantum Platform, carregue a função Rimay e selecione o processador quântico menos ocupado disponível para a sua instância.
catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")
rimay = catalog.load("kipu-quantum/rimay")

backend = catalog.least_busy(operational=True, simulator=False)
print(backend.name, backend.num_qubits)
ibm_fez 156
Etapa 1: Mapear entradas clássicas para um problema quântico
A Rimay mapeia cada característica de entrada numérica para um qubit, então o primeiro passo é transformar a tabela bruta em características numéricas.
Carregar o conjunto de dados
Carregue o conjunto de dados German credit diretamente do OpenML. A coluna class contém o rótulo: good para solicitantes que pagaram o crédito e bad para os que não pagaram.
df = fetch_openml(data_id=31, as_frame=True).frame
print(df.shape)
df.head()
(1000, 21)
checking_status  duration                  credit_history  \
0              <0         6  critical/other existing credit
1        0<=X<200        48                   existing paid
2     no checking        12  critical/other existing credit
3              <0        42                   existing paid
4              <0        24              delayed previously

               purpose  credit_amount    savings_status employment  \
0             radio/tv           1169  no known savings        >=7
1             radio/tv           5951              <100     1<=X<4
2            education           2096              <100     4<=X<7
3  furniture/equipment           7882              <100     4<=X<7
4              new car           4870              <100     1<=X<4

   installment_commitment     personal_status other_parties  ...  \
0                       4         male single          none  ...
1                       2  female div/dep/mar          none  ...
2                       2         male single          none  ...
3                       2         male single     guarantor  ...
4                       3         male single          none  ...

   property_magnitude age  other_payment_plans   housing existing_credits  \
0         real estate  67                 none       own                2
1         real estate  22                 none       own                1
2         real estate  49                 none       own                1
3      life insurance  45                 none  for free                1
4   no known property  53                 none  for free                2

                  job num_dependents  own_telephone foreign_worker class
0             skilled              1            yes            yes  good
1             skilled              1           none            yes   bad
2  unskilled resident              2           none            yes  good
3             skilled              2           none            yes  good
4             skilled              2           none            yes   bad

[5 rows x 21 columns]
Codificar as características
Converta o rótulo para um valor binário e aplique codificação one-hot às 13 colunas categóricas. O código descarta a primeira categoria de cada coluna para evitar características redundantes, o que resulta em 48 características numéricas.
y = (df["class"] == "good").astype(int)

features = df.drop(columns="class")
categorical_cols = [
    col for col in features.columns if features[col].dtype.name == "category"
]
encoder = OneHotEncoder(
    sparse_output=False, handle_unknown="ignore", drop="first"
)
encoded = pd.DataFrame(
    encoder.fit_transform(features[categorical_cols]),
    columns=encoder.get_feature_names_out(categorical_cols),
    index=features.index,
)
x = pd.concat([features.drop(columns=categorical_cols), encoded], axis=1)
print(f"{x.shape[1]} features")
48 features
Dividir em conjuntos de treinamento e de teste
Separe 20% dos solicitantes como conjunto de teste. Uma divisão estratificada mantém a proporção de créditos bons e ruins igual nos dois conjuntos.
x_train, x_test, y_train, y_test = train_test_split(
    x, y, test_size=0.2, random_state=42, stratify=y
)
print(f"Training set: {x_train.shape}, test set: {x_test.shape}")
Training set: (800, 48), test set: (200, 48)
Estabelecer uma linha de base clássica
Treine um random forest nas características clássicas. Na Etapa 4, você compara as características transformadas quanticamente com as métricas dele.
baseline = train_random_forest(
    x_train, y_train, n_estimators=500, max_depth=12
)
results = {"Classical": evaluate(baseline, x_test, y_test)}
pd.DataFrame(results).T
Accuracy       AUC  F1 score  Precision    Recall
Classical     0.765  0.781071  0.845902   0.781818  0.921429
Enviar os dados para a Rimay
A Rimay lê suas entradas de arquivos CSV que você envia para a função. As características e os rótulos vão em arquivos separados. Você também envia o conjunto de teste, para que a Rimay o mapeie com o mesmo mapeamento ajustado no conjunto de treinamento.
x_train.to_csv("x_train.csv", index=False)
y_train.to_csv("y_train.csv", index=False)
x_test.to_csv("x_test.csv", index=False)

for file_name in ("x_train.csv", "y_train.csv", "x_test.csv"):
    catalog.file_upload(file_name, rimay)
Etapa 2: Otimizar o problema para execução em hardware quântico
A Rimay constrói e transpila os circuitos para o processador que você selecionar, então não há circuito para otimizar manualmente. Especifique o número de shots por circuito, dentro das seguintes restrições:
-
Cada característica precisa de um qubit, então o processador deve ter pelo menos tantos qubits quanto o conjunto de dados tem características.
-
A Rimay executa um circuito por linha, somando as linhas de treinamento e de teste. Um único job pode solicitar no máximo 10 milhões de execuções, então o número de linhas vezes
shotsdeve ficar dentro desse orçamento.
Verifique os dois limites antes de enviar o job.
Um job também deve terminar em até 24 horas, incluindo o tempo que seus circuitos esperam na fila, ou ele é interrompido sem resultado.
shots = 5000

n_rows = len(x_train) + len(x_test)
n_features = x_train.shape[1]
print(f"Qubits needed: {n_features} of {backend.num_qubits} available")
print(f"Executions: {n_rows * shots:,} of 10,000,000 allowed")
Qubits needed: 48 of 156 available
Executions: 5,000,000 of 10,000,000 allowed
Calcular o tamanho da função
Todo job é executado em um tamanho de função, S, M ou L, que seleciona os recursos de computação em que ele roda. Para a Rimay, o tamanho depende do número de linhas que um job mapeia, somando as linhas de treinamento e de teste. Se você solicitar um tamanho pequeno demais, o job falha com o erro 4600. Para os tamanhos e seus limites, consulte Function sizes no guia da Rimay.
A célula a seguir define o calculador de tamanho. Ele roda na sua máquina, lê apenas os dados que você passa para ele e não envia nada.
from os import PathLike
from typing import Any, Literal, Sequence, Sized

Size = Literal["S", "M", "L"]

# Upper bounds (inclusive) in samples.
_SMALL = 2_999
_MEDIUM = 9_999

FIT_TRANSFORM, TRANSFORM, DELETE = "fit-transform", "transform", "delete"

# Which positions of input_file hold samples, per mode. The labels in
# y_train submit no circuits of their own, so they are not counted.
SAMPLE_POSITIONS = {FIT_TRANSFORM: (0, 2), TRANSFORM: (0,)}

def calculate_function_size(problem: Sequence[Sized], **kwargs: Any) -> Size:
    """Return the size ("S", "M" or "L") required to run the function."""
    metrics = _measure(problem, **kwargs)
    if _is_small(metrics):
        return "S"
    if _is_medium(metrics):
        return "M"
    return "L"

def _measure(problem: Sequence[Sized], **kwargs: Any) -> dict:
    """The samples the job submits."""
    return {"samples": count_samples(problem, kwargs.get("mode"))}

def count_samples(problem: Sequence[Sized], mode: Any) -> int:
    """Rows across the data sets of ``problem`` that carry samples."""
    if mode == DELETE:
        return 0
    if mode not in SAMPLE_POSITIONS:
        raise ValueError(f"cannot size mode {mode!r}")
    if _is_name(problem) or (
        isinstance(problem, (list, tuple))
        and any(_is_name(data) for data in problem)
    ):
        raise TypeError(
            "pass the data, not the file name: read each input_file, e.g. with "
            "pandas.read_csv, and pass the data sets in input_file order"
        )
    if not isinstance(problem, (list, tuple)):
        raise TypeError(
            "pass a list of data sets in input_file order, e.g. [x_train, y_train], "
            f"not a single {type(problem).__name__}"
        )
    return sum(
        len(problem[i]) for i in SAMPLE_POSITIONS[mode] if i < len(problem)
    )

def _is_name(value: Any) -> bool:
    """A file name or path rather than data."""
    return isinstance(value, (str, bytes, PathLike))

def _is_small(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'S'."""
    return metrics["samples"] <= _SMALL

def _is_medium(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'M'."""
    return metrics["samples"] <= _MEDIUM
Passe os conjuntos de dados na mesma ordem dos arquivos em input_file, junto com o modo da execução:
size = calculate_function_size(
    [x_train, y_train, x_test], mode="fit-transform"
)
print(size)
S
Etapa 3: Executar usando primitivas do Qiskit
Execute a Rimay no modo fit-transform. Ela ajusta um mapeamento quântico de características em x_train.csv e y_train.csv e mapeia com ele tanto o conjunto de treinamento quanto o de teste. A ordem dos arquivos em input_file importa. Liste as características de treinamento, os rótulos de treinamento e, depois, as características de teste opcionais. Passe o tamanho que você calculou como function_size.
job = rimay.run(
    mode="fit-transform",
    input_file=[
        "x_train.csv",
        "y_train.csv",
        "x_test.csv",
    ],  # This order matters
    backend_name=backend.name,
    shots=shots,
    function_size=size,
)
print(job.job_id)
de5094df-bb17-4924-9605-d6196a4aa999
Monitorar o job
Verifique o status do job enquanto ele roda. job.result() bloqueia até que o job termine.
print(job.status())
INITIALIZING
result = job.result()
print(result["output_files"])
['de5094df-bb17-4924-9605-d6196a4aa999_xq_train.csv', 'de5094df-bb17-4924-9605-d6196a4aa999_xq_test.csv']
O resultado contém um mapping_id, que identifica o mapeamento ajustado por esta execução. Você não precisa dele neste tutorial, porque o conjunto de teste foi mapeado na mesma execução. Anote este ID se quiser mapear novas linhas mais tarde com mode="transform". É a única forma de acessar o mapeamento ajustado e, sem ele, você precisa ajustar e pagar por um novo. O mapeamento é construído para o layout de qubits deste processador, então uma execução transform posterior deve passar o mesmo backend_name.
mapping_id = result["mapping_id"]
Etapa 4: Pós-processar e retornar o resultado no formato clássico desejado
Baixar as características transformadas quanticamente
Baixe os arquivos que o job gravou, usando os nomes em output_files. Cada nome começa com o ID do job, então os arquivos desta execução continuam disponíveis depois de execuções posteriores. Passe target_name para que cada arquivo seja salvo com o seu próprio nome.
train_file, test_file = result["output_files"]
for file_name in (train_file, test_file):
    catalog.file_download(file_name, rimay, target_name=file_name)

xq_train = pd.read_csv(train_file).to_numpy()
xq_test = pd.read_csv(test_file).to_numpy()
print(f"Quantum-transformed features: {xq_train.shape[1]}")
586kiB [00:00, 1.13MiB/s]
147kiB [00:00, 336kiB/s]
Quantum-transformed features: 99
Treinar nas características transformadas quanticamente
Treine um random forest apenas nas características transformadas quanticamente.
quantum = train_random_forest(
    xq_train, y_train, n_estimators=900, max_depth=15
)
results["Quantum"] = evaluate(quantum, xq_test, y_test)
Treinar nas características clássicas e quânticas combinadas
Empilhe as características originais e as transformadas quanticamente e treine o mesmo modelo na combinação.
xh_train = np.hstack([x_train.to_numpy(), xq_train])
xh_test = np.hstack([x_test.to_numpy(), xq_test])

hybrid = train_random_forest(
    xh_train, y_train, n_estimators=900, max_depth=15
)
results["Hybrid"] = evaluate(hybrid, xh_test, y_test)
Comparar os resultados
Compare os três modelos no conjunto de teste.
comparison = pd.DataFrame(results).T
print(comparison.round(3))

comparison[["Accuracy", "AUC", "F1 score"]].T.plot.bar(rot=0, figsize=(8, 4))
plt.ylim(0.5, 1.0)
plt.ylabel("Score on the test set")
plt.title("Random forest on classical, quantum, and hybrid features")
plt.show()
Accuracy    AUC  F1 score  Precision  Recall
Classical     0.765  0.781     0.846      0.782   0.921
Quantum       0.730  0.784     0.827      0.750   0.921
Hybrid        0.730  0.791     0.825      0.756   0.907

A AUC mede o quão bem um modelo classifica créditos bons acima de ruins, independentemente de um limiar de decisão, o que a torna a métrica mais informativa neste conjunto de dados desbalanceado (70% de bons créditos). Nos benchmarks da Kipu Quantum, as características transformadas quanticamente sozinhas atingiram uma AUC semelhante à da linha de base clássica, e o modelo híbrido, que combina ambas, atingiu a maior AUC e o maior F1 score. As características transformadas quanticamente, portanto, adicionam informação que as características clássicas não fornecem sozinhas.
Limpeza (opcional)
Um mapeamento ajustado permanece disponível até você excluí-lo. Se você não quiser mapear mais dados com ele, exclua-o. Uma exclusão não faz trabalho quântico, não usa tempo de QPU e não pode ser desfeita.
# rimay.run(mode="delete", mapping_id=mapping_id).result()
{'output_files': [],
 'mode': 'delete',
 'deleted': True,
 'mapping_id': 'eUCy4EnZM7G9jYo5b2Pu-TuCXK7zX_wPTT67g9J1dVE',
 'metadata': {'version': '0.6.0', 'resource_usage': {}}}
Conclusão
O que você realizou
Neste tutorial, você realizou o seguinte:
-
Preparou um conjunto de dados real de risco de crédito com atributos categóricos e numéricos para extração quântica de características.
-
Estabeleceu uma linha de base de random forest clássico.
-
Usou a Rimay para ajustar um mapeamento quântico de características em hardware quântico e mapear os conjuntos de treinamento e de teste em uma única execução.
-
Treinou o mesmo modelo nas características transformadas quanticamente e nas combinadas, e as comparou com a linha de base.
Principais conclusões
-
A Rimay se encaixa em um pipeline de aprendizado de máquina existente como uma etapa adicional de pré-processamento. Você mantém sua preparação de dados e seu modelo clássico.
-
O número de qubits limita o número de características de entrada, e o número de linhas vezes
shotslimita o tamanho de um único job. -
Use as características transformadas quanticamente combinadas com as características originais como padrão, porque o modelo pode usar ambas.
Próximos passos
- Leia o guia da Rimay para conhecer todas as entradas, mapear novos dados com
mode="transform"e ver mais benchmarks. - Leia como a extração quântica de características foi aplicada à classificação de imagens de satélite [3].
Referências
[1] Simen, A., et al. (2025). Digitized Counterdiabatic Quantum Feature Extraction. arXiv preprint arXiv:2510.13807.
[2] Hofmann, H. (1994). Statlog (German Credit Data). OpenML dataset 31.
[3] Zhang, Q., et al. (2026). Quantum-enhanced satellite image classification. arXiv preprint arXiv:2602.18350.