Rimay Quantum Feature Extraction - uma Qiskit Function da Kipu Quantum
Veja a referência da API.
As Qiskit Functions são um recurso experimental disponível apenas para usuários dos planos IBM Quantum® Premium Plan, Flex Plan e On-Prem (por meio da IBM Quantum Platform API) Plan. Elas estão em status de versão preliminar (preview) e sujeitas a alterações.
Visão geral
O Rimay amplia os pipelines clássicos de aprendizado de máquina com recursos (features) gerados em hardware quântico. A função recebe dados tabulares clássicos e retorna um conjunto de recursos transformados quanticamente. Quando um sistema quântico processa os dados, ele gera recursos ricos que capturam relações não lineares entre as entradas. Você pode usar os recursos gerados isoladamente, ou combinados com seus recursos originais, para treinar qualquer modelo clássico. Em conjuntos de dados pequenos e médios, os recursos transformados quanticamente podem melhorar a qualidade da previsão em comparação com baselines puramente clássicos.
Esta função foi criada para os seguintes usuários:
-
Equipes de ciência de dados com um pipeline de machine learning já existente em conjuntos de dados tabulares pequenos e médios, nos quais a qualidade das previsões estagnou. Você adiciona o Rimay como uma etapa extra de pré-processamento, sem precisar construir nenhum circuito quântico por conta própria.
-
Pesquisadores que exploram métodos quânticos para tarefas de machine learning.
Descrição
O algoritmo de extração quântica de features [1] combina dois princípios do machine learning quântico. O primeiro são os feature maps quânticos, que incorporam os dados em um espaço de Hilbert de alta dimensão e, por isso, produzem representações mais expressivas. O segundo é a computação de reservatório quântico, que usa a dinâmica de um sistema quântico de muitos corpos como uma transformação não linear da entrada.
O Rimay codifica os valores das features e a informação mútua entre elas nos campos locais e nos coeficientes de acoplamento de um Hamiltoniano de vidro de spin. A dinâmica quântica contradiabática faz o sistema evoluir em direção aos seus estados de baixa energia, que contêm misturas não lineares das correlações nos dados de entrada. O Rimay extrai essas correlações medindo valores esperados de um e de dois corpos. Os valores esperados são as features transformadas quanticamente que você alimenta no seu modelo de machine learning.
Fluxo de trabalho
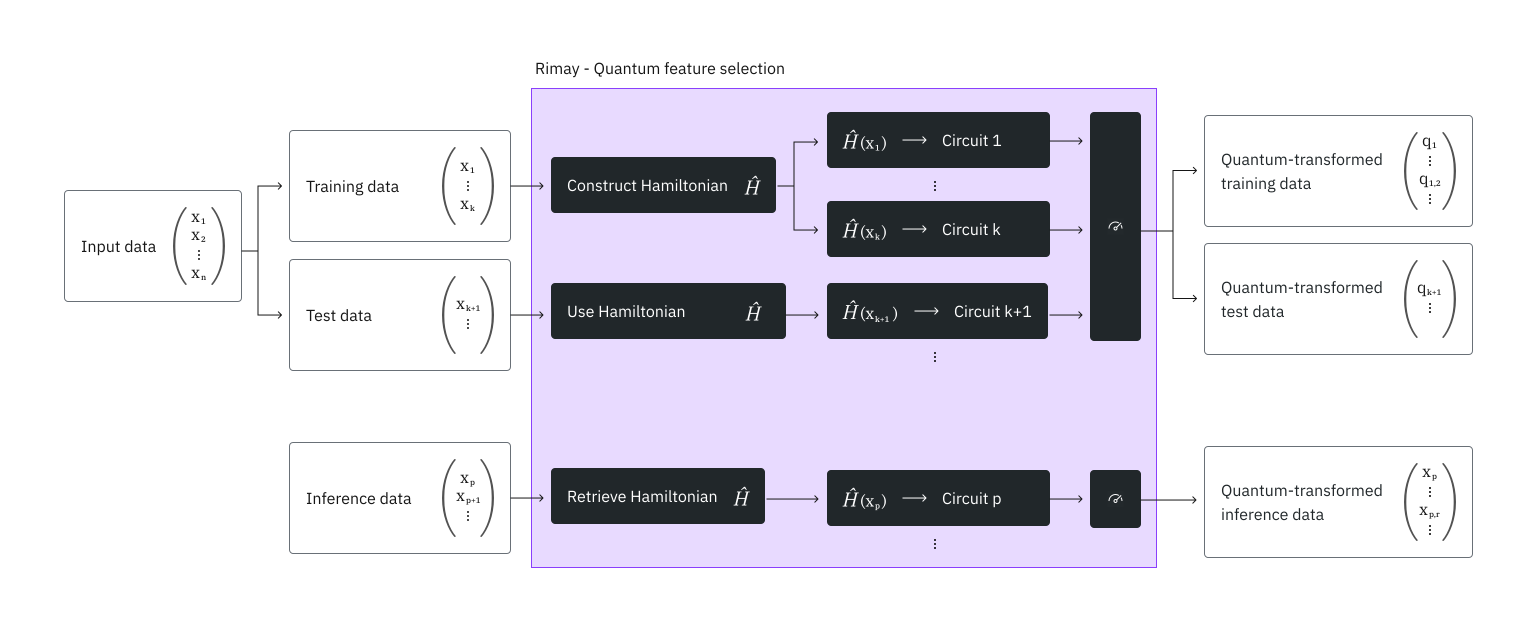
-
Pré-processe seus dados tabulares como faria para machine learning clássico. O Rimay precisa de features numéricas, então converta as features categóricas em numéricas, por exemplo com o
OneHotEncoderdo scikit-learn. -
Divida os dados em um conjunto de treino e um conjunto de teste e envie os dois para a função, como mostrado na seção Exemplo.
-
O Rimay usa os dados de treino para construir o Hamiltoniano que representa os dados. Cada feature corresponde a um qubit, e o conjunto de treino completo decide quais features, e portanto quais qubits, interagem. O Rimay armazena essa estrutura para mapear os dados de teste e os dados de inferência posteriores com o mesmo Hamiltoniano.
-
Para cada amostra, os valores das features definem os campos locais do Hamiltoniano, e a informação mútua entre as features define os coeficientes de acoplamento da estrutura da etapa 3. O Rimay digitaliza a evolução contradiabática desse Hamiltoniano em um circuito e executa os circuitos na QPU.
-
O Rimay mede as bitstrings resultantes e, em seguida, calcula os valores esperados de um corpo e os valores esperados de dois corpos dos qubits fisicamente acoplados.
-
Você baixa os valores esperados em um formato que pode alimentar diretamente no seu modelo ou combinar com suas features originais.
Por causa dessa estrutura, o número de qubits de que uma execução precisa é igual ao número de features, e o número de circuitos que ela envia é igual ao número de amostras.
Depois de ajustar um mapeamento, você pode mapear novos dados com ele, por exemplo para inferência. O Rimay então recupera o Hamiltoniano que criou durante o ajuste e constrói a partir dele os circuitos para as novas amostras.
Integre o Rimay ao seu pipeline de machine learning
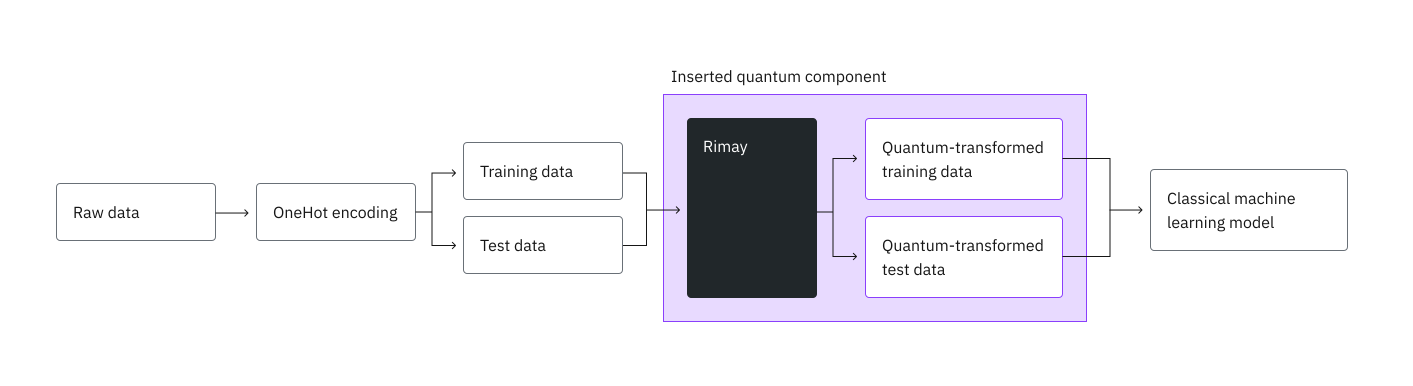
Como em um pipeline clássico, você começa pré-processando os dados brutos, por exemplo com one-hot encoding das features categóricas, e os divide em um conjunto de treino e um de teste. Em vez de alimentar os dois conjuntos diretamente no seu modelo, você os envia primeiro ao Rimay e treina seu modelo com as features transformadas quanticamente.
Benchmarks
A Kipu Quantum fez o benchmark do Rimay no conjunto de dados German credit do OpenML [2], que classifica 1000 solicitantes de crédito como bons ou maus riscos de crédito. Ele tem 13 atributos categóricos e sete numéricos. O one-hot encoding dos atributos categóricos resulta em 48 features numéricas. O benchmark reserva 20% das amostras como conjunto de teste.
Como linha de base, vários modelos clássicos foram treinados com as features clássicas. Com o Rimay, uma random forest foi treinada de duas formas: apenas com as features transformadas quanticamente (Random forest Q) e com as features transformadas quanticamente combinadas com as clássicas (Random forest H, de híbrido). A tabela mostra apenas a random forest, porque ela teve o melhor desempenho com as features transformadas quanticamente.
| Modelo | Features | Acurácia | AUC | F1 score | Precisão | Recall |
|---|---|---|---|---|---|---|
| CatBoost | Clássicas | 0.775 | 0.781 | 0.850 | 0.795 | 0.914 |
| Random forest | Clássicas | 0.765 | 0.781 | 0.846 | 0.782 | 0.921 |
| XGBoost | Clássicas | 0.760 | 0.758 | 0.835 | 0.803 | 0.871 |
| LightGBM | Clássicas | 0.770 | 0.751 | 0.840 | 0.818 | 0.864 |
| Random forest Q | Quânticas | 0.750 | 0.793 | 0.840 | 0.762 | 0.936 |
| Random forest H | Híbridas | 0.770 | 0.798 | 0.854 | 0.770 | 0.957 |
As features híbridas melhoram todas as métricas da random forest, exceto a precisão, e a random forest híbrida alcança AUC, F1 score e recall maiores que os do CatBoost com as features clássicas. O maior efeito está no recall, que sobe de 0.921 para 0.957. As features transformadas quanticamente sozinhas não alcançam a precisão dos modelos clássicos.
O conjunto de teste tem apenas 200 amostras, então prever mais uma amostra corretamente muda a acurácia em 0.005. Leia as diferenças como uma tendência que precisa de mais verificação, não como um efeito significativo. A acurácia da previsão também pode depender do ruído induzido pelo hardware nas features extraídas. Portanto, use shots suficientes para que o ruído de shot não limite o resultado.
O benchmark usou os seguintes recursos:
| Exemplo | Número de qubits | Número de amostras | Número de shots | Tempo total (min) | Uso de QPU (min) | Processador |
|---|---|---|---|---|---|---|
| German credit | 48 | 1000 | 5000 | 23 | 22 | ibm_boston |
| German credit | 48 | 1000 | 5000 | 3 | 2 | ibm_phoenix |
O número de amostras, que é o número de circuitos, determina o tempo de QPU. Use o tipo de processador Nighthawk r2, porque ele reduz muito o tempo de QPU necessário.
Entradas
O mode determina quais parâmetros uma execução precisa. Para uma descrição de cada parâmetro de entrada, consulte a referência da API.
Arquivos de entrada
-
Envie cada arquivo com
catalog.file_upload()antes de executar a função. -
Um upload substitui qualquer arquivo anterior com o mesmo nome, mesmo para um job que você enviou mas que ainda não começou. Para executar vários jobs ao mesmo tempo, dê aos arquivos de cada job nomes próprios, por exemplo
run1_x_train.csverun2_x_train.csv. -
Cada arquivo é um arquivo CSV com uma linha de cabeçalho. Cada coluna de um arquivo de features é uma feature, e todo valor deve ser numérico.
-
y_traincontém exatamente uma coluna numérica, com um rótulo por linha dex_train. Mapeie rótulos categóricos para números, por exemplo bom e mau para 1 e 0. -
x_testex_inferencedevem ter as mesmas colunas quex_train, na mesma ordem.
O mapping_id é a única forma de acessar o mapeamento produzido pelo seu ajuste, e ele não pode ser consultado nem recuperado. Ele autoriza o uso desse mapeamento, então trate-o como uma credencial e não o compartilhe. Se você o perder, precisará ajustar um novo mapeamento, o que custa mais uma execução em hardware quântico. Registre também o backend_name do ajuste, porque o mapeamento só roda nesse processador.
Limites
-
Cada feature é mapeada para um qubit, então o processador deve ter pelo menos tantos qubits quanto os seus dados têm features. Se você tiver mais features que isso, reduza-as antes com uma técnica de seleção de features.
-
Cada amostra vira um circuito, e uma execução conta as amostras de treino e de teste juntas. Uma execução pode ter no máximo 15,000 amostras.
-
Um único job pode solicitar no máximo 10 milhões de execuções, então o número de amostras vezes
shotsnão pode passar de 10 milhões. -
Um job deve terminar em até 24 horas, incluindo o tempo que seus circuitos esperam na fila do processador. Um job que demora mais é interrompido sem resultado. Em um processador ocupado, mantenha conjuntos de dados grandes bem abaixo desses limites.
Saídas
job.result() retorna um dicionário. As próprias features transformadas quanticamente são gravadas em arquivos CSV que você baixa com catalog.file_download(). Para uma descrição de cada chave do dicionário, consulte a referência da API. Para o tempo que cada fase de execução levou, consulte Metadados da execução.
Cada arquivo de saída contém uma linha por linha de entrada, na ordem do arquivo de entrada, e uma coluna por feature transformada quanticamente. As colunas cujos nomes começam com corr_ são os valores esperados de dois corpos. Os arquivos não têm coluna de rótulos. Os rótulos dos seus dados de treino permanecem no seu arquivo y_train.
Metadados da execução
resource_usage contém uma entrada para cada fase de execução pela qual a execução passou: "RUNNING: MAPPING", "RUNNING: POST_PROCESSING" e, em uma QPU, normalmente "RUNNING: WAITING_FOR_QPU". Cada entrada contém CPU_TIME, o tempo real (wall-clock) da fase em segundos, e QPU_TIME, o tempo de QPU em segundos. Em uma QPU, o tempo de QPU cobrado pela IBM é registrado em "RUNNING: MAPPING", a fase em que os circuitos foram executados.
"RUNNING: WAITING_FOR_QPU" é o tempo que seus jobs esperaram na fila da IBM. A execução obtém esse tempo dos timestamps dos jobs da IBM e não o conta em "RUNNING: MAPPING". Se a IBM não informar esses timestamps para todos os jobs, a entrada fica ausente e a espera passa a fazer parte de "RUNNING: MAPPING".
A IBM® conclui o cálculo de uso algum tempo depois que um job termina. A execução espera até cerca de um minuto por ele. O uso que ainda estiver sendo calculado depois desse tempo não é incluído em QPU_TIME, e o uso final é mostrado na IBM Quantum Platform. Se a execução não conseguir ler o uso da IBM, QPU_TIME é None.
Por exemplo:
"metadata": {
    "version": "0.3.0",
    "resource_usage": {
        "RUNNING: MAPPING": {"CPU_TIME": 12.4, "QPU_TIME": 6.0},
        "RUNNING: WAITING_FOR_QPU": {"CPU_TIME": 28.8, "QPU_TIME": 0.0},
        "RUNNING: POST_PROCESSING": {"CPU_TIME": 0.3, "QPU_TIME": 0.0},
    },
}
Primeiros passos
Autentique-se usando sua chave de API da IBM Quantum Platform e selecione a Qiskit Function da seguinte forma:
O código a seguir pressupõe que você salvou suas credenciais. Se não salvou, siga as instruções em Instalar o cliente do Qiskit Functions Catalog para salvar sua conta com sua chave de API.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"pandas": "pandas", "qiskit_ibm_catalog": "qiskit-ibm-catalog"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit_ibm_catalog import QiskitFunctionsCatalog

catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")

# Verify that you have access to the function
catalog.list()
[QiskitFunction(kipu-quantum/rimay)]
# Access function
rimay = catalog.load("kipu-quantum/rimay")
Tamanhos da função
Cada job roda em um tamanho — S, M ou L. Se o tamanho especificado for pequeno demais, o job é rejeitado. Se o tamanho for maior que o necessário, o job roda em um perfil de computação maior do que o trabalho exige.
O tamanho de um job do Rimay depende do número de amostras que ele mapeia: as linhas de x_train e x_test para fit-transform, e as linhas de x_inference para transform. Os rótulos em y_train não contam, e uma execução delete não mapeia nenhuma amostra.
| Tamanho | Amostras por job | Perfil de computação | vCPU | RAM |
|---|---|---|---|---|
S | Até 2,999 | 8x32 | 8 | 32 GB |
M | 3,000 a 9,999 | 8x32 | 8 | 32 GB |
L | 10,000 a 15,000 | 16x128 | 16 | 128 GB |
O número de amostras é o único critério. Um tamanho não muda nada além do perfil de computação: os limites de features, amostras e shots são os mesmos para todos os tamanhos. S e M rodam no mesmo perfil de computação e diferem no número de amostras que cada um cobre.
O padrão é M, usado quando um job não solicita um tamanho. Um job com mais de 9,999 amostras deve, portanto, solicitar L.
Você também pode ler o mapeamento na própria função com rimay.sizes_map, e o tamanho em que um job roda quando não solicita nenhum com rimay.default_size.
Calcule o tamanho antes de enviar
Execute isto nas suas próprias entradas. Ele apenas as lê e não faz mais nada: nenhum job é enviado e nada é reservado, então você pode chamá-lo quantas vezes quiser.
Passe os próprios conjuntos de dados, não os nomes dos arquivos, na mesma ordem de input_file, junto com o mode da execução. A etapa 2 do exemplo mostra a chamada.
from os import PathLike
from typing import Any, Literal, Sequence, Sized

Size = Literal["S", "M", "L"]

# Upper bounds (inclusive) in samples.
_SMALL = 2_999
_MEDIUM = 9_999

FIT_TRANSFORM, TRANSFORM, DELETE = "fit-transform", "transform", "delete"

# Which positions of input_file hold samples, per mode. The labels in
# y_train submit no circuits of their own, so they are not counted.
SAMPLE_POSITIONS = {FIT_TRANSFORM: (0, 2), TRANSFORM: (0,)}

def calculate_function_size(problem: Sequence[Sized], **kwargs: Any) -> Size:
    """Return the size ("S", "M" or "L") required to run the function."""
    metrics = _measure(problem, **kwargs)
    if _is_small(metrics):
        return "S"
    if _is_medium(metrics):
        return "M"
    return "L"

def _measure(problem: Sequence[Sized], **kwargs: Any) -> dict:
    """The samples the job submits."""
    return {"samples": count_samples(problem, kwargs.get("mode"))}

def count_samples(problem: Sequence[Sized], mode: Any) -> int:
    """Rows across the data sets of ``problem`` that carry samples."""
    if mode == DELETE:
        return 0
    if mode not in SAMPLE_POSITIONS:
        raise ValueError(f"cannot size mode {mode!r}")
    if _is_name(problem) or (
        isinstance(problem, (list, tuple))
        and any(_is_name(data) for data in problem)
    ):
        raise TypeError(
            "pass the data, not the file name: read each input_file, e.g. with "
            "pandas.read_csv, and pass the data sets in input_file order"
        )
    if not isinstance(problem, (list, tuple)):
        raise TypeError(
            "pass a list of data sets in input_file order, e.g. [x_train, y_train], "
            f"not a single {type(problem).__name__}"
        )
    return sum(
        len(problem[i]) for i in SAMPLE_POSITIONS[mode] if i < len(problem)
    )

def _is_name(value: Any) -> bool:
    """A file name or path rather than data."""
    return isinstance(value, (str, bytes, PathLike))

def _is_small(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'S'."""
    return metrics["samples"] <= _SMALL

def _is_medium(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'M'."""
    return metrics["samples"] <= _MEDIUM
Se o tamanho for pequeno demais, o job falha com o erro 4600 e a mensagem informa o tamanho a ser usado. Se for maior que o necessário, o job roda normalmente e registra um evento de aviso 4601.
Exemplo
Este exemplo mostra como enviar dados, executar a função e recuperar as features transformadas quanticamente. Para um exemplo de ponta a ponta que inclui o pré-processamento e o treinamento do modelo clássico, consulte o tutorial.
1. Envie os dados
Este exemplo usa um pequeno conjunto de dados sintético com quatro features numéricas e um rótulo binário, de modo que uma execução precisa de apenas quatro qubits e termina rapidamente. A próxima célula o grava em quatro arquivos CSV: as features de treino, os rótulos de treino, as features de teste e as features da etapa 4 deste exemplo. Para usar seus próprios dados, grave seus conjuntos de treino e teste pré-processados em arquivos com o mesmo layout.
from pathlib import Path

Path("x_train.csv").write_text("""f0,f1,f2,f3
0.7227,1.3355,1.9595,2.5562
0.2731,0.5779,0.8983,1.1624
0.1139,0.1817,0.2163,0.2426
0.0341,0.1311,0.0854,0.09
0.8996,1.6951,2.497,3.3407
0.9669,1.8906,2.7705,3.6569
0.6366,1.2821,1.8793,2.4602
0.7718,1.4979,2.2223,2.933
0.5465,1.1008,1.67,2.2195
0.9475,1.9423,2.8942,3.8199
0.8829,1.6842,2.4703,3.2865
0.0675,0.0365,0.0705,0.0162
""")
Path("y_train.csv").write_text("label\n1\n0\n0\n0\n1\n1\n0\n1\n0\n1\n1\n0\n")
Path("x_test.csv").write_text("""f0,f1,f2,f3
0.543,1.0786,1.5684,2.0607
0.9928,1.9037,2.9302,3.8422
0.2269,0.3637,0.4628,0.597
0.9896,1.9511,2.8913,3.8208
""")
Path("x_inference.csv").write_text("""f0,f1,f2,f3
0.2708,0.542,0.8506,1.0897
0.3585,0.6025,0.9517,1.2609
0.8871,1.6559,2.4577,3.2992
""")
95
Envie os arquivos de treino e de teste. Você envia x_inference.csv na etapa 4.
for file_name in ("x_train.csv", "y_train.csv", "x_test.csv"):
    catalog.file_upload(file_name, rimay)
2. Execute a função
Calcule o tamanho da execução a partir dos dados que você enviou, com a calculadora de Tamanhos da função.
import pandas as pd

x_train = pd.read_csv("x_train.csv")
y_train = pd.read_csv("y_train.csv")
x_test = pd.read_csv("x_test.csv")

size = calculate_function_size(
    [x_train, y_train, x_test], mode="fit-transform"
)
print(size)
S
Selecione um processador com pelo menos tantos qubits quanto os seus dados têm features e execute a função no modo fit-transform com esse tamanho. Os dados de exemplo têm quatro features, então qualquer processador da IBM Quantum pode executá-lo.
backend = catalog.least_busy(operational=True, simulator=False)

job = rimay.run(
    mode="fit-transform",
    input_file=["x_train.csv", "y_train.csv", "x_test.csv"],
    backend_name=backend.name,
    shots=5000,
    function_size=size,
)
print(job.job_id)
85dabc9f-a769-4f4a-8e92-f3be73f85ca2
Verifique o status do workload ou retorne os resultados da seguinte forma:
# Monitor the job status
job.status()
'DONE'
result = job.result()

# Keep both: the mapping_id is the only handle on the mapping this run
# fitted, and the mapping runs only on the processor it was fitted on.
mapping_id = result["mapping_id"]
fit_backend_name = result["backend_name"]
3. Recupere os resultados
Baixe as features transformadas quanticamente. Passe target_name para que cada arquivo seja salvo com seu próprio nome.
for file_name in result["output_files"]:
    catalog.file_download(file_name, rimay, target_name=file_name)
693iB [00:00, 171kiB/s]
254iB [00:00, 111kiB/s]
4. Mapeie novos dados
Depois de treinar seu modelo, mapeie novos dados com o mapeamento ajustado, por exemplo para executar inferência. Este exemplo mapeia x_inference.csv, que a primeira célula deste exemplo gravou. Passe o mapping_id que o ajuste retornou, para que as novas linhas sejam mapeadas com o mesmo mapeamento, em vez de um novo.
Um mapeamento é construído para o layout de qubits de um processador, então passe o mesmo backend_name do ajuste, que o ajuste retornou em result["backend_name"]. Não use least_busy() para escolher o processador, porque ele pode retornar outro. O Rimay rejeita qualquer outro processador antes de enviar qualquer coisa. A contagem de shots também vem do ajuste.
catalog.file_upload("x_inference.csv", rimay)

x_inference = pd.read_csv("x_inference.csv")
size = calculate_function_size([x_inference], mode="transform")

job = rimay.run(
    mode="transform",
    input_file=["x_inference.csv"],
    # The processor the mapping was fitted on
    backend_name=fit_backend_name,
    shots=5000,
    mapping_id=mapping_id,
    function_size=size,
)
# Monitor the job status
job.status()
'DONE'
result = job.result()

for file_name in result["output_files"]:
    catalog.file_download(file_name, rimay, target_name=file_name)
202iB [00:00, 73.5kiB/s]
5. Exclua um mapeamento
Quando você não precisar mais de um mapeamento ajustado, exclua-o. Uma execução delete não faz nenhum trabalho quântico, então não precisa de processador, shots nem tamanho de função. Você não pode desfazer uma exclusão. Depois da exclusão, o mapping_id não se refere mais a nada, e uma execução transform com ele falha.
job = rimay.run(mode="delete", mapping_id=mapping_id)
job.result()
{'output_files': [],
 'mode': 'delete',
 'deleted': True,
 'mapping_id': '30L40joyUPYfnvgwo2d7MXXSzqvHkggR-Kzn81wfIYw',
 'metadata': {'version': '0.6.0', 'resource_usage': {}}}
Obtenha mensagens de erro
Se o status do seu workload for ERROR, use job.error_message() para obter a mensagem de erro, da seguinte forma:
job = rimay.run(
    mode="fit-transform",
    input_file=["x_train.csv", "y_train.csv"],
    backend_name=backend.name,
    shots=0,
)
job.error_message()
Todo erro que o Rimay informa traz um código dos códigos de erro da IBM Quantum, uma mensagem e uma solução que indica o valor que você passou e o valor permitido. A tabela a seguir lista os erros mais comuns:
| Código | Causa |
|---|---|
1221 | Um parâmetro está ausente ou tem o tipo errado, mode não é válido, um arquivo citado em input_file não foi enviado, os arquivos não correspondem entre si, uma feature não é numérica ou o mapping_id não corresponde a um mapeamento armazenado. |
1221 | Uma execução "transform" cita um backend_name diferente do ajuste que produziu seu mapeamento. |
1216 | Sua instância não tem nenhum processador com o backend_name que você passou. A solução lista os processadores que ela tem. |
1200 | Sua chave de API não tem acesso à instância sob a qual o job roda. |
3200 | backend_name não começa com ibm_. |
4500 | Os dados têm mais features do que o processador tem qubits. |
6000 | O número de amostras vezes shots excede 10 milhões de execuções. |
6001 | shots é menor que 1. |
6002 | Os dados têm mais amostras do que uma execução permite. |
Casos de uso
Em classificação tabular em conjuntos de dados pequenos e médios, a Kipu Quantum aplicou a extração quântica de features ao seguinte:
Além de dados tabulares, redes neurais congeladas podem transformar imagens em features numéricas, que a extração quântica de features então mapeia em features transformadas quanticamente:
Obtenha suporte
Para suporte, entre em contato com support@kipu-quantum.com.
Próximos passos
-
Acesse a referência da API desta Qiskit Function.
-
Experimente o tutorial Classifique risco de crédito com a extração quântica de features Rimay da Kipu Quantum.
Referências
[1] Simen, A., et al. (2025). Digitized Counterdiabatic Quantum Feature Extraction. arXiv preprint arXiv:2510.13807.
[2] Hofmann, H. (1994). Statlog (German Credit Data). OpenML dataset 31.
[3] Zhang, Q., et al. (2026). Quantum-enhanced satellite image classification. arXiv preprint arXiv:2602.18350.
Informações adicionais
Rimay é uma palavra quéchua que significa "explicar".