Aprenda estados quânticos ruidosos com classical shadows
Estimativa de uso: 34 minutos em um processador Heron r2 (OBSERVAÇÃO: esta é apenas uma estimativa. Seu tempo de execução pode variar.)
Resultados de aprendizado
-
Coletar medições aleatorizadas em um processador quântico IBM® a partir do Julia e salvá-las para análise posterior
-
Verificar nos dados de medição a presença de qubits e portas defeituosos antes do aprendizado
-
Ajustar um modelo de operador de produto de matrizes (MPO) de um estado ruidoso a classical shadows
-
Validar o modelo em medições reservadas e compará-lo com o circuito ideal
Pré-requisitos
-
Classical shadows, conforme apresentadas no tutorial Shadow tomography of the Greenberger-Horne-Zeilinger (GHZ) state
-
Matrizes densidade e estados mistos, abordados em Basics of quantum information
-
Execução de circuitos a partir do Julia com
Qiskit.jleQiskitIBMRuntime.jl, apresentada no tutorial Simulate time evolution of the transverse-field Ising model
Contexto
Em um processador quântico real, o ruído transforma o estado puro que um circuito foi projetado para preparar em um estado misto . A tomografia completa de estado quântico pode reconstruir , mas o número de medições de que ela precisa cresce exponencialmente com o número de qubits. Votto et al. [1], em vez disso, aprenderam um modelo compacto de para até 96 qubits a partir de medições aleatorizadas. Este tutorial segue o fluxo de trabalho deles.
Em uma medição aleatorizada [2], cada qubit é rotacionado por um unitário aleatório independente e depois medido na base computacional. Um sorteio das rotações é chamado de configuração de medição, e cada configuração é repetida por shots. Um shot com bits de resultado fornece a classical shadow [3]
cuja média sobre configurações e shots é . O tutorial de pré-requisito sorteia cada das três bases de Pauli; este tutorial, como o artigo, sorteia os uniformemente entre todos os unitários de um qubit (aleatórios de Haar), e a mesma fórmula se aplica.
As shadows estimam propriedades de poucos qubits por vez. O artigo as combina em um operador de produto de matrizes (MPO), que escreve a matriz densidade como uma cadeia de tensores pequenos, um por qubit; estados ruidosos com correlações de curto alcance precisam apenas de ligações (bonds) pequenas entre tensores vizinhos. Como no algoritmo de grupo de renormalização da matriz densidade (DMRG), o aprendizado varre a cadeia e atualiza um tensor por vez, de modo que o modelo corresponda às shadows na janela de qubits centrada nesse tensor (Equação 4 do artigo). A dimensão de bond permanece fixa durante essas atualizações, então o aprendizado nunca trunca o modelo. Como os dados entram apenas por essas janelas, o número de configurações necessárias não cresce com o comprimento da cadeia.
As configurações são divididas em um conjunto de treinamento e um conjunto de teste. No conjunto de teste, o artigo estima a fidelidade máxima entre e o modelo ,
Medir diretamente exigiria um número exponencial de medições. Em vez disso, o artigo assume a condição de fatoração aproximada (AFC): as correlações em decaem em poucos qubits, de modo que sobreposições e purezas globais se fatoram em termos sobre blocos de qubits vizinhos. A pureza também fornece a entropia de Rényi-2 , que mede o quanto o estado é misto.
O artigo prepara o estado kicked-Ising de profundidade
em 96 qubits do ibm_brisbane, um processador Eagle, com 2.048 configurações de 1.024 shots para . A Figura 1(c,d) do artigo relata dois resultados para :
-
O modelo aprendido atinge com o estado experimental em , muito acima da sobreposição do estado ideal com o experimento.
-
A entropia cresce linearmente, , e a entropia do modelo concorda com uma estimativa independente obtida do conjunto de teste.
Este tutorial verifica os dois resultados, primeiro em uma simulação de oito qubits em que as respostas exatas são conhecidas e depois em uma nova execução de 96 qubits no ibm_fez, um processador Heron r2. O aprendizado é uma implementação independente em Julia das equações do artigo e de seu material suplementar.
Requisitos
Este tutorial requer macOS ou Linux, porque o Qiskit.jl ainda não oferece suporte ao Windows (Qiskit.jl issue #15). Você também precisa do seguinte:
-
Julia 1.11, da página de download do Julia ou com
juliaup add 1.11, e o pacoteIJulia:julia -e 'using Pkg; Pkg.add("IJulia")' -
Para o exemplo de hardware, uma conta da IBM Quantum® Platform com acesso a uma QPU com pelo menos 96 qubits, e credenciais salvas. Sem uma conta, você pode executar o exemplo de hardware a partir das medições salvas da execução no
ibm_fezque produziu os resultados deste tutorial. As outras seções rodam sem conta.
O notebook usa Qiskit.jl e QiskitIBMRuntime.jl para construir e executar circuitos, RandomMeas.jl [4] para medições aleatorizadas (ele também fornece ITensors.jl e ITensorMPS.jl), além de NPZ.jl, JSON.jl e Plots.jl. Este tutorial foi testado com Qiskit.jl 0.6.1, QiskitIBMRuntime.jl 0.3.2 e RandomMeas.jl 0.3.1.
Há duas maneiras de configurar o ambiente:
-
Opção 1: Instale as versões compatíveis mais recentes dos pacotes em um ambiente temporário. Execute a célula a seguir sem alterações.
-
Opção 2: Reproduza exatamente o ambiente testado. Defina
download_toml_files = truena célula a seguir. A célula baixaProject.tomleManifest.tomldo repositório da documentação para uma pastaenv_tutorial/classical-shadows/ao lado deste notebook e depois instala a versão exata de cada pacote registrada no manifesto, incluindo dependências indiretas. Para mais detalhes, consulte a documentação do Julia sobre esses arquivos.
using Pkg
using Downloads

download_toml_files = false

if !download_toml_files
    # Option 1: Install the latest compatible versions into a temporary environment
    Pkg.activate(mktempdir(); io=devnull)
    Pkg.add([
        PackageSpec(name="Qiskit", version="0.6"),
        PackageSpec(name="QiskitIBMRuntime", version="0.3"),
        PackageSpec(name="RandomMeas", version="0.3"),
        PackageSpec(name="NPZ"),
        PackageSpec(name="JSON"),
        PackageSpec(name="Plots"),
    ]; io=devnull)
else
    # Option 2: Install the exact tested versions recorded in Project.toml and Manifest.toml
    base_url = "https://raw.githubusercontent.com/Qiskit/documentation/main/docs/tutorials/assets/classical-shadows/julia"
    env_dir = joinpath(@__DIR__, "env_tutorial", "classical-shadows")
    mkpath(env_dir)
    for file in ("Project.toml", "Manifest.toml")
        Downloads.download("$base_url/$file", joinpath(env_dir, file))
    end
    Pkg.activate(env_dir; io=devnull)
    Pkg.instantiate(; io=devnull)
end
Configuração
using RandomMeas  # also loads ITensors and ITensorMPS
using Qiskit, QiskitIBMRuntime
using Random, LinearAlgebra, Statistics
using Downloads, SHA, NPZ, JSON, Plots

# Download the helper module that implements the learner, unless a copy exists
docs_url = "https://raw.githubusercontent.com/Qiskit/documentation/main"
helper_file = joinpath(@__DIR__, "env_tutorial", "classical-shadows", "mpo_learning.jl")
if !isfile(helper_file)
    mkpath(dirname(helper_file))
    helper_url = "$docs_url/docs/tutorials/assets/classical-shadows/julia/mpo_learning.jl"
    Downloads.download(helper_url, helper_file)
end
include(helper_file)
using .ShadowMPOLearning
BLAS.set_num_threads(1)  # the learner multiplies many small matrices
O módulo auxiliar mpo_learning.jl, que a célula de configuração baixa, implementa o aprendizado. O tutorial chama as seguintes funções dele:
| Função | Finalidade |
|---|---|
kicked_ising_reference(N, D; depolarization) | MPO exato do estado kicked-Ising ideal, ou do estado após ruído despolarizante local |
split_settings(group; seed, train_fraction) | Atribui aleatoriamente as configurações de medição aos conjuntos de treinamento e de teste (metade para cada, por padrão) |
training_marginals(train; ell, prior) | Estimativas por shadows de cada janela de aprendizado, apenas a partir das configurações de treinamento |
fitted_prior(ideal, train) | Prior para medições aleatorizadas comuns (CRM), ajustado à pureza medida de cada janela, como no artigo |
learn_mpo(marginals, N; ell, maxbond, sweeps) | Varre a cadeia com a atualização de um sítio do artigo, começando do estado maximamente misto |
max_fidelity(a, b), mpo_overlap(a, b) | exato e entre dois MPOs |
afc_estimate, afc_statistics, afc_prefix_curve | Estimativas AFC de e a partir das configurações de teste, com barras de erro jackknife |
O aprendizado armazena o MPO na base de Pauli. Isso mantém o modelo hermitiano com traço unitário, mas não o força a ser semidefinido positivo, então o notebook informa o quanto seus autovalores se tornam negativos.
Exemplo em simulador de pequena escala
Comece com um sistema pequeno o bastante para calcular tudo exatamente: o estado kicked-Ising de profundidade um em oito qubits, com 12% de ruído despolarizante local para modelar o hardware. Como o estado ruidoso é conhecido, você pode comparar diretamente o modelo aprendido com ele.
Etapa 1: Mapear entradas clássicas para um problema quântico
A função kicked_ising_reference retorna o estado exato como um MPO. Com depolarization=0.12, o vetor de Bloch de cada qubit encolhe 12% após o circuito.
N = 8
ideal = kicked_ising_reference(N, 1)
rho = kicked_ising_reference(N, 1; depolarization=0.12)
println("Purity of the noisy state: ", round(mpo_overlap(rho, rho), digits=3))
println("F_max between the noisy and ideal states: ", round(max_fidelity(rho, ideal), digits=3))
Purity of the noisy state: 0.327
F_max between the noisy and ideal states: 0.56
Etapa 2: Otimizar o problema para execução em hardware quântico
Este exemplo amostra os resultados de medição de forma clássica, então não há circuito para transpilar. O exemplo de hardware cobre essa etapa.
Etapa 3: Executar usando primitivas do Qiskit
Use RandomMeas.jl para sortear 2.048 configurações de medição aleatórias de Haar e amostrar 256 shots de cada uma, e depois divida as configurações igualmente em conjuntos de treinamento e de teste. Divida por configuração, e não por shot: shots da mesma configuração compartilham suas rotações, então não são independentes.
Random.seed!(20260921)
sites = siteinds("Qubit", N)
settings = [LocalUnitaryMeasurementSetting(N; site_indices=sites, ensemble=Haar) for _ in 1:2048]
measurements = MeasurementGroup(to_itensor_mpo(rho, sites), settings, 256)
split = split_settings(measurements; seed=20260921)
println(length(split.train_ids), " training settings, ", length(split.test_ids), " testing settings")
1024 training settings,
1024 testing settings
Etapa 4: Pós-processar e retornar o resultado no formato clássico desejado
Aprenda o modelo com os parâmetros de profundidade um do artigo: janelas que se estendem qubits de cada lado do tensor atualizado, dimensão de bond 4 e 20 varreduras a partir do estado maximamente misto. A primeira varredura atualiza pares de tensores vizinhos, o que permite que a dimensão de bond cresça de 1 para 4; cada varredura seguinte atualiza um tensor por vez nessa dimensão de bond fixa.
Para reduzir o ruído estatístico das shadows, o artigo usa medições aleatorizadas comuns (CRM) [5]. Para cada configuração, ele subtrai a shadow média que um palpite prévio do estado produziria na mesma configuração e depois soma de volta o valor exato do prior. A correção tem média zero, então o prior muda o tamanho do erro estatístico, mas não aquilo que é estimado. Aqui, o prior é o estado ideal com 10% de despolarização local, próximo dos 12% verdadeiros. No hardware, o nível de ruído é desconhecido, então o exemplo de hardware ajusta o prior às purezas medidas, como faz o artigo.
prior = kicked_ising_reference(N, 1; depolarization=0.10)
marginals = training_marginals(split.train; ell=2, prior)
fit = learn_mpo(marginals, N; ell=2, maxbond=4, sweeps=20)
sigma = fit.model
plot([h.sweep for h in fit.history], [h.local_loss for h in fit.history];
    xlabel="sweep", ylabel="mean squared residual", label="training windows",
    size=(680, 320), left_margin=5Plots.mm, bottom_margin=5Plots.mm)
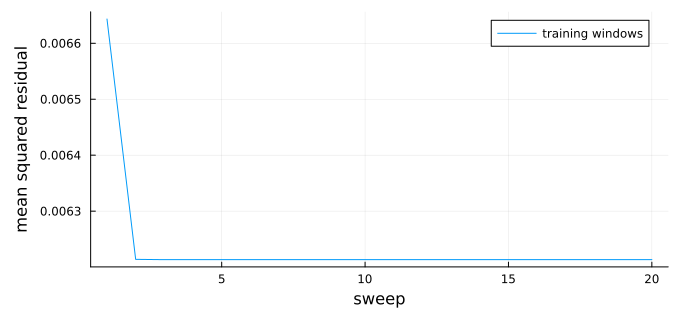
O resíduo mede o quão distantes as janelas do modelo estão das shadows de treinamento. Ele cai quando as atualizações de um sítio começam, na segunda varredura, e depois permanece aproximadamente constante em vez de chegar a zero, porque as shadows contêm ruído estatístico que um modelo com dimensão de bond pequena não consegue reproduzir.
Como este estado é conhecido, você pode comparar o modelo aprendido com ele exatamente e também comparar com ele os dois palpites mais simples: o prior CRM e o estado ideal.
eigenvalues = eigvals(Hermitian(dense_operator(sigma)))
println("F_max with the noisy state")
println("  learned model: ", round(max_fidelity(rho, sigma), digits=3))
println("  CRM prior:     ", round(max_fidelity(rho, prior), digits=3))
println("  ideal state:   ", round(max_fidelity(rho, ideal), digits=3))
println("Most negative eigenvalue of the model: ", round(minimum(eigenvalues), digits=4))
println("Total negative eigenvalue weight:      ", round(-sum(min.(eigenvalues, 0)), digits=4))
F_max with the noisy state
learned model: 0.993
  CRM prior:     0.911
  ideal state:   0.56
Most negative eigenvalue of the model: -0.0076
Total negative eigenvalue weight:      0.0348
O modelo aprendido está mais próximo do estado ruidoso do que o prior ou o estado ideal, então ele aprendeu o ruído a partir dos dados. Seus pequenos autovalores negativos vêm do número finito de medições.
No hardware, o estado é desconhecido, então você estima a partir das configurações de teste. O AFC divide a cadeia em blocos de qubits e aproxima a pureza por
e pela mesma razão de sobreposições locais. Com , os dois blocos cobrem todos os oito qubits e a fórmula é exata; com , ela depende da hipótese de fatoração. As barras de erro jackknife, que deixam de fora uma configuração de teste por vez, cobrem apenas o erro estatístico dos dados de teste, não a aleatoriedade do treinamento nem a aproximação do AFC.
for k in (2, 4)
    estimate = afc_estimate(sigma, split.test; k, statistics=afc_statistics(split.test, k; prior))
    println("k = $k: held-out F_max = ", round(estimate.fidelity, digits=3), " ± ",
        round(estimate.fidelity_sem, digits=3))
end
println("Exact F_max:              ", round(max_fidelity(rho, sigma), digits=3))
k = 2: held-out F_max = 0.966
± 0.036
k = 4: held-out F_max =
0.958 ± 0.049
Exact F_max:              0.993
As duas estimativas reservadas concordam com o valor exato dentro de suas barras de erro.
Exemplo de hardware em larga escala
Agora execute o experimento em uma cadeia de 96 qubits do ibm_fez, um processador Heron r2. Assim como o ibm_brisbane, ele tem um mapa de acoplamento heavy-hex e um nível de ruído semelhante.
Coletar os dados exige 1.024 jobs do Sampler e cerca de 34 minutos de tempo de QPU. Se você não tem acesso a uma QPU com pelo menos 96 qubits, ou se a fila está longa, execute o exemplo de hardware a partir das medições registradas no ibm_fez em 27 de setembro de 2026, que produziram os resultados mostrados neste tutorial. Com use_saved_data = true, o notebook baixa essas medições (15 MB) do Zenodo [6] no Passo 1 e pula o envio de jobs no Passo 3. Para coletar seus próprios dados, defina-o como false.
use_saved_data = true; # set to false to collect new measurements on hardware
Passo 1: Mapear entradas clássicas para um problema quântico
Cada configuração precisa de um circuito: o circuito kicked-Ising, uma porta em cada qubit para e uma medição de todos os qubits. Amostrar , com , e uniformes em , torna aleatória de Haar. A função u3_matrix retorna a matriz de , que o Passo 4 usa.
O orçamento é de 1.024 configurações de 1.024 shots, metade do número de configurações do artigo, divididas igualmente entre treinamento e teste. Com dados salvos, a célula carrega os ângulos registrados. Caso contrário, ela sorteia novos ângulos e os salva antes de você enviar qualquer coisa, porque não é possível analisar os resultados sem eles. Se o arquivo já existe, a célula o carrega, para que os ângulos ainda correspondam aos resultados salvos depois que você reiniciar a sessão.
"Matrix of the U(θ, ϕ, λ) gate, as used by `qc.u` in Qiskit."
u3_matrix(θ, ϕ, λ) = [cos(θ/2)              -exp(im*λ)*sin(θ/2);
                      exp(im*ϕ)*sin(θ/2)    exp(im*(ϕ + λ))*cos(θ/2)]

"Angles (θ, ϕ, λ) for which `u3_matrix(θ, ϕ, λ)` is a Haar-random unitary."
random_u3_angles() = (2asin(sqrt(rand())), 2π*rand(), 2π*rand())

N_hw, NU_hw, NM_hw = 96, 1024, 1024
data_directory = joinpath(@__DIR__, "classical-shadows-data")
saved_file = joinpath(data_directory, "ibm-fez-run.npz")
run_directory = joinpath(data_directory, "new-run")
settings_file = joinpath(run_directory, "settings.npz")
if use_saved_data
    saved_url = "https://zenodo.org/records/24116174/files/ibm-fez-run.npz?download=1"
    saved_sha256 = "c42f4d8d42e5083e9e152b4fec0846884ebe3be003e5ab528deebf4f00c9fe50"
    if !isfile(saved_file)
        mkpath(data_directory)
        println("Downloading the saved ibm_fez run (15 MB)...")
        Downloads.download(saved_url, saved_file * ".part")
        mv(saved_file * ".part", saved_file)
    end
    bytes2hex(open(sha256, saved_file)) == saved_sha256 ||
        error("$saved_file is incomplete or corrupted; delete it and run this cell again")
    saved_run = npzread(saved_file)
    angles = saved_run["angles"]
elseif isfile(settings_file)
    angles = npzread(settings_file)["angles"]
else
    mkpath(joinpath(run_directory, "outcomes"))
    Random.seed!(20260927)
    angles = Array{Float64}(undef, NU_hw, N_hw, 3)
    for r in 1:NU_hw, i in 1:N_hw
        angles[r, i, :] .= random_u3_angles()
    end
    npzwrite(settings_file, Dict("angles" => angles))
end
println("Measurement settings: ", size(angles, 1), " × ", size(angles, 2), " qubits")
Measurement settings: 1024
× 96 qubits
Passo 2: Otimizar o problema para execução em hardware quântico
Uma cadeia é tão boa quanto seu pior qubit, então escolha você mesmo os 96 qubits físicos. A função transpile do Qiskit.jl ainda não aceita um layout inicial fixo e, em um teste no ibm_phoenix, o layout que ela escolheu incluía um qubit com 51% de erro de leitura. A cadeia a seguir é o caminho de 96 qubits no mapa de acoplamento do ibm_fez que o layout sensível a erros da função transpile do Qiskit em Python (com optimization_level=3) selecionou a partir dos dados de calibração de 27 de setembro de 2026. Seu erro de leitura médio é de 1,6%, mas uma rede heavy-hex tem poucos caminhos de 96 qubits, e este inclui o qubit 35, que tem 15% de erro de leitura. As calibrações mudam, então escolha uma nova cadeia a partir dos dados de calibração atuais antes de executar em outro dia ou em outra QPU.
Para manter essa cadeia, escreva os circuitos diretamente em portas nativas em vez de transpilá-los. Uma porta é igual a a menos de uma fase global. Essa decomposição cobre tanto as rotações aleatórias quanto o kick . A porta é igual a uma porta CZ seguida de nos dois qubits, a menos de uma fase global. Como essas portas são diagonais, elas comutam com as portas CZ, então cada qubit acumula um por ligação antes de sua rotação de medição.
num_device_qubits = 156
# Physical qubits of ibm_fez, in IBM numbering, forming the chain
chain_physical = [
    2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15, 19, 35, 34, 33, 39, 53, 54, 55, 59, 75, 74,
    73, 79, 93, 94, 95, 99, 115, 114, 113, 119, 133, 132, 131, 130, 129, 128, 127, 137, 147, 146,
    145, 144, 143, 136, 123, 124, 125, 117, 105, 106, 107, 108, 109, 110, 111, 98, 91, 90, 89,
    88, 87, 86, 85, 77, 65, 66, 67, 68, 69, 70, 71, 58, 51, 50, 49, 48, 47, 46, 45, 37, 25, 24,
    23, 22, 21, 36, 41, 42, 43, 56, 63]
chain = chain_physical .+ 1  # Qiskit.jl numbers qubits from 1

"Apply U(θ, ϕ, λ) to qubit q with native gates: rz(λ), sx, rz(θ + π), sx, rz(ϕ + π)."
function native_u!(qc, q, θ, ϕ, λ)
    qc.rz(λ, q)
    qc.sx(q)
    qc.rz(θ + π, q)
    qc.sx(q)
    qc.rz(ϕ + π, q)
end

"Kicked-Ising circuit on `chain`, then the rotations of one setting and a measurement."
function native_setting_circuit(chain, angles, num_device_qubits)
    n = length(chain)
    qc = QuantumCircuit(num_device_qubits, n)
    for q in chain
        native_u!(qc, q, π/4, -π/2, π/2)       # e^{-iπ/8 X}
    end
    for i in 1:n-1
        qc.cz(chain[i], chain[i + 1])          # e^{iπ/4 ZZ}, up to the S† gates below
    end
    for (i, q) in enumerate(chain)
        bonds = (i > 1) + (i < n)
        qc.rz(-π/2 * bonds, q)                 # one S† per bond
        native_u!(qc, q, angles[i, 1], angles[i, 2], angles[i, 3])
        qc.measure(q, i)                       # outcome of chain qubit i goes to bit i
    end
    qc
end

circuits = [native_setting_circuit(chain, angles[r, :, :], num_device_qubits) for r in 1:NU_hw]
println(length(circuits), " circuits, each with ", count(inst -> inst.name == "cz", circuits[1].data), " CZ gates")
1024 circuits, each with
95 CZ gates
Passo 3: Executar usando primitivas do Qiskit
O QiskitIBMRuntime.jl executa um circuito por job do Sampler, então coletar os dados exige 1.024 jobs. A célula a seguir mantém até 32 jobs na fila e salva os resultados de cada configuração assim que seu job termina. Cada shot é retornado como um vetor de bits, no qual o elemento é o resultado do qubit da cadeia.
Você deve recuperar os resultados na mesma sessão que enviou os jobs, porque o QiskitIBMRuntime.jl ainda não consegue buscar um job pelo ID (qiskit-ibm-runtime-c issue #28). Se um job falhar, a célula emite um aviso e continua. Se a sessão parar, execute os Passos 1 a 3 novamente. Executar a célula de novo envia apenas as configurações cujos resultados estão faltando. Com use_saved_data = true, a célula não envia nada.
outcome_file(r) = joinpath(run_directory, "outcomes", "setting_$(lpad(r, 4, '0')).npz")

"Save the outcomes of setting `r` as a (shots × N) matrix of 0/1 values."
function save_outcomes(r, job)
    try
        samples = get_sampler_job_results(job, service)
        bits = UInt8.(permutedims(reduce(hcat, samples)))
        npzwrite(outcome_file(r), Dict("bits" => bits))
    catch err
        @warn "Setting $r failed and was not saved; run this cell again to resubmit it" err
    end
end

if use_saved_data
    println("Using the saved ibm_fez measurements; no jobs submitted")
else
    backend_name = "ibm_fez"
    service = Service()  # uses the credentials saved on this computer
    backend = only(b for b in backend_search(service) if b.name == backend_name)
    open(joinpath(run_directory, "metadata.json"), "w") do io
        JSON.print(io, Dict("backend" => backend_name, "N" => N_hw, "depth" => 1, "settings" => NU_hw,
                            "shots" => NM_hw, "chain" => chain_physical), 2)
    end
    in_flight = []
    for r in 1:NU_hw
        isfile(outcome_file(r)) && continue
        push!(in_flight, (r, run_sampler_job(service, backend, circuits[r], NM_hw)))
        length(in_flight) >= 32 && save_outcomes(popfirst!(in_flight)...)
    end
    foreach(job -> save_outcomes(job...), in_flight)
    println("Saved outcomes: ", count(r -> isfile(outcome_file(r)), 1:NU_hw), " of ", NU_hw, " settings")
end
Using the saved ibm_fez measurements; no jobs submitted
Passo 4: Pós-processar e retornar o resultado no formato clássico desejado
Este passo lê apenas dados salvos: a execução baixada do ibm_fez se use_saved_data for true, ou, caso contrário, os arquivos que o Passo 3 gravou. Assim, você pode executá-lo em uma nova sessão sem enviar jobs (execute antes a célula Setup, a célula use_saved_data e o Passo 1). O arquivo baixado armazena os 96 resultados de cada shot empacotados em 12 bytes, com o bit mais significativo primeiro, então o carregador os desempacota. O RandomMeas.jl rotula os resultados como 1 e 2, então o carregador também soma 1 a cada bit.
"Build a `MeasurementGroup` from the angles and a function `outcomes(r)` that returns
the (shots × N) 0/1 outcomes of setting `r`."
function measurement_group(angles, outcomes)
    settings_count, n = size(angles, 1), size(angles, 2)
    sites = siteinds("Qubit", n)
    data = map(1:settings_count) do r
        rotations = Array{ComplexF64}(undef, n, 2, 2)
        for i in 1:n
            rotations[i, :, :] = u3_matrix(angles[r, i, :]...)
        end
        MeasurementData(Int.(outcomes(r)) .+ 1;
            measurement_setting=LocalUnitaryMeasurementSetting(rotations; site_indices=sites))
    end
    MeasurementGroup(data)
end

if use_saved_data
    packed = saved_run["outcomes"]  # settings × shots × 12 bytes
    # Bit i of a shot is in byte (i - 1) ÷ 8 + 1, most significant bit first
    unpack(r) = [(packed[r, s, (i - 1) ÷ 8 + 1] >> (7 - (i - 1) % 8)) & 0x01
                 for s in 1:size(packed, 2), i in 1:N_hw]
    group_hw = measurement_group(angles, unpack)
else
    group_hw = measurement_group(angles, r -> npzread(outcome_file(r))["bits"])
end
println(group_hw.NU, " settings × ", group_hw.NM, " shots on ", group_hw.N, " qubits")
1024 settings ×
1024 shots on 96 qubits
Antes de aprender, verifique os dados. Um qubit quebrado ou uma porta mal calibrada deixa o estado medido muito mais misto ao redor dele e pode fazer o aprendiz divergir. A pureza de alguns qubits vizinhos é um benchmark livre de modelo desse ruído: a função get_purity do RandomMeas.jl estima para um subsistema comparando pares de shots da mesma configuração. Calcule a entropia de Rényi-2 de cada janela de seis qubits vizinhos e compare-a com a mesma janela do estado ideal. O valor ideal não é zero, porque cada janela está emaranhada com o resto da cadeia; o ruído o aumenta, e um qubit quebrado empurra toda janela que o contém em direção ao máximo de seis.
ideal_hw = kicked_ising_reference(N_hw, 1)
width = 6
starts = 1:N_hw - width + 1
window_entropy(rho, w) = -log2(mpo_overlap(segment_mpo(rho, w), segment_mpo(rho, w)))
measured_entropy = [-log2(get_purity(group_hw, collect(j:j + width - 1))) for j in starts]
ideal_entropy = [window_entropy(ideal_hw, j:j + width - 1) for j in starts]
worst = argmax(measured_entropy)
println("S₂ of six-qubit windows: median ", round(median(measured_entropy), digits=2), "; highest ",
    round(measured_entropy[worst], digits=2), " (chain positions ", worst, " to ", worst + width - 1, ")")
println("Ideal state: ", round(minimum(ideal_entropy), digits=2), " to ", round(maximum(ideal_entropy), digits=2))
plot(starts, measured_entropy; marker=:circle, markersize=2, label="measured",
    xlabel="first chain position of the window", ylabel="S₂ of six qubits", ylims=(0, width),
    legend=:topright, size=(800, 280), left_margin=5Plots.mm, bottom_margin=5Plots.mm)
plot!(starts, ideal_entropy; linestyle=:dash, label="ideal state")
S₂ of six-qubit windows: median 0.9
; highest 1.43 (chain positions 30 to 35)
Ideal state: 0.19 to 0.39
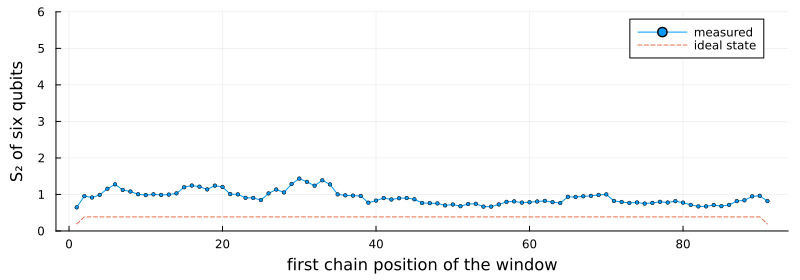
Toda janela é mais mista do que o estado ideal, em cerca de meio bit a um bit, e o trecho mais ruidoso fica ao redor das posições 30 a 35 da cadeia. Nenhuma janela chega perto do máximo de seis, então nenhum qubit está quebrado, e a análise usa a cadeia inteira de 96 qubits. Se algumas janelas tivessem uma entropia próxima de seis, você removeria o qubit que essas janelas compartilham e aprenderia a maior parte da cadeia sem ele.
As mesmas purezas determinam o prior CRM. Para cada janela, fitted_prior pega o estado ideal e ajusta uma intensidade de despolarização local de modo que sua pureza corresponda à pureza medida nas configurações de treinamento, como no artigo.
A função learn_and_validate na célula a seguir realiza o resto da análise. Ela aprende o modelo a partir das configurações de treinamento e depois estima e nas configurações de teste para os primeiros qubits da cadeia, em passos de 12. Essas são as grandezas da Figura 1(c,d) do artigo. O estado ideal é avaliado nos mesmos dados de teste como linha de base.
A célula executa a função com e depois a repete com e para ver o quanto o tamanho das janelas de aprendizado importa. A dimensão de ligação pode ser no máximo , então aprende um estado produto: cada qubit sozinho, sem correlações entre qubits.
function learn_and_validate(group; ideal, ell=2, k=3, sizes=12:12:group.N, seed=20260921, train_fraction=0.5)
    split = split_settings(group; seed, train_fraction)
    prior = fitted_prior(ideal, split.train)
    marginals = training_marginals(split.train; ell, prior)
    fit = learn_mpo(marginals, group.N; ell, maxbond=min(4, 4^ell), sweeps=20)
    last(fit.history).purity <= 1 ||
        @warn "The model has purity above one, so the fit diverged. Collect more settings or shots."
    statistics = afc_statistics(split.test, k; prior)
    learned = afc_prefix_curve(fit.model, statistics, split.test.NU; k, sizes)
    baseline = afc_prefix_curve(ideal, statistics, split.test.NU; k, sizes)
    model_entropy = [-log2(mpo_overlap(prefix_mpo(fit.model, n), prefix_mpo(fit.model, n))) for n in sizes]
    (; ell, fit, split, learned, baseline, model_entropy)
end

function plot_validation(results, title)
    n = [r.n for r in first(results).learned]
    # Marker, size, and line style per ℓ. The ℓ = 1 squares are small enough to sit inside the
    # ℓ = 2 circles, so both stay visible where the two curves overlap.
    style = Dict(2 => (:circle, 7, :solid), 1 => (:rect, 3.5, :dash), 0 => (:utriangle, 5, :dot))
    fidelity = plot(yscale=:log10, ylims=(1e-6, 1.5), legend=:bottomleft, xlabel="number of qubits N",
        ylabel="held-out F_max", title=title)
    entropy = plot(xlabel="number of qubits N", ylabel="Rényi-2 entropy S₂", legend=:topleft)
    held_out = first(results).learned
    # Draw every error bar before any marker, so the bars stay behind the symbols
    for (color, result) in enumerate(results)
        scatter!(fidelity, n, [r.fidelity for r in result.learned]; yerror=[r.fidelity_sem for r in result.learned],
            markersize=0, markerstrokecolor=color, label="")
    end
    scatter!(entropy, n, [r.entropy for r in held_out]; yerror=[r.entropy_sem for r in held_out],
        markersize=0, markerstrokecolor=:black, label="")
    for (color, result) in enumerate(results)
        marker, markersize, linestyle = style[result.ell]
        label = "learned model, ℓ = $(result.ell)"
        plot!(fidelity, n, [r.fidelity for r in result.learned]; color, marker, markersize, linestyle,
            markerstrokewidth=0, label)
        plot!(entropy, n, result.model_entropy; color, linestyle, linewidth=2, label)
    end
    plot!(fidelity, n, [r.fidelity for r in first(results).baseline]; marker=:diamond, markersize=5,
        linestyle=:dashdot, color=:black, label="ideal state")
    scatter!(entropy, n, [r.entropy for r in held_out]; marker=:circle, markersize=4, color=:black,
        label="held-out AFC estimate")
    plot(fidelity, entropy; layout=(1, 2), size=(1000, 400), left_margin=7Plots.mm, bottom_margin=7Plots.mm)
end

function summarize(result)
    final = last(result.learned)
    println("ℓ = ", result.ell, ", N = ", final.n, ": held-out F_max = ", round(final.fidelity, sigdigits=3), " ± ",
        round(final.fidelity_sem, sigdigits=2), " (ideal state: ", round(last(result.baseline).fidelity, sigdigits=2), ")")
    println("  S₂ = ", round(final.entropy, digits=2), " ± ", round(final.entropy_sem, digits=2),
        " held out; ", round(last(result.model_entropy), digits=2), " from the model")
    lowest = minimum(minimum(eigvals(Hermitian(operator_from_coefficients(local_coefficients(result.fit.model, w)))))
                     for w in unique(learning_windows(final.n, max(result.ell, 1))))
    println("  Most negative eigenvalue in any learning window: ", round(lowest, digits=4))
end

results_hw = [learn_and_validate(group_hw; ideal=ideal_hw, ell) for ell in (2, 1, 0)]
foreach(summarize, results_hw)
plot_validation(results_hw, "ibm_fez, 96-qubit chain")
ℓ = 2
, N = 96: held-out F_max = 0.591 ± 0.1 (ideal state: 0.0035)
  S₂ = 10.04 ± 0.28 held out; 10.21 from the model
  Most negative eigenvalue in any learning window: -0.0523
ℓ = 1, N = 96: held-out F_max = 0.554 ± 0.094 (ideal state: 0.0035)
  S₂ = 10.04 ± 0.28 held out; 10.26 from the model
  Most negative eigenvalue in any learning window: -0.0215
ℓ = 0, N = 96: held-out F_max = 6.18e-6 ± 1.1e-6 (ideal state: 0.0035)
  S₂ = 10.04 ± 0.28 held out; 32.01 from the model
  Most negative eigenvalue in any learning window: 0.0012
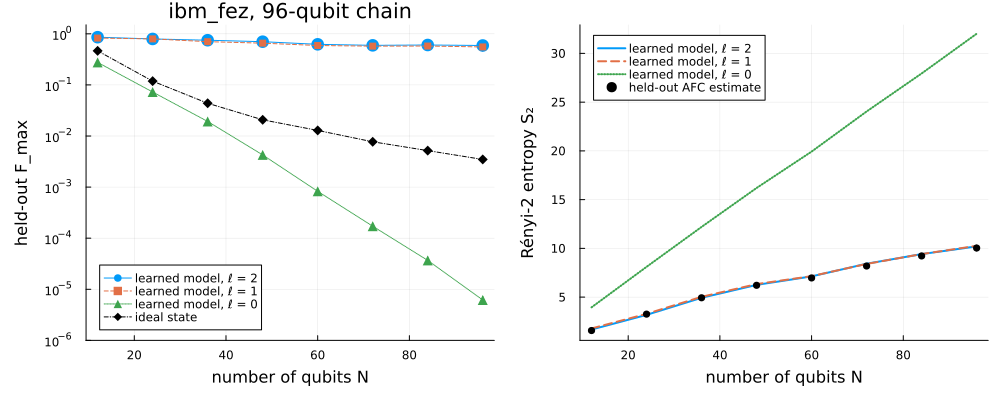
Os resultados reproduzem as duas afirmações do artigo em um processador diferente:
-
O modelo descreve os dados muito melhor do que o estado ideal. Com , o reservado do modelo com é 0,59 ± 0,10, em comparação com 0,0035 do estado ideal. O artigo relata cerca de 0,75 no
ibm_brisbane. -
A entropia do modelo concorda com os dados de teste para todo . Com , ela é 10,2 pelo modelo e 10,0 ± 0,3 pelos dados de teste, ou , em comparação com 0,14 a 0,15 no
ibm_brisbane, mais antigo.
A comparação dos tamanhos de janela mostra onde está a informação. Com , o modelo é quase tão bom (), então, para estes dados, correlações além de alguns qubits acrescentam pouco. Com , o estado produto não captura o emaranhamento entre qubits vizinhos: sua entropia cresce até 32 em vez de 10, e seu cai ainda mais rápido do que o do estado ideal, para com .
Tenha em mente as limitações a seguir ao ler esses números:
-
Divisão de treinamento. As barras de erro cobrem apenas o erro estatístico dos dados de teste. Outras divisões aleatórias das mesmas configurações dão entre 0,49 e 0,59 com para .
-
Varredura final. O aprendiz sempre retorna o modelo da varredura final, então os dados de teste nunca influenciam o modelo.
-
Positividade. O modelo não é restrito a ser semidefinido positivo; seu autovalor mais negativo em uma janela de aprendizado é cerca de . Portanto, seu e seu descrevem um operador, não propriedades certificadas de um estado físico.
-
Fatoração. Toda estimativa reservada depende da hipótese do AFC, que as próprias medições não podem certificar.
Próximos passos
-
Repita o experimento com profundidade dois usando os parâmetros do artigo para essa profundidade ( e uma dimensão de ligação máxima de 8) e determine de quantas configurações de medição o aprendiz precisa.
-
Aprenda com a atualização de dois sítios (
update=:two_siteemtraining_marginalselearn_mpo), que trunca a dimensão de ligação após cada passo, e veja como ela se comporta com menos configurações de treinamento. -
Aprenda sem o prior CRM (
prior=nothing) e compare a fidelidade reservada. -
Aplique a mesma análise às medições do
ibm_brisbanepublicadas pelos autores. -
Leia o suplemento do artigo para ver a derivação da atualização e dos estimadores do AFC.
-
Explore outros protocolos de medição aleatória nos exemplos do
RandomMeas.jl.
Referências
-
M. Votto, M. Ljubotina, C. Lancien, J. I. Cirac, P. Zoller, M. Serbyn, L. Piroli, and B. Vermersch, "Learning mixed quantum states in large-scale experiments", Phys. Rev. Lett. 136, 090801 (2026). arXiv:2507.12550
-
A. Elben, S. T. Flammia, H.-Y. Huang, R. Kueng, J. Preskill, B. Vermersch, and P. Zoller, "The randomized measurement toolbox", Nat. Rev. Phys. 5, 9 (2023). arXiv:2203.11374
-
H.-Y. Huang, R. Kueng, and J. Preskill, "Predicting many properties of a quantum system from very few measurements", Nat. Phys. 16, 1050 (2020). arXiv:2002.08953
-
A. Elben and B. Vermersch, "RandomMeas.jl: A Julia package for randomized measurements in quantum devices", Quantum 10, 2086 (2026). arXiv:2509.12749
-
B. Vermersch, A. Rath, B. Sundar, C. Branciard, J. Preskill, and A. Elben, "Enhanced estimation of quantum properties with common randomized measurements", PRX Quantum 5, 010352 (2024). arXiv:2304.12292
-
H. Zou, "Randomized measurements of a 96-qubit kicked-Ising state on ibm_fez", Zenodo (2026). doi:10.5281/zenodo.24116174