Simule espalhamento de nêutrons com um fluxo de trabalho Serverless de dinâmica AQC + Trotter
Estimativa de uso: 18 minutos em um processador Heron r3 (OBSERVAÇÃO: Isto é apenas uma estimativa. Seu tempo de execução pode variar.)
Resultados de aprendizagem
-
Como um espectro de espalhamento inelástico de nêutrons se mapeia para o fator de estrutura dinâmico de um ímã quântico 1D.
-
Como preparar o estado fundamental do KCuF (Heisenberg isotrópico) com o grupo de renormalização da matriz de densidade (DMRG) e a maximização de fidelidade de estado de produto de matrizes (MPS).
-
Como executar a evolução temporal de Trotter, a compressão de circuito por compilação quântica aproximada (AQC) e a execução mitigada como uma única chamada de função.
-
Como pós-processar a série temporal por sítio em e identificar o contínuo de dois spinons.
Pré-requisitos
-
Familiaridade com Qiskit patterns,
SparsePauliOp, e evolução temporal de Trotter. -
Uma exposição básica a métodos de rede tensorial (DMRG e MPS) é útil, mas não obrigatória, assim como a familiaridade com a biblioteca
qiskit-addon-aqc-tensorque a função usa para comprimir circuitos de Trotter.
Contexto
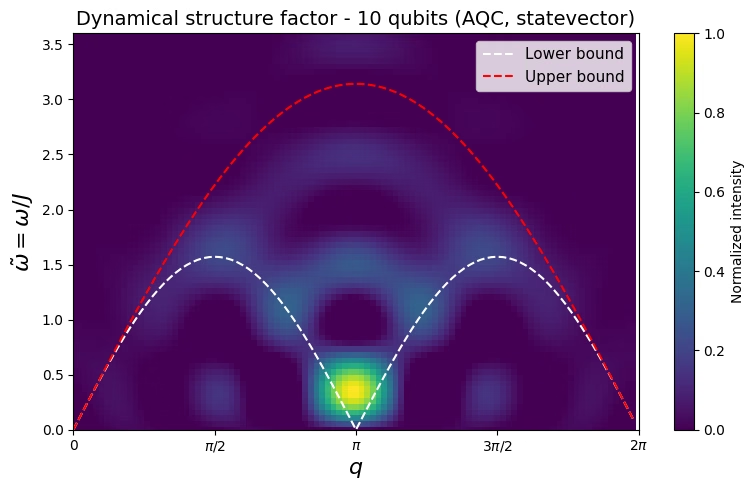
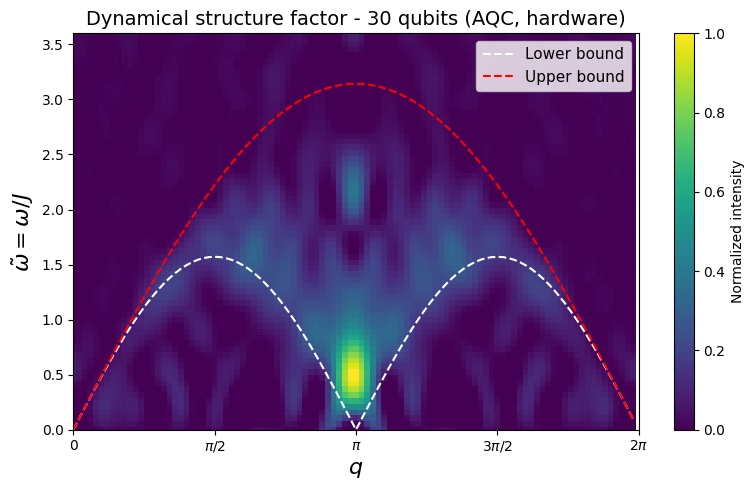
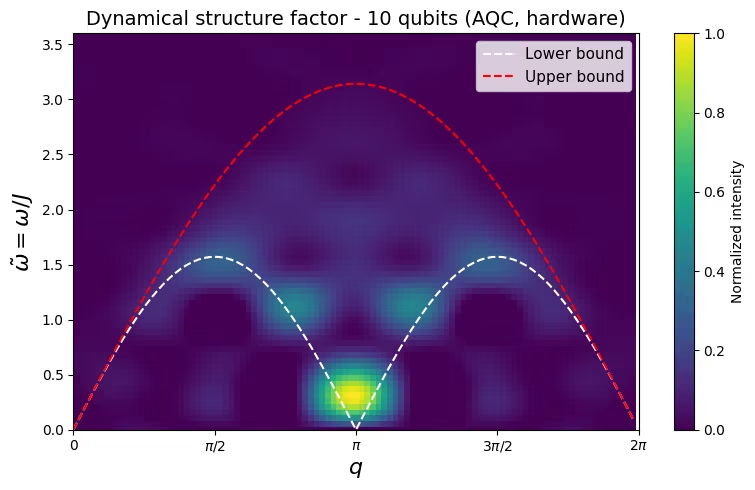
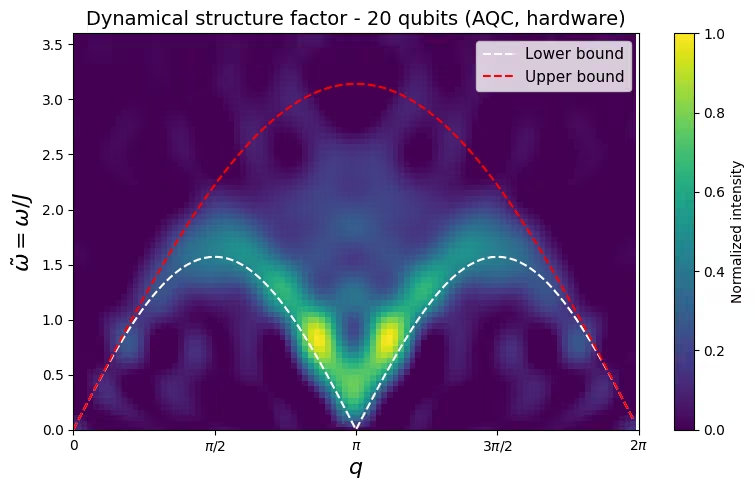
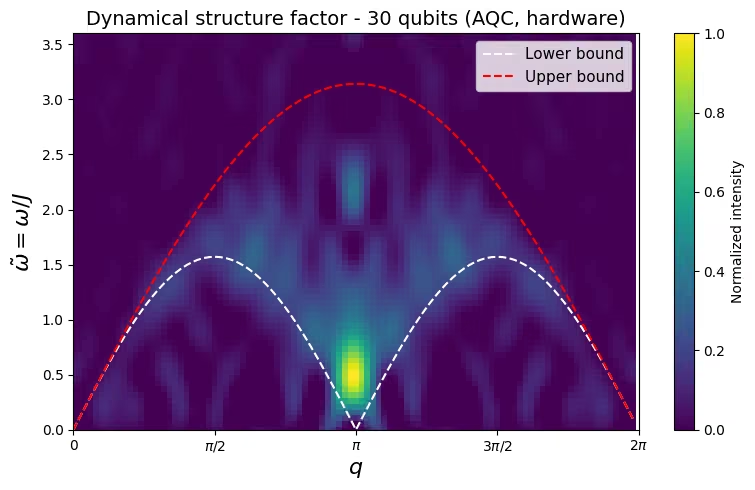
O espalhamento inelástico de nêutrons mede o fator de estrutura dinâmico , a transformada de Fourier no espaço e no tempo da função de correlação spin-spin, de modo que reproduzir a partir de um modelo de spin microscópico é um teste direto e refutável de uma simulação quântica. Este tutorial estuda o KCuF, uma cadeia de Heisenberg antiferromagnética de spin- cujas excitações não são flips de spin único, mas pares de spinons fracionados: em vez de uma dispersão de magnon nítida, mostra um amplo contínuo de dois spinons, limitado abaixo por e acima por . Essas são as curvas tracejadas nos gráficos a seguir. A física completa, e a comparação com dados de nêutrons medidos, são abordadas no tutorial original e em Lee et al., arXiv:2603.15608.
O fluxo de trabalho quântico espelha o experimento de espalhamento:
-
Prepare o estado fundamental da cadeia .
-
Perturbe-o com uma perturbação local no sítio central, uma rotação de , imitando a transferência de momento e energia do nêutron.
-
Evolua no tempo sob o Hamiltoniano de Heisenberg, , com uma fórmula de produto de Trotter.
-
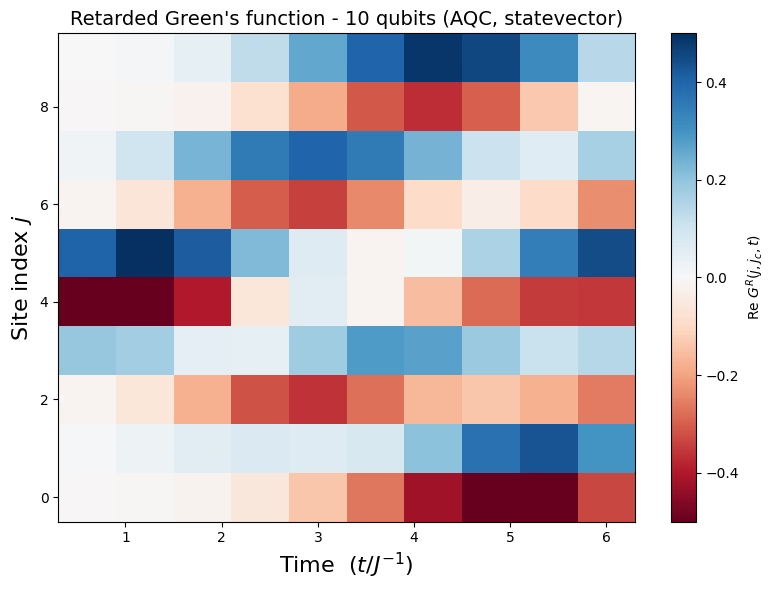
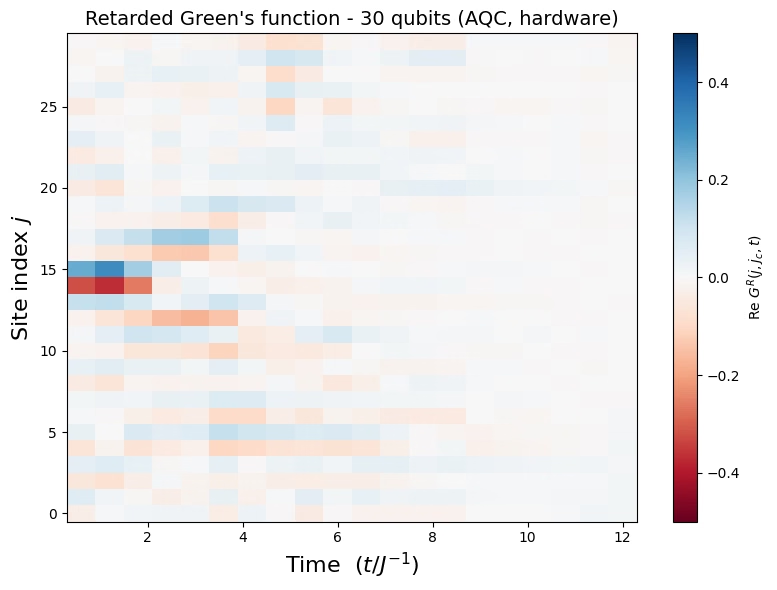
Meça a magnetização por sítio . Como função do sítio e do tempo , esta é exatamente a função de Green retardada , portanto nenhuma conversão é necessária antes da transformada de Fourier na etapa 5.
-
Transforme por Fourier em .
Problemas podem surgir na etapa 3, quando circuitos de Trotter exatos para evoluções longas se tornam profundos demais para o hardware. A AQC com redes tensoriais resolve isso comprimindo um bloco de passos de Trotter em um ansatz parametrizado fixo e raso, cuja fidelidade de estado em relação à evolução exata é maximizada classicamente com um simulador MPS (arXiv:2301.08609). O AQC Dynamics Template empacota todo esse núcleo quântico (síntese de Trotter, compressão AQC e execução mitigada) por trás de uma única chamada:
| PRÉ (este notebook) | FUNÇÃO (aqc-dynamics-function) | PÓS (este notebook) |
|---|---|---|
| Estado fundamental do DMRG mais maximização de fidelidade MPS, com a perturbação do nêutron incorporada no mesmo circuito | Síntese de Trotter → compressão AQC → execução em statevector, fake, ou runtime, retornando por sítio | , o fator de estrutura dinâmico |
O trabalho específico do experimento permanece aqui no notebook: preparação do estado fundamental (PRÉ) e o pós-processamento de (PÓS). As duas etapas de uso intensivo quântico, compressão e execução, são executadas dentro da função.
Este tutorial é um complemento a Simulate neutron scattering in quantum materials with quantum circuits, que constrói o mesmo experimento inline: o mesmo modelo KCuF, preparação do estado fundamental, perturbação do nêutron e pós-processamento, com a síntese de Trotter, compressão AQC e execução mitigada escritas passo a passo. Leia esse tutorial para aprender como funciona a compressão AQC. Leia este para executar o mesmo experimento por meio de um template de função implantado: o núcleo quântico se torna uma única chamada de função, e a compressão AQC de várias horas é executada dentro do worker Serverless em vez de na sua máquina, então você não precisa de um sistema HPC ou de um kernel aberto enquanto ela é executada. A mesma chamada também conduz outros experimentos de dinâmica 1D.
Requisitos
Antes de iniciar este tutorial, certifique-se de ter o seguinte:
-
A função implantada na sua conta do Qiskit Serverless. Execute primeiro o template de função complementar: Deploy and run the AQC + Trotter dynamics function template. Esse guia mostra como obter os arquivos de origem e fazer upload da função para a sua conta. Este tutorial apenas chama a função implantada.
-
Credenciais do IBM Quantum® salvas para
QiskitServerless(consulte o template de função). Ambos os exemplos neste tutorial chamam a função implantada, então ambos precisam delas. -
Qiskit SDK v2.0 ou posterior (
pip install qiskit). -
O cliente Qiskit IBM Catalog (
pip install qiskit-ibm-catalog). -
NumPy, SciPy e Matplotlib (
pip install numpy scipy matplotlib). SciPy 1.14 ou posterior é necessário para o otimizador COBYQA usado na preparação do estado fundamental. -
A pilha de rede tensorial AQC, porque a preparação do estado fundamental na Etapa 1 é executada localmente neste notebook:
pip install 'qiskit-addon-aqc-tensor[quimb-jax]==0.3.1'.
A primeira chamada a uma função recém-implantada aguarda enquanto o worker Serverless instala suas dependências, então espere latência extra nessa execução.
Configuração
Importe as bibliotecas e defina os auxiliares específicos do experimento usados posteriormente: build_gs_ansatz (o ansatz variacional do Hamiltoniano, ou HVA, para preparação do estado fundamental), prepare_ground_state (DMRG mais maximização de fidelidade MPS), e get_spectrum, plot_green, e plot_spectrum (o pós-processamento de ). Estes são adaptados do tutorial original de espalhamento de nêutrons.
# Added by doQumentation — required packages for this notebook
!pip install -q matplotlib numpy qiskit qiskit-addon-aqc-tensor qiskit-ibm-catalog quimb scipy
from functools import partial

import matplotlib.pyplot as plt
import numpy as np
import scipy.optimize

import quimb.tensor as qtn
from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp
from qiskit_addon_aqc_tensor.simulation import tensornetwork_from_circuit
from qiskit_addon_aqc_tensor.simulation.quimb import QuimbSimulator
from qiskit_ibm_catalog import QiskitServerless
#  Dynamical structure factor via discrete Fourier transform

def get_spectrum(n, Gjjc, dt, time_steps, q_steps, w_steps):
    """Compute the dynamical structure factor from the retarded Green's function.

    Uses the center-site approximation and a discrete Fourier transform.
    """
    green = Gjjc / 4  # sigma -> S=1/2
    omega_max = np.pi / dt
    qpoints = np.arange(0, 2 * np.pi, 2 * np.pi / q_steps)
    omegas = np.arange(0, omega_max, omega_max / w_steps)
    green_map = np.zeros((omegas.shape[0], qpoints.shape[0]))
    center = n // 2 - 1
    for iw, w in enumerate(omegas):
        exponent = np.exp(1j * w * dt * np.arange(1, time_steps + 1))
        S_w = np.dot(green.T, exponent) * dt
        for iq, q in enumerate(qpoints):
            q_matrix = np.exp(-1j * q * np.arange(-center, center + 2, 1))
            green_map[iw, iq] = np.imag(np.dot(S_w, q_matrix))
    return green_map

#  Plotting helpers

def plot_spectrum(
    dsf,
    dt,
    q_steps,
    w_steps,
    lower_bound=False,
    upper_bound=False,
    title=None,
):
    """Heat-map of the dynamical structure factor."""
    omega_max = np.pi / dt
    qpoints = np.arange(0, 2 * np.pi, 2 * np.pi / q_steps)
    omegas = np.arange(0, omega_max, omega_max / w_steps)
    x, y = np.meshgrid(qpoints, omegas)
    fig, ax = plt.subplots(figsize=(8, 5))
    c = ax.pcolormesh(x, y, dsf / np.max(dsf), cmap="viridis", shading="auto")
    fig.colorbar(c, ax=ax, label="Normalized intensity")
    if lower_bound:
        ax.plot(
            qpoints,
            np.pi * np.abs(np.sin(qpoints)) / 2,
            "--",
            color="white",
            lw=1.5,
            label="Lower bound",
        )
    if upper_bound:
        ax.plot(
            qpoints,
            np.pi * np.abs(np.sin(qpoints / 2)),
            "--",
            color="red",
            lw=1.5,
            label="Upper bound",
        )
    ax.set_ylim(0, 3.6)
    ax.set_xlim(0, 2 * np.pi - 2 * np.pi / q_steps)
    ax.set_xlabel(r"$q$", fontsize=16)
    ax.set_ylabel(r"$\tilde{\omega} = \omega / J$", fontsize=16)
    ax.set_xticks([0, np.pi / 2, np.pi, 3 * np.pi / 2, 2 * np.pi])
    ax.set_xticklabels(["0", r"$\pi/2$", r"$\pi$", r"$3\pi/2$", r"$2\pi$"])
    if lower_bound or upper_bound:
        ax.legend(loc="upper right", fontsize=11)
    if title:
        ax.set_title(title, fontsize=14)
    plt.tight_layout()
    plt.show()

def plot_green(n, Gjjc, time_steps, dt, title=None):
    """Heat-map of the retarded Green's function in real space and time."""
    fig, ax = plt.subplots(figsize=(8, 6))
    t_axis = np.arange(1, time_steps + 1) * dt
    site_axis = np.arange(n)
    x, y = np.meshgrid(t_axis, site_axis)
    c = ax.pcolormesh(
        x,
        y,
        np.real(Gjjc).T,
        cmap="RdBu",
        vmax=0.5,
        vmin=-0.5,
        shading="auto",
    )
    fig.colorbar(c, ax=ax, label=r"Re $G^R(j, j_c, t)$")
    ax.set_xlabel(r"Time  ($t / J^{-1}$)", fontsize=16)
    ax.set_ylabel("Site index $j$", fontsize=16)
    if title:
        ax.set_title(title, fontsize=14)
    plt.tight_layout()
    plt.show()

#  Variational ground-state ansatz (HVA)

def _apply_xxz_pair_gate(qc, q0, q1, theta):
    """Apply the parameterized XXZ-type two-qubit gate used in the HVA."""
    qc.cx(q0, q1)
    qc.rz(theta, q1)
    qc.h(q0)
    qc.rz(theta + np.pi / 2, q0)
    qc.cx(q0, q1)
    qc.rz(-theta, q1)
    qc.h(q1)
    qc.cx(q1, q0)
    qc.rz(np.pi / 2, q1)
    qc.rz(-np.pi / 2, q0)
    qc.h(q1)
    qc.h(q0)

def build_gs_ansatz(n, params, layers):
    """Build the Hamiltonian variational ansatz (HVA) circuit for
    ground-state preparation of the 1D Heisenberg model.

    Starts from a product of singlet pairs and applies alternating
    odd/even layers of parameterized XXZ gates. For layer r,
    params[2 * r] is the odd-layer (inter-pair) angle and
    params[2 * r + 1] is the even-layer (intra-pair) angle.
    """
    qc = QuantumCircuit(n)
    # Initial singlet product state
    for i in range(n // 2):
        qc.x(2 * i)
        qc.x(2 * i + 1)
        qc.h(2 * i + 1)
        qc.cx(2 * i + 1, 2 * i)
    # Variational layers
    for r in range(layers):
        for i in range(1, (n + 1) // 2):  # odd layer
            _apply_xxz_pair_gate(qc, 2 * i - 1, 2 * i, params[2 * r])
        for i in range(n // 2):  # even layer
            _apply_xxz_pair_gate(qc, 2 * i, 2 * i + 1, params[2 * r + 1])
    return qc

def prepare_ground_state(n, gs_layers=5, max_bond=128, cutoff=1e-8):
    """Prepare the KCuF3 (isotropic Heisenberg) ground state as a QuantumCircuit.

    Runs DMRG (quimb MPO + DMRG2) to get the chain's ground state, then optimizes
    the HVA angles to maximize the MPS overlap |<psi_ansatz|psi_DMRG>|^2. No exact
    diagonalization, so it scales to larger n.
    """
    J = Jz = 1.0
    builder = qtn.SpinHam1D(S=1 / 2)
    builder += J * 0.5, "+", "-"
    builder += J * 0.5, "-", "+"
    builder += Jz, "Z", "Z"
    H_mpo = builder.build_mpo(L=n)
    dmrg = qtn.DMRG2(H_mpo)
    dmrg.solve(tol=1e-8, verbosity=0)

    gs_sim = QuimbSimulator(
        quimb_circuit_factory=partial(
            qtn.CircuitMPS, gate_opts=dict(cutoff=cutoff, max_bond=max_bond)
        ),
        autodiff_backend="jax",
    )

    def gs_infidelity(params):
        psi = tensornetwork_from_circuit(
            build_gs_ansatz(n, params, gs_layers), gs_sim
        ).psi
        return 1 - abs(psi.H @ dmrg.state) ** 2

    # Seed and optimizer match the original tutorial. Each layer starts at
    # [0, pi/2]: an odd-layer angle of 0 makes the inter-pair gate the identity,
    # and an even-layer angle of pi/2 makes the intra-pair gate a SWAP (since
    # 0.5 * (XX + YY + ZZ) = SWAP - I/2). That puts the seed at the singlet-pair
    # product limit, which is already a decent approximation to the Heisenberg
    # ground state, so the optimizer only has to refine it. The small jitter
    # (fixed RNG seed, so runs are reproducible) breaks the exact symmetry
    # between layers; COBYQA then runs for up to 100 iterations.
    rng = np.random.default_rng(12345)
    x0 = np.tile([0.0, np.pi / 2], gs_layers) + rng.normal(
        scale=0.1, size=2 * gs_layers
    )
    result_gs = scipy.optimize.minimize(
        gs_infidelity, x0, method="COBYQA", options={"maxiter": 100}
    )
    print(f"DMRG ground-state energy: {dmrg.energy:.6f}")
    print(f"GS fidelity: {1 - result_gs.fun:.4f}")
    return build_gs_ansatz(n, result_gs.x, gs_layers)

print("Setup complete - helpers defined.")
Setup complete - helpers defined.
Carregue o template de função
Conecte-se ao Qiskit Serverless e carregue a aqc-dynamics-function implantada. Ambos os exemplos neste tutorial chamam o mesmo handle fn, então a função é carregada uma vez, aqui.
# Credentials are read from the account saved once via QiskitServerless.save_account(...)
serverless = QiskitServerless()
fn = serverless.load("aqc-dynamics-function")
Exemplo de simulador em pequena escala
Primeiro, executamos o fluxo de trabalho completo em uma cadeia pequena de 10 sítios usando o backend exato statevector. Isso valida o pipeline PRE → FUNCTION → POST antes de gastar qualquer tempo de QPU.
Etapa 1: Mapear entradas clássicas para um problema quântico
Construa o Hamiltoniano de KCuF como um SparsePauliOp (Heisenberg isotrópico: com acoplamento em cada ligação de vizinhos mais próximos; as strings são operadores de Pauli, então dá o acoplamento de spin-). Prepare o estado fundamental com DMRG e maximização da fidelidade MPS, depois incorpore o impulso do nêutron: uma rotação de no sítio central. O circuito preparado é o que passamos para a função como initial_state. Deixamos observables no seu padrão ( por sítio), que é exatamente a leitura que o fluxo de trabalho de nêutrons precisa.
n = 10
dt = 0.6  # physical time per Trotter step (also the omega-axis unit in POST)
time_steps = 10
center = n // 2 - 1

# MPS-simulator settings, shared by the ground-state prep here and the AQC
# compression inside the function (matches the original tutorial).
mps_max_bond = 32
mps_cutoff = 1e-8

# 1D isotropic Heisenberg (KCuF3) Hamiltonian on n qubits
H = SparsePauliOp.from_sparse_list(
    [(p, [i, i + 1], 0.25) for i in range(n - 1) for p in ("XX", "YY", "ZZ")],
    num_qubits=n,
)

# Ground state (DMRG + fidelity max) + neutron kick baked into the same circuit
gs_circuit = prepare_ground_state(
    n, gs_layers=3, max_bond=mps_max_bond, cutoff=mps_cutoff
)
gs_circuit.rz(
    np.pi / 2, center
)  # exp(-i (pi/2)/2 Z_center): the neutron perturbation
print(
    f"Prepared {n}-qubit ground state with the neutron kick at site {center}."
)
DMRG ground-state energy: -4.258035
GS fidelity: 0.9841
Prepared 10-qubit ground state with the neutron kick at site 4.
Etapas 2 e 3: Comprimir e executar com o modelo de função
Em um fluxo de trabalho escrito manualmente, essas são duas etapas separadas: otimizar os circuitos para o hardware (Etapa 2) e executá-los (Etapa 3). O modelo de função combina ambas em uma única chamada. Ele realiza a síntese de Trotter, a compressão AQC e a transpilação para o hardware, depois executa os circuitos (aqui no simulador exato, mais tarde com mitigação de erros integrada no hardware). Os dois parâmetros de ajuste são aqc_segments (o plano de compressão) e aqc_options (as configurações de MPS e do otimizador). Cada segmento {"n_steps": k, "ansatz_steps": m} comprime k passos de Trotter consecutivos em um ansatz construído a partir de um alvo de Trotter de m passos, e quaisquer passos além de sum(n_steps) são executados como Trotter simples. Passos iniciais, de baixo emaranhamento, comprimem bem em um ansatz raso (ansatz_steps=1), então aqui comprimimos os três primeiros passos em um ansatz de camada única e os dois seguintes em um ansatz mais profundo de duas camadas; os cinco passos restantes dos 10 passos de Trotter são executados como Trotter simples. Para aqc_options, espelhamos o tutorial original: dimensão de vínculo MPS max_bond=32, cutoff=1e-8, e um otimizador L-BFGS-B limitado a 100 iterações.
Chame a função carregada em Setup. backend="statevector" executa o caminho de referência exato: sem tempo de QPU, com os circuitos rodando em um simulador exato de statevector dentro do worker serverless (uma conta salva do Qiskit Serverless ainda é necessária para chamá-lo). O initial_state carrega o estado fundamental preparado (incluindo o impulso); observables é omitido para que a função meça o por sítio padrão.
job = fn.run(
    t_steps=time_steps,
    aqc_segments=[
        {
            "n_steps": 3,
            "ansatz_steps": 1,
        },  # early steps -> shallow 1-layer ansatz
        {
            "n_steps": 2,
            "ansatz_steps": 2,
        },  # later steps -> deeper 2-layer ansatz
    ],
    aqc_options={
        "max_bond": mps_max_bond,  # MPS bond dimension for AQC compression
        "cutoff": mps_cutoff,
        "optimizer_settings": {
            "method": "L-BFGS-B",
            "jac": True,
            "options": {"maxiter": 100},
        },
    },
    dt=dt,
    hamiltonian=H,
    initial_state=gs_circuit,  # prepared ground state including the neutron kick
    # observables omitted -> default per-site Z (the neutron sigma_z readout)
    backend="statevector",
)
print(job.status()) # rerun this cell until status says DONE
DONE
# The per-site <sigma_z>(t) the function returns is the retarded Green's function
# G(j, j_c, t). The workflow samples t = 1..time_steps, so drop the t = 0 row (the
# prepared+kicked state before any evolution) before post-processing.
result = job.result()
print(
    "AQC fidelities:",
    {k: round(v, 4) for k, v in result["metadata"]["aqc_fidelities"].items()},
)

ev = np.array(result["expectation_values"])
Gjjc = ev[1:]  # shape (time_steps, n)
print("Green's function shape:", Gjjc.shape)
AQC fidelities: {'1': 1.0, '2': 0.9999, '3': 0.9992, '4': 0.9998, '5': 0.9995}
Green's function shape: (10, 10)
Etapa 4: Pós-processar e retornar o resultado no formato clássico desejado
Transforme por Fourier a função de Green em , simetrize por espelhamento e recorte os valores negativos: o pós-processamento padrão de nêutrons. A simetrização é exata porque para este modelo, e os valores negativos que sobrevivem são artefatos da transformação de Fourier de uma série temporal finita e discretamente amostrada, então são recortados para zero. Nessa execução exata pequena, o contínuo de dois spinons é apenas resolvido de forma grosseira, mas o mecanismo é idêntico à execução em hardware que se segue.
q_res, w_res = 100, 100
spectrum = get_spectrum(n, Gjjc, dt, time_steps, q_res, w_res)
spectrum = -(spectrum + spectrum[:, ::-1]) / 2  # mirror symmetry
spectrum = np.clip(spectrum, a_min=0, a_max=None)  # clip negatives

plot_green(
    n,
    Gjjc,
    time_steps,
    dt,
    title=f"Retarded Green's function - {n} qubits (AQC, statevector)",
)
plot_spectrum(
    spectrum,
    dt,
    q_res,
    w_res,
    lower_bound=True,
    upper_bound=True,
    title=f"Dynamical structure factor - {n} qubits (AQC, statevector)",
)
Exemplo de hardware em larga escala
O mesmo fluxo de trabalho é escalado sem alterar nenhum código científico: uma cadeia de 30 sítios, o dobro da profundidade de Trotter (20 passos), um plano de compressão que varia a profundidade do ansatz (um ansatz mais profundo para os passos posteriores, mais emaranhados), e execução em um processador IBM Quantum com a mitigação de erros integrada da função (desacoplamento dinâmico, twirling de Pauli e extinção de erros de leitura por twirling (TREX)). Percorremos as mesmas quatro etapas do exemplo do simulador, reutilizando o identificador fn do Setup.
| Pequena escala | Grande escala | |
|---|---|---|
| Qubits | 10 | 30 |
| Passos de Trotter | 10 | 20 |
| Passos comprimidos com AQC (1 camada + 2 camadas) | 3 + 2 = 5 | 6 + 4 = 10 |
| Camadas do ansatz de estado fundamental | 3 | 5 |
| Dimensão máxima de vínculo MPS | 32 | 128 |
| Backend | statevector | QPU com DD, twirling de Pauli e TREX |
Etapa 1: Mapear entradas clássicas para um problema quântico
Construa o mesmo SparsePauliOp de Heisenberg de KCuF e prepare o estado fundamental, agora com um ansatz mais profundo gs_layers=5 para a cadeia mais longa, depois incorpore o impulso de nêutron de no sítio central. Isso é idêntico ao mapeamento em pequena escala, mas com .
Espere uma fidelidade de estado fundamental menor do que na execução de 10 sítios: em torno de 0,82 aqui contra 0,98 para a cadeia menor, porque cinco camadas HVA não conseguem capturar totalmente um estado fundamental de 30 sítios. Isso é esperado, e não uma falha, e o tutorial original aceita aproximadamente 0,65 em 50 sítios pelo mesmo motivo. Aumentar gs_layers ou o limite de iterações do COBYQA melhora isso, com custo clássico adicional.
n = 30
dt = 0.6
time_steps = 20
center = n // 2 - 1

# Same MPS settings as the original large-scale run: a larger bond for the
# longer, more-entangled chain (shared by GS prep and AQC compression).
mps_max_bond = 128
mps_cutoff = 1e-8

# Same KCuF3 Hamiltonian and ground-state prep, on a larger chain
H = SparsePauliOp.from_sparse_list(
    [(p, [i, i + 1], 0.25) for i in range(n - 1) for p in ("XX", "YY", "ZZ")],
    num_qubits=n,
)
gs_circuit = prepare_ground_state(
    n, gs_layers=5, max_bond=mps_max_bond, cutoff=mps_cutoff
)
gs_circuit.rz(np.pi / 2, center)  # neutron kick at the center site
print(
    f"Prepared {n}-qubit ground state with the neutron kick at site {center}."
)
DMRG ground-state energy: -13.111355
GS fidelity: 0.8201
Prepared 30-qubit ground state with the neutron kick at site 14.
Etapas 2 e 3: Comprimir e executar com o modelo de função
A mesma chamada única do exemplo do simulador, agora com backend_name apontando para um processador IBM Quantum, para que a função transpile e execute lá. O plano de compressão varia a profundidade do ansatz: os primeiros seis passos de Trotter (de baixo emaranhamento) são comprimidos em um ansatz raso de camada única, os quatro seguintes em um ansatz mais profundo de duas camadas, e os 10 passos restantes dos 20 são executados como Trotter simples. aqc_options aumenta a dimensão de vínculo MPS para max_bond=128 para a cadeia mais longa e mais emaranhada (correspondendo ao original), mantendo o mesmo otimizador L-BFGS-B limitado a 100 iterações. As estimator_options ativam a mitigação de erros integrada: desacoplamento dinâmico (XY4), twirling de portas e mitigação de medição TREX. Os padrões da função já correspondem ao tutorial original para todos esses itens, exceto o orçamento de aprendizado do TREX (measure_noise_learning). O bloco inteiro ainda é escrito por completo porque um estimator_options fornecido pelo chamador substitui totalmente os padrões da função em vez de mesclar-se a eles, então omitir uma chave voltaria ao padrão do IBM Quantum Compute em vez do padrão da função.
# Steps 2 + 3: the function compresses (varied ansatz) and executes on hardware.
job = fn.run(
    t_steps=time_steps,
    aqc_segments=[
        {
            "n_steps": 6,
            "ansatz_steps": 1,
        },  # early steps -> shallow 1-layer ansatz
        {
            "n_steps": 4,
            "ansatz_steps": 2,
        },  # later steps -> deeper 2-layer ansatz
    ],
    aqc_options={
        "max_bond": mps_max_bond,  # 128 for the longer chain
        "cutoff": mps_cutoff,
        "optimizer_settings": {
            "method": "L-BFGS-B",
            "jac": True,
            "options": {"maxiter": 100},
        },
    },
    dt=dt,
    hamiltonian=H,
    initial_state=gs_circuit,
    backend_name="ibm_pittsburgh",
    # Mitigation settings from the original tutorial. Only the two
    # measure_noise_learning values differ from the function's defaults; the rest
    # restates them, because a caller-supplied estimator_options dict replaces the
    # function's defaults wholesale rather than merging into them.
    estimator_options={
        "environment": {"job_tags": ["TUT-SNS"]},
        "dynamical_decoupling": {"enable": True, "sequence_type": "XY4"},
        "twirling": {
            "enable_gates": True,
            "num_randomizations": 1000,
            "shots_per_randomization": 128,
        },
        "resilience": {
            "measure_mitigation": True,
            "measure_noise_learning": {
                "num_randomizations": 32,
                "shots_per_randomization": 100,
            },
        },
    },
)
print("job ID (save this to reconnect later):", job.job_id)
job ID (save this to reconnect later): 43ed8d07-6d7d-4f33-b70a-7f31b765b310
A execução em larga escala não é rápida, e a maior parte do tempo é clássica, não na QPU. A compressão AQC é executada dentro da função antes que qualquer coisa chegue à QPU: com 30 sítios e max_bond=128, isso levou quase quatro horas em nossa execução, contra os aproximadamente 18 minutos de tempo de QPU citados na Estimativa de uso no topo deste tutorial. O tempo de espera na fila se soma a ambos. Você não precisa manter este notebook ou kernel aberto enquanto ele é executado.
Copie o ID do job impresso pela célula anterior e salve-o. As próximas três células permitem que você retome a execução mais tarde:
-
Reconectar, necessário apenas em uma nova sessão de kernel: execute novamente as células de Setup para recriar
serverless, depois reconstrua o identificadorjoba partir do ID que você salvou. Pule esta célula se ainda estiver na sessão em que você submeteu, pois o identificador já está ativo. -
Verificar status: execute novamente até que ele reporte
DONE. -
Buscar o resultado: execute apenas quando o status for
DONE.
A célula de reconexão a seguir contém um espaço reservado. Substitua-o pelo seu próprio job_id:
# Reconnect to a previously submitted job by its ID. Only needed in a NEW kernel
# session; if you are still in the session where you submitted, the `job` handle
# from the preceding cell is already live, so skip this cell. Replace the ID that follows with your own.
job = serverless.get_job_by_id("<your job ID>")
# Check where the job is. Re-run this until it reports DONE before fetching the
# result in the following cell: QUEUED -> INITIALIZING -> RUNNING: OPTIMIZING_FOR_HARDWARE ->
# RUNNING: WAITING_FOR_QPU -> RUNNING: EXECUTING_QPU -> RUNNING: POST_PROCESSING
# -> DONE.
print(job.status())
DONE
# Run this only once the preceding status cell reports DONE. result() blocks until
# the job finishes, so calling it earlier just waits (possibly for hours).
result = job.result()
print(
    "AQC fidelities:",
    {k: round(v, 4) for k, v in result["metadata"]["aqc_fidelities"].items()},
)

ev = np.array(result["expectation_values"])
Gjjc = ev[1:]  # drop the t = 0 row -> shape (time_steps, n)
AQC fidelities: {'1': 1.0, '2': 0.9994, '3': 0.9944, '4': 0.9853, '5': 0.9747, '6': 0.959, '7': 0.9495, '8': 0.9542, '9': 0.9533, '10': 0.9451}
Etapa 4: Pós-processar e retornar o resultado no formato clássico desejado
Pós-processamento idêntico ao da execução no simulador: transforme por Fourier a função de Green em , simetrize por espelhamento e recorte os valores negativos. Com a cadeia e a evolução mais longas, o contínuo de dois spinons é muito melhor resolvido. Ele deve preencher a banda entre os limites tracejados, mais brilhante perto de .
n = result["metadata"]["n"]
q_res, w_res = 100, 100
spectrum = get_spectrum(n, Gjjc, dt, time_steps, q_res, w_res)
spectrum = -(spectrum + spectrum[:, ::-1]) / 2  # mirror symmetry
spectrum = np.clip(spectrum, a_min=0, a_max=None)  # clip negatives

plot_green(
    n,
    Gjjc,
    time_steps,
    dt,
    title=f"Retarded Green's function - {n} qubits (AQC, hardware)",
)
plot_spectrum(
    spectrum,
    dt,
    q_res,
    w_res,
    lower_bound=True,
    upper_bound=True,
    title=f"Dynamical structure factor - {n} qubits (AQC, hardware)",
)
Apêndice
O exemplo de hardware anterior executa um único comprimento de cadeia. Os três espectros a seguir vêm de execuções de hardware anteriores deste mesmo fluxo de trabalho no ibm_pittsburgh com 10, 20 e 30 sítios, com todas as outras entradas mantidas fixas: 20 passos de Trotter com dt = 0.6, o plano de compressão de seis passos de uma camada mais quatro passos de duas camadas comprimidos por AQC e max_bond = 128. Estes são resultados registrados, não a saída das células anteriores.
As mesmas configurações são usadas nos três tamanhos, portanto os espectros são diretamente comparáveis. Ajustá-las por comprimento de cadeia, com mais camadas de ansatz de estado fundamental ou um max_bond maior, por exemplo, pode dar resultados melhores do que os mostrados aqui.
Próximos passos
-
Adapte este fluxo de trabalho ao seu próprio sistema: a função aceita qualquer
SparsePauliOpunidimensional de vizinhos mais próximos, então um Hamiltoniano de cadeia, estado inicial ou conjunto de observáveis diferente executa o mesmo pipeline PRE → FUNCTION → POST. Veja o contrato completo de entrada/saída no AQC Dynamics Template no GitHub. -
Leia o artigo do qual este benchmark é originado: Lee et al., Benchmarking quantum simulation with neutron-scattering experiments (arXiv:2603.15608).
-
Compare com o tutorial original "Simulate neutron scattering", o fluxo de trabalho embutido que este porta para um modelo de função implantado.
-
Aprofunde-se nas técnicas de mitigação e supressão de erros aplicadas na execução em hardware: desacoplamento dinâmico, twirling de Pauli e TREX.