Workflows modernos
Este curso abordou uma ampla variedade de métodos para lidar com ruído e erros quânticos. Evitamos intencionalmente algumas soluções de caixa-preta para podermos ver como esses métodos funcionam. Agora estamos prontos para usar esses métodos em sua forma mais moderna. Especificamente, exploramos algumas ferramentas de tratamento de erros altamente otimizadas que escondem parte da complexidade de nós. Também exploramos o Samplomatic e addons como os shaded lightcones (SLC), que nos dão um controle muito fino sobre certos processos de mitigação.
Neste vídeo, o Dr. Chris Porter apresenta uma visão geral dessas ferramentas modernas. Planejamos adicionar workflows de exemplo a esta lição em uma data posterior. No entanto, esta lição já contém todas as informações de que você precisa para usar essas ferramentas e passar no exame de badge.
Visão geral
As primeiras primitives do IBM Quantum, como Estimator e Sampler, expunham a mitigação de erros por meio de um pequeno número de níveis predefinidos. Versões posteriores ofereceram controle mais direto sobre técnicas individuais, incluindo escolhas da estratégia de extrapolação de ruído zero, configurações de Pauli twirling e parâmetros de randomização. No entanto, essas configurações continuaram em grande parte globais, aplicadas uniformemente a todo o circuito.
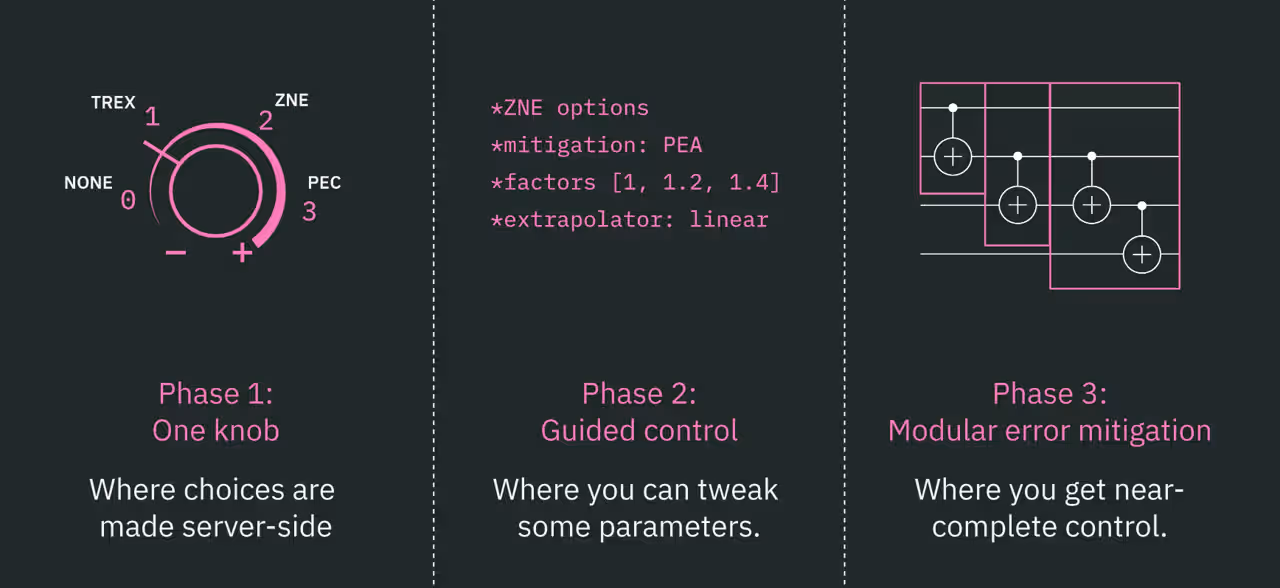
À medida que as cargas de trabalho quânticas se tornam mais sofisticadas, os desenvolvedores precisam cada vez mais da capacidade de adaptar as estratégias de execução e mitigação a regiões específicas de um circuito. O diagrama a seguir descreve várias ferramentas importantes discutidas nesta lição e mostra onde elas se encaixam em um workflow típico.
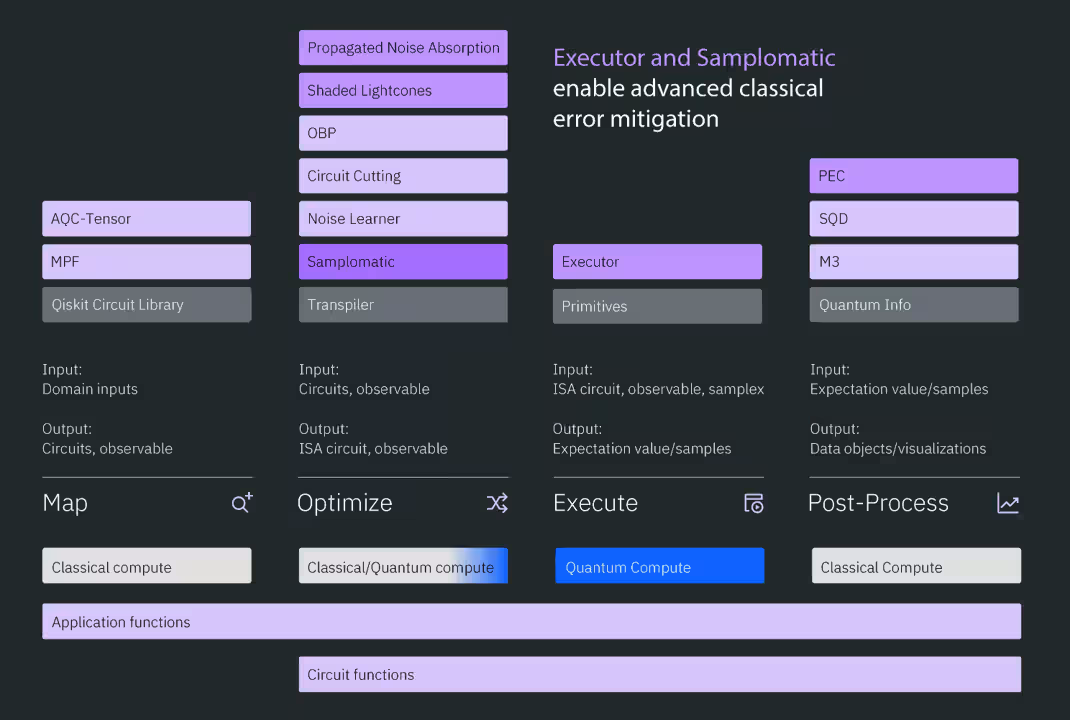
O modelo de execução direcionada atende à necessidade de controle modular sobre a execução e integra muitas dessas ferramentas.
Modelo de execução direcionada
Em vez de tomar decisões de execução implícitas, o modelo de execução direcionada segue diretivas fornecidas pelo usuário. Essa abordagem melhora a transparência e facilita a inspeção e a depuração de workflows complexos. Alguns dos principais recursos desse modelo incluem:
-
Configuração por camada por meio de regiões rotuladas do circuito
-
Identificação de camadas únicas e repetidas para um aprendizado de ruído eficiente
-
Workflows de execução em lote
-
Pós-processamento estruturado
-
Integração estreita com addons como os shaded lightcones
O modelo é construído em torno de dois componentes principais:
-
Samplomatic, que define receitas de execução
-
Executor, que executa essas receitas e retorna amostras
A maioria dos workflows que usam o Executor também pode ser implementada com o Sampler, porque ambos produzem amostras no final das contas. A principal vantagem do Executor é a eficiência. Tarefas como gerar configurações de twirling costumam ser muito mais rápidas no ambiente near-time do lado do servidor do que no cliente. Estimator e Sampler continuam com suporte e podem ainda ser a escolha mais conveniente para muitas cargas de trabalho.
Antes da execução, porém, você precisa construir e preparar um circuito. O Qiskit oferece vários addons que ajudam na geração, simulação e otimização de circuitos. Para saber mais sobre qualquer uma das ferramentas a seguir, acesse os links.
Construa circuitos quânticos
Para algumas aplicações ou novas abordagens, os usuários precisam determinar como mapear seu problema para um circuito quântico. Em muitos domínios, porém, os addons do Qiskit podem automatizar partes importantes desse processo.
Optimization mapper
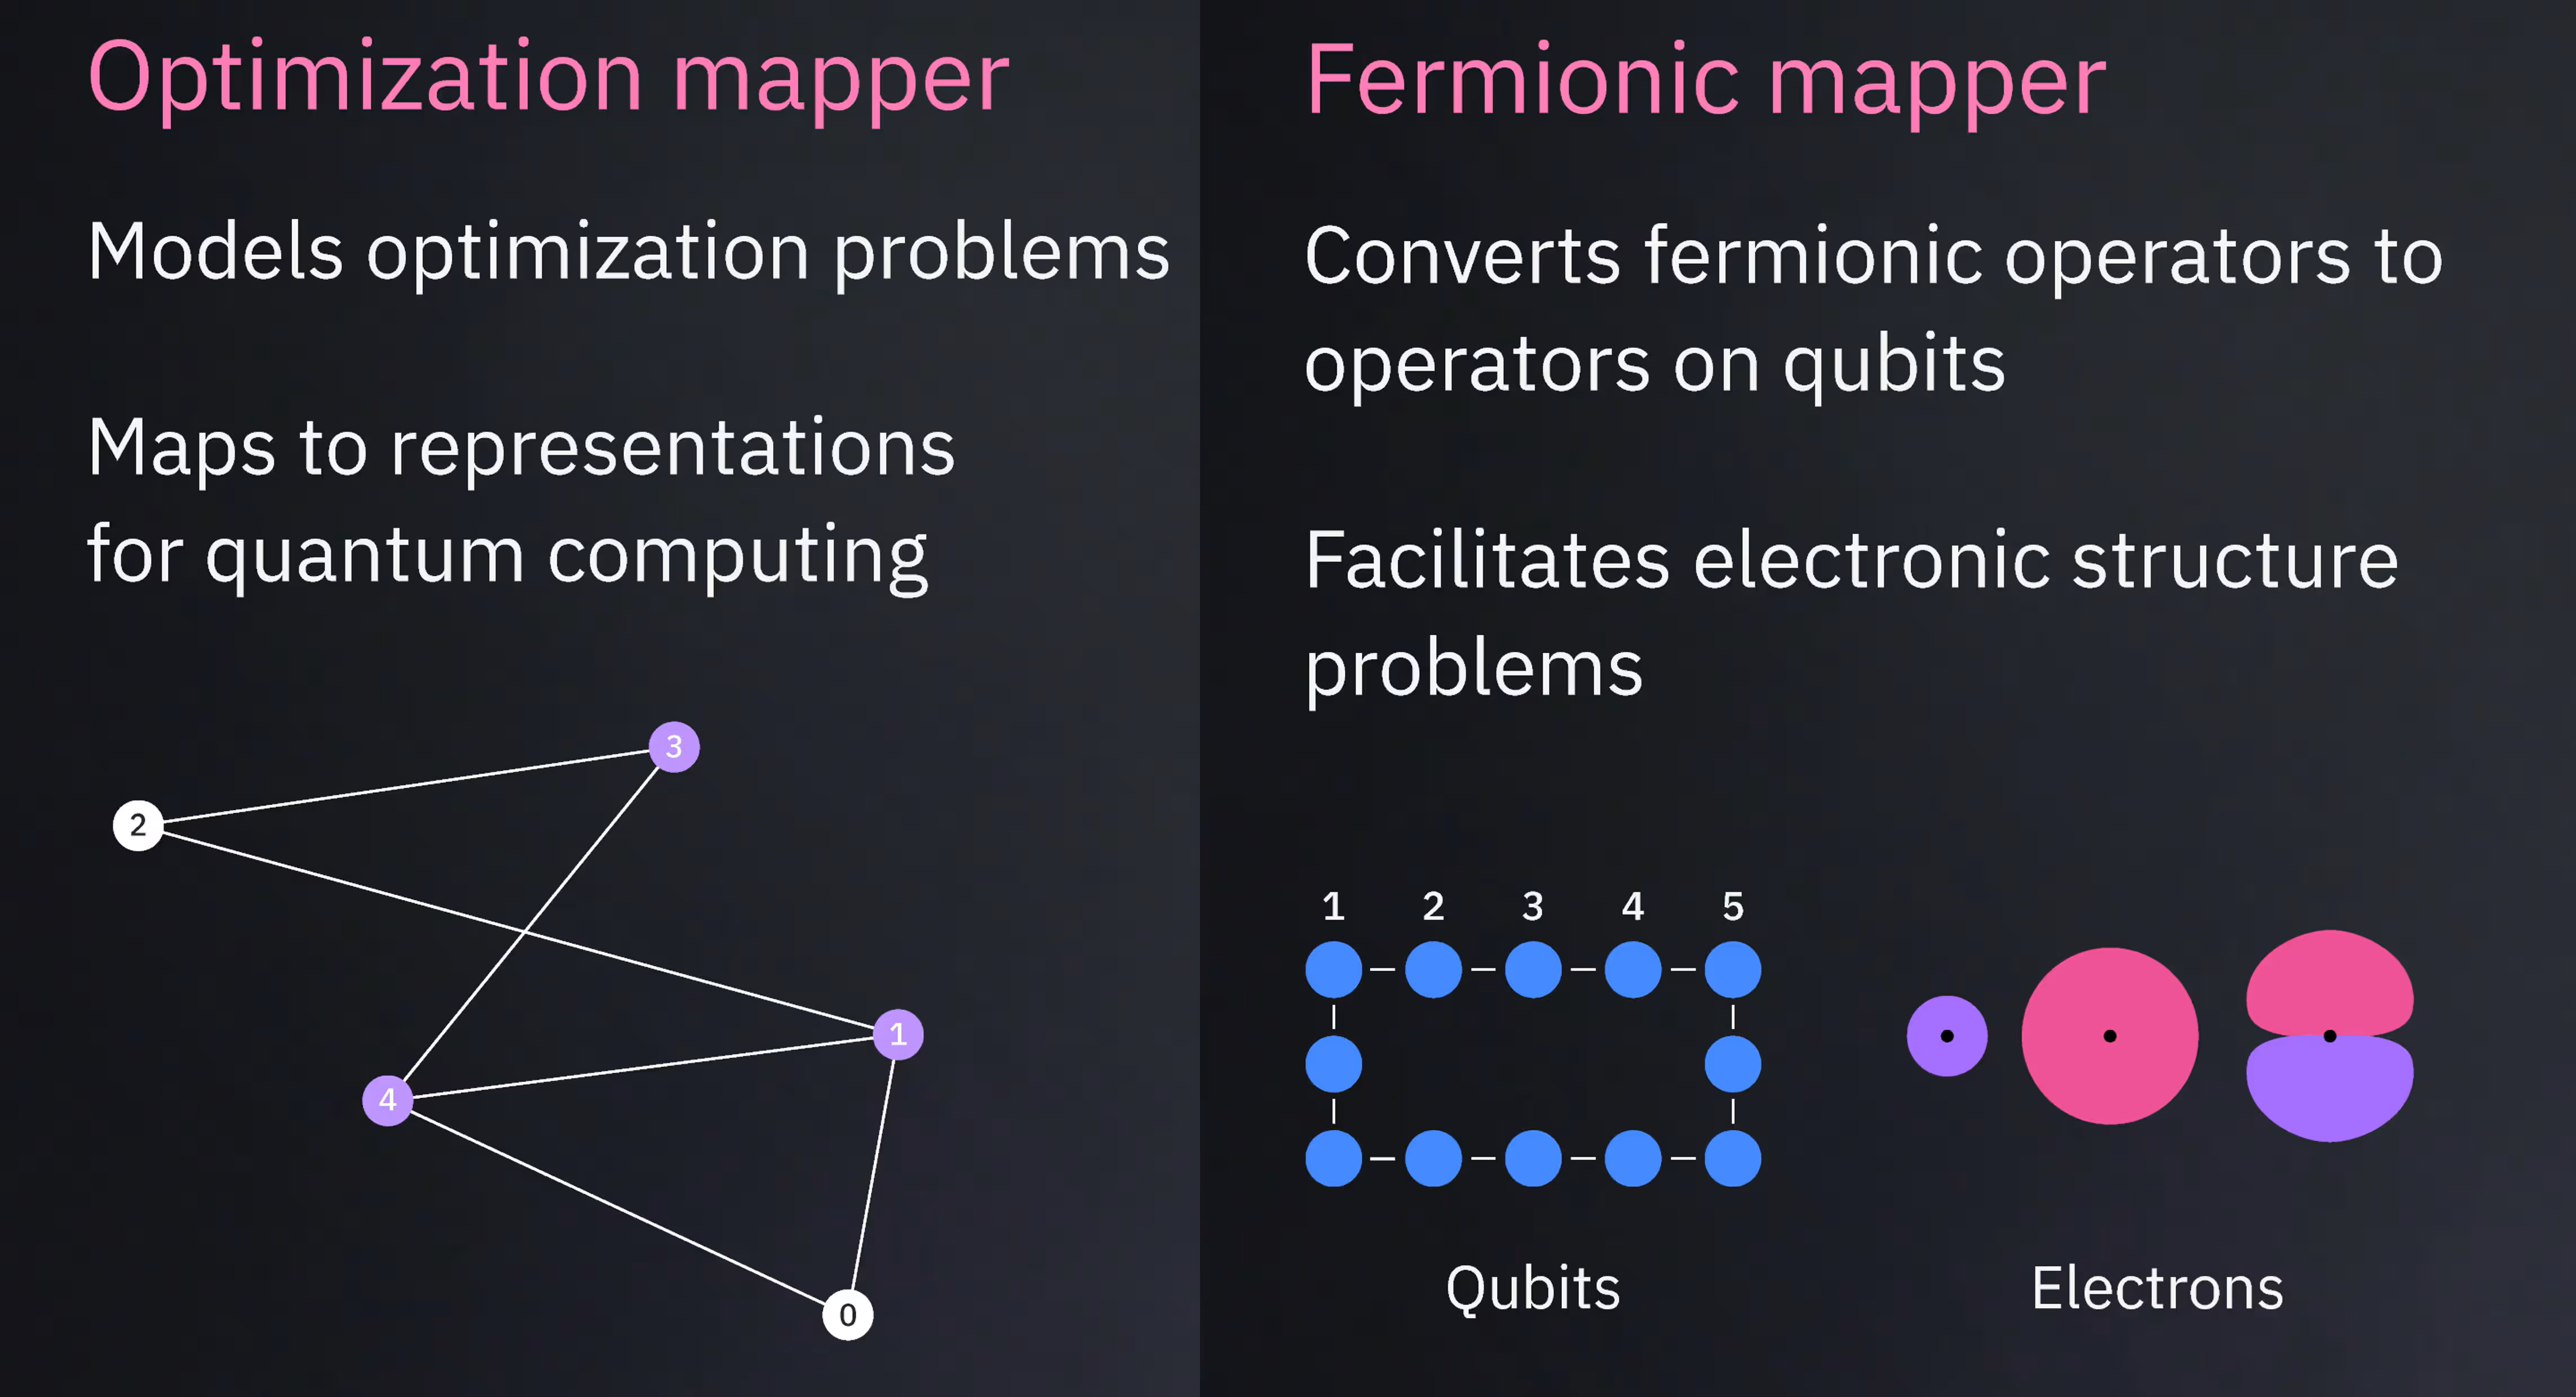
O Optimization mapper ajuda a expressar problemas de otimização clássicos em formas adequadas para algoritmos quânticos. Os principais recursos incluem:
-
Construir funções objetivo e restrições
-
Converter problemas em formulações QUBO
-
Gerar representações de Hamiltoniano ou de operador
Fermionic mapper
O Fermionic mapper converte operadores fermiônicos em operadores de qubits adequados para hardware quântico. Ele oferece suporte a mapeamentos como Jordan-Wigner, que converte operadores sobre férmions indistinguíveis em operadores de Pauli sobre qubits distinguíveis, preservando a estatística fermiônica. Esse addon é útil para aplicações de química quântica e ciência dos materiais.
Os dois addons anteriores se concentram no mapeamento inicial da estrutura de um problema para um circuito quântico. É igualmente importante, porém, mapear com eficiência a evolução temporal de um processo em um circuito quântico e otimizar um circuito reduzindo sua profundidade. Os próximos addons tratam dessas tarefas.
Fórmulas multiproduto (MPF)
As fórmulas multiproduto melhoram a precisão de simulações quânticas de evolução temporal combinando várias aproximações. Especificamente, você cria circuitos com números variados de passos de Trotter, de modo a poder usar uma combinação ponderada dos resultados dos circuitos. Para uma dada precisão alvo, o MPF muitas vezes pode usar circuitos mais rasos do que os métodos de Trotter padrão. O custo é que você precisa executar vários circuitos e combinar seus resultados de forma clássica.
AQC-Tensor
O AQC-Tensor realiza compilação quântica aproximada usando métodos de redes de tensores. Um caso de uso comum é substituir uma parte de um circuito profundo por uma aproximação variacional mais rasa. O circuito resultante pode alcançar precisão semelhante com profundidade significativamente menor.

Transpilação
Você já usou a transpilação muitas vezes neste curso. Você sabe que, depois que um circuito abstrato é construído, ele precisa ser preparado para execução em hardware. No entanto, ainda não exploramos em detalhe as várias etapas da transpilação.
As principais etapas da transpilação incluem:
-
Layout: mapear qubits lógicos para qubits físicos
-
Tradução: reescrever operações usando o conjunto de portas nativo do backend
-
Roteamento: inserir e otimizar as operações SWAP exigidas pela conectividade do hardware
Esses processos são inter-relacionados. Por exemplo, o layout deve minimizar a profundidade mesmo depois de levar o roteamento em conta. O layout também deve evitar os qubits e conexões mais propensos a erros. Essas etapas costumam ser automatizadas, mas usuários avançados podem optar por especificar layouts personalizados ou outras restrições quando necessário.

Para saber mais sobre transpilação, consulte o guia Introdução à transpilação.
Verifique seu entendimento
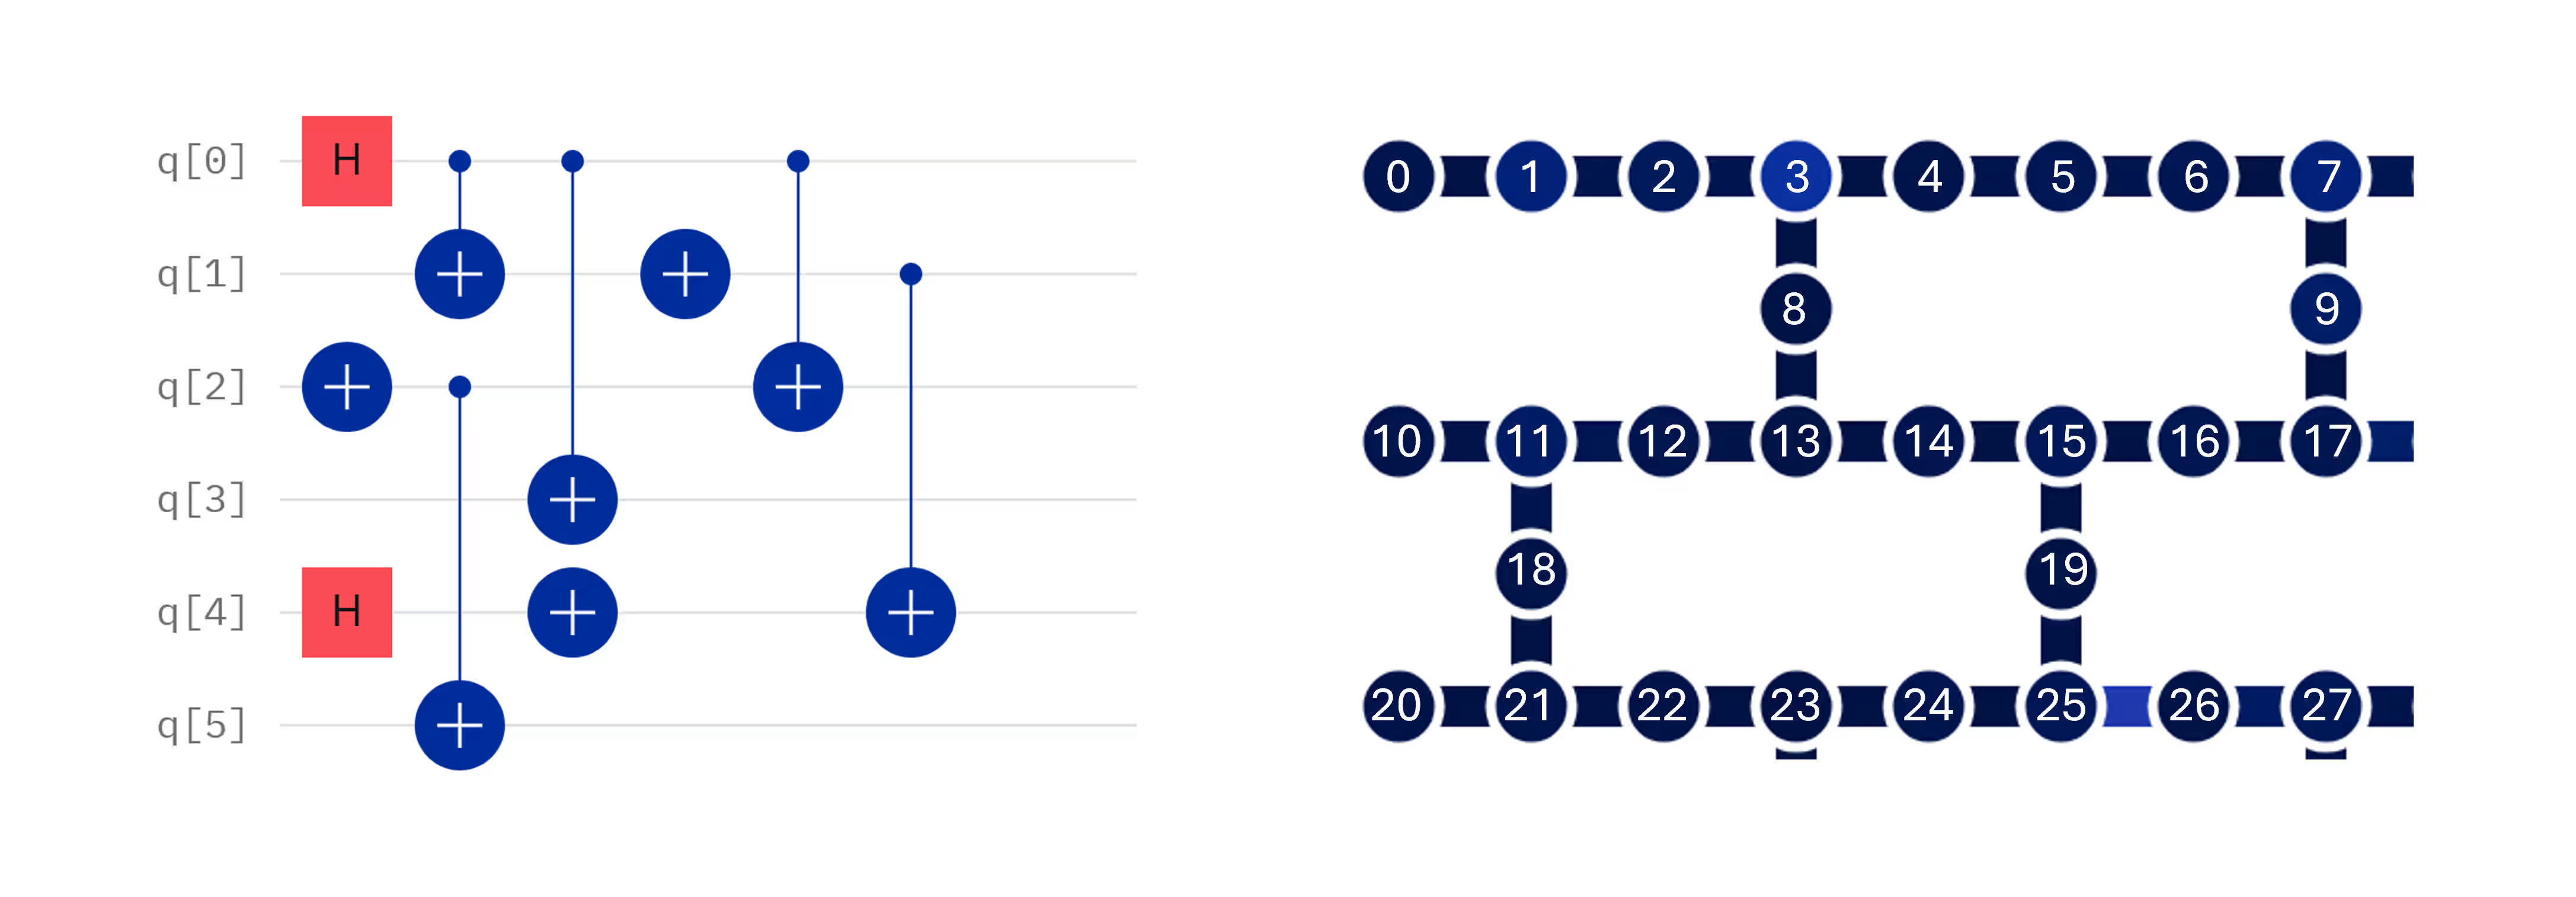
Observe o circuito quântico a seguir e suponha que você precise executá-lo em um computador quântico com layout heavy-hex, do qual uma parte é mostrada. (a) Proponha um mapeamento dos números de qubits do circuito abstrato para os números de qubits do computador quântico físico que minimize o número de portas SWAP necessárias. (b) Sua escolha é única, ou poderia haver outras escolhas igualmente boas? (c) Mesmo que sua escolha seja o único layout ótimo para reduzir portas SWAP, quais são alguns motivos pelos quais o transpiler poderia escolher um mapeamento diferente?
Resposta
(a) Pode haver muitas respostas corretas, mas observe que apenas o qubit abstrato 0 tem portas de emaranhamento (de dois qubits) com três vizinhos. Todos os outros participam de operações de dois qubits com apenas dois vizinhos. Esse circuito pode ser mapeado para uma topologia heavy-hex sem nenhuma porta SWAP. Qualquer layout que consiga isso é aceitável. Usando para se referir ao qubit abstrato zero e para o qubit transpilado zero, um desses layouts é:
(b) Esse layout não é único. Muitos outros layouts evitam portas SWAP por completo. Outro exemplo é:
(c) Às vezes um qubit específico é mais propenso a erros do que a maioria dos outros no chip. Além disso, algumas conexões entre qubits são mais propensas a erros do que outras. O transpiler tenta encontrar um layout que evite portas SWAP desnecessárias, mas que também use os qubits e as conexões de maior fidelidade disponíveis no computador quântico selecionado.
Reduza os efeitos do ruído e dos erros
Vários addons do Qiskit se concentram especificamente em reduzir o impacto do ruído e das imperfeições do hardware.
Retropropagação de operadores e transformações de circuito cientes de ruído
Já discutimos a propagação de operadores no contexto das verificações de Pauli coerentes na correção de erros. No entanto, a propagação de operadores é útil de forma mais geral. Há duas formas principais de usar a propagação de um operador por um circuito quântico: (1) absorver as últimas camadas de um circuito quântico nos observáveis que estão sendo medidos e (2) levar em conta os efeitos prováveis de erros no circuito e compensá-los medindo um observável diferente. As duas próximas ferramentas usam essas abordagens.
Retropropagação de operadores
A retropropagação de operadores reduz a profundidade do circuito absorvendo portas do final de um circuito no observável medido. Por exemplo, considere o circuito a seguir.

Esse circuito contém camadas de rotação e de emaranhamento que parecem não triviais, seguidas por uma escada de portas CNOT e uma medição de Z no qubit 5. Esse circuito tem uma profundidade de dois qubits igual a 7. Essa profundidade é anterior à transpilação. Na prática, você normalmente aplica a retropropagação após a transpilação, mas este exemplo serve apenas para fins didáticos. Lembre-se de que existem regras para propagar um observável através de uma porta. Em particular, quando uma porta CNOT tem alvo e controle , um observável no qubit se torna quando propagado para trás através da porta CNOT: . Neste circuito de exemplo, se você propagar o observável para trás por toda a escada de portas CNOT, obtém o observável , ou, na notação padrão do Qiskit, simplesmente . Se medirmos esse observável em vez de apenas , podemos remover toda a escada de portas CNOT, o que reduz a profundidade de dois qubits de 7 para 2. Esse observável ainda exige uma medição em apenas uma base em cada qubit, então não aumenta o número de shots de que precisamos. Isso nem sempre acontece. Em geral, observáveis mais complicados exigem mais shots e, às vezes, mais medições em bases diferentes.
A estratégia geral da retropropagação de operadores inclui as seguintes etapas:
-
Encurtar o circuito executado
-
Substituir o observável original por um observável expandido
-
Trocar profundidade de circuito por maiores requisitos de amostragem
O circuito anterior é um exemplo óbvio em que a retropropagação é vantajosa. Em geral, porém, não é fácil identificar os circuitos que mais se beneficiam da retropropagação. Para decidir quando usar a retropropagação, verifique quanta profundidade você consegue remover do seu circuito e pondere essa redução em relação aos maiores requisitos de amostragem.
Absorção de ruído propagado (PNA)
A absorção de ruído propagado é estruturalmente semelhante à retropropagação de operadores. No entanto, em vez de propagar um operador para trás pelas portas ideais de um circuito, o PNA incorpora um modelo de ruído aprendido e propaga os efeitos do ruído diretamente para o observável. O PNA faz o seguinte:
-
Aprende o comportamento do ruído a partir do hardware
-
Propaga o modelo de ruído pelo circuito
-
Produz um observável modificado que compensa o ruído das portas
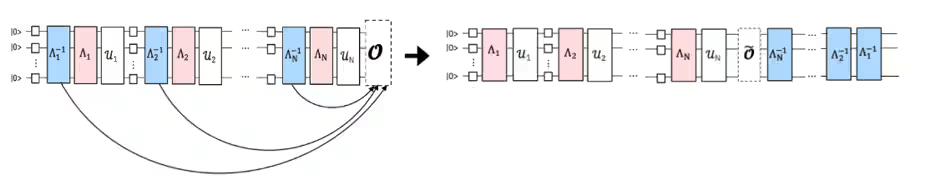
Quando o observável modificado é medido em hardware ruidoso, os valores esperados resultantes se aproximam melhor do resultado ideal sem ruído. O PNA tem dois tipos de overhead. Primeiro, você precisa aprender o modelo de ruído, o que exige executar circuitos adicionais. Segundo, o PNA pode produzir observáveis mais complicados, o que pode aumentar os requisitos de amostragem.
Corte de circuitos
O corte de circuitos divide um circuito grande em subcircuitos menores que podem ser executados de forma independente. Em seguida, você faz medições suficientes para recombinar os resultados. O corte de circuitos faz o seguinte:
-
Reduz os requisitos de hardware
-
Permite computações maiores do que o número de qubits disponíveis (circuitos mais largos)
-
Ajuda a contornar limitações de profundidade e conectividade (circuitos mais profundos)
-
Reconstrói o resultado original por meio de pós-processamento clássico

Samplomatic
Muitas das técnicas das seções anteriores complementam outros métodos de supressão e mitigação abordados ao longo deste curso, incluindo:
-
Desacoplamento dinâmico
-
Pauli twirling
-
M3
-
TREX
-
Extrapolação de ruído zero (ZNE)
-
Cancelamento probabilístico de erros (PEC)
Em muitos workflows, você pode aplicar técnicas diferentes a regiões diferentes do mesmo circuito. Como vimos, muitas dessas técnicas também trazem overhead quântico. Por isso, às vezes precisamos de um controle fino e detalhado sobre o aprendizado de ruído, a amostragem e a aplicação de sequências de twirling. Essas são algumas das motivações por trás do Samplomatic.
O Samplomatic é uma biblioteca de código aberto que permite workflows personalizados de amostragem, randomização e mitigação de erros.
Sua primeira tarefa é analisar um circuito e dividi-lo em regiões rotuladas, ou caixas. Essas caixas têm duas finalidades:
-
Elas dividem visualmente o circuito.
-
Elas criam regiões indexadas que podem ser configuradas de forma independente.
Os usuários podem anexar anotações que descrevem como cada caixa deve ser tratada durante a execução. Exemplos incluem:
-
Aplicar Pauli twirling a todas as caixas
-
Aplicar twirling apenas a caixas selecionadas
-
Usar diferentes grupos de twirling em diferentes regiões
-
Injetar ruído aprendido em camadas específicas
-
Personalizar estratégias de mitigação em um nível detalhado
O Samplomatic também identifica regiões em caixas repetidas. Como camadas idênticas normalmente apresentam características de ruído semelhantes, você só precisa realizar o aprendizado de ruído uma vez para cada camada única.
Saídas do Samplomatic
O Samplomatic produz dois objetos principais:
-
Circuito template
-
Samplex
O circuito template é um circuito em caixas, transpilado e parametrizado, pronto para execução. O samplex contém todas as informações necessárias para gerar e processar variantes do circuito. O conteúdo do samplex inclui:
-
Valores de parâmetros para circuitos parametrizados
-
Seleções de randomização
-
Distribuições de amostragem
-
Informações de pós-processamento
-
Metadados adicionais de execução
Formalmente, um samplex é uma distribuição de probabilidade sobre os parâmetros de um circuito template, junto com informações auxiliares necessárias para a execução e o pós-processamento. Uma vantagem prática importante é que tanto o circuito template quanto o samplex são criados localmente, no lado do cliente. Como resultado, você pode inspecioná-los, validá-los e depurá-los antes de usar qualquer recurso de hardware.
O Samplomatic tem muitos benefícios, incluindo controle detalhado da alocação adaptativa de shots e da randomização. Ele também traz benefícios logísticos, como fluxos de pós-processamento estruturados. Um dos benefícios mais importantes é a reutilização das informações de ruído aprendidas entre camadas idênticas, o que pode economizar uma quantidade significativa de tempo de computação quântica durante o aprendizado de ruído.
Lightcones sombreados
Antes de decidir onde aplicar técnicas de mitigação caras, é útil identificar as regiões de um circuito que mais importam para o observável que está sendo medido. Essa necessidade motiva o addon de lightcones sombreados. A ideia de lightcone vem da relatividade, na qual as relações causais são limitadas pela velocidade finita com que a informação pode viajar.
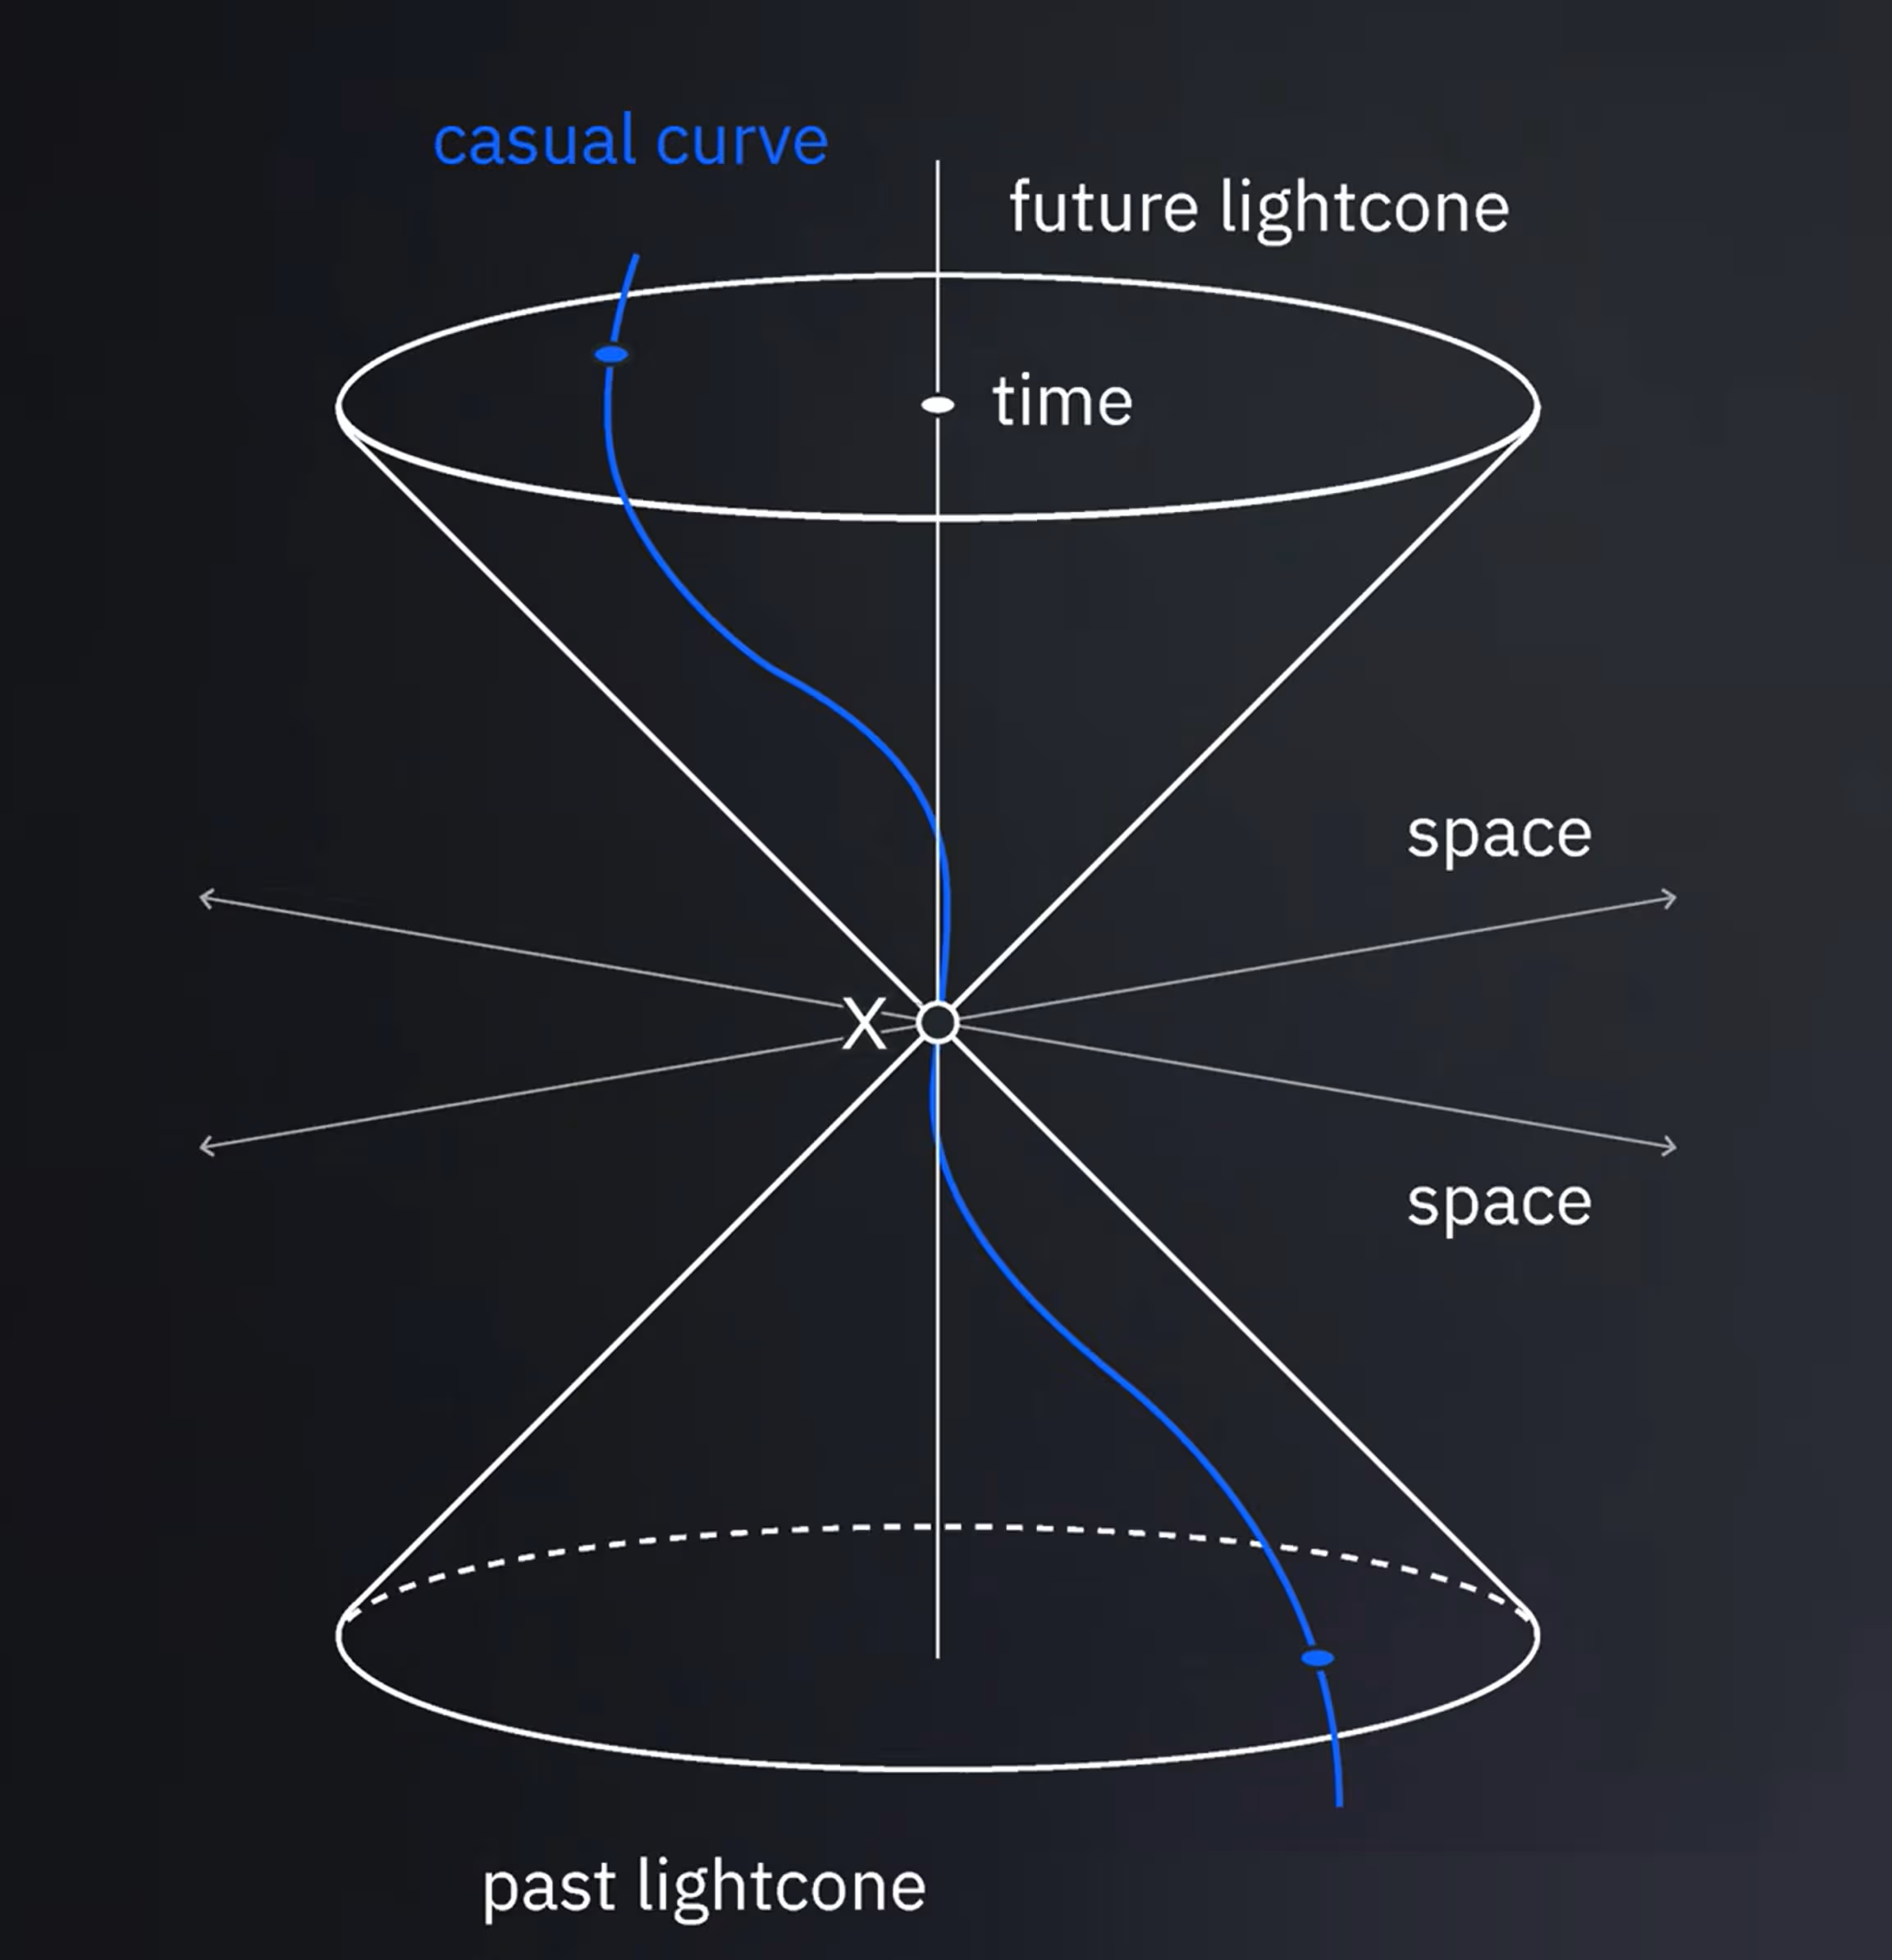
Um conceito semelhante se aplica a circuitos quânticos.
Considere um circuito grande em que apenas um observável de baixo peso é de interesse. Um observável de baixo peso atua de forma não trivial em apenas alguns qubits. Observáveis de baixo peso são de interesse por muitos motivos. Por exemplo, eles podem representar o seguinte:
-
Termos individuais dentro de um Hamiltoniano maior
-
Uma região de interação localizada
-
Informações coletadas em um pequeno conjunto de qubits ancilla
-
Outros observáveis que envolvem apenas alguns qubits
Nem todo erro no circuito pode afetar o resultado da medição. Isso vale especialmente para erros de Pauli, ou qualquer erro que possa ser modelado como um conjunto de operações de Pauli. Por exemplo, veja o circuito a seguir:
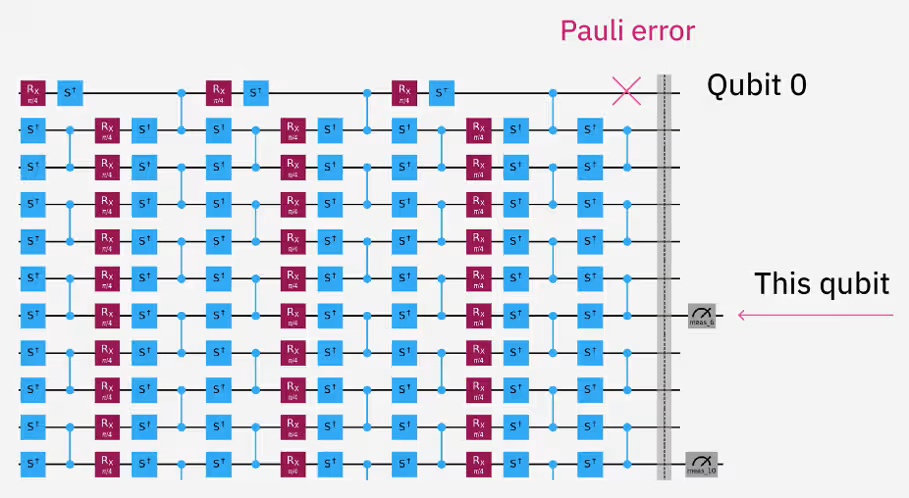
Um erro de Pauli no qubit 0 na última camada não pode influenciar a medição no qubit 6, porque não há nenhuma porta conectora que possa propagar o erro do qubit 0 para o qubit 6. Observe que esse argumento não se aplica a certos erros não unitários. Por exemplo, uma transição do tipo T1 para o estado fundamental no qubit 0 colapsa o qubit 0 para um estado da base computacional. Se os qubits 0 e 6 estivessem emaranhados anteriormente (como estão neste circuito), o erro não unitário no qubit 0 pode afetar o qubit 6. A discussão a seguir se concentra em erros que podem ser representados como operações de Pauli, ou como misturas probabilísticas de operações de Pauli.
Na última camada, apenas um erro de Pauli no qubit 5 ou no qubit 6 pode afetar diretamente a medição no qubit 6.
Na camada de emaranhamento anterior a essa, os qubits 5 e 6 estão emaranhados com os qubits 4 e 7, respectivamente. Portanto, nessa camada de emaranhamento ou logo antes dela, um erro de Pauli em qualquer um desses quatro qubits pode afetar a medição posterior. Você pode continuar rastreando o circuito para trás para encontrar o subconjunto de portas e qubits que estão causalmente conectados à medição. Esse conjunto causal forma uma região em formato de cone no espaço (qubits) e no tempo (camadas), o que dá origem ao termo lightcone. O formato exato da região varia de circuito para circuito. Como essa análise depende da conectividade do hardware e do posicionamento das portas, ela é mais útil após a transpilação, o roteamento e a otimização de layout.
Além da conectividade causal
Os lightcones sombreados estendem essa ideia ao considerar também quais tipos de erros importam.
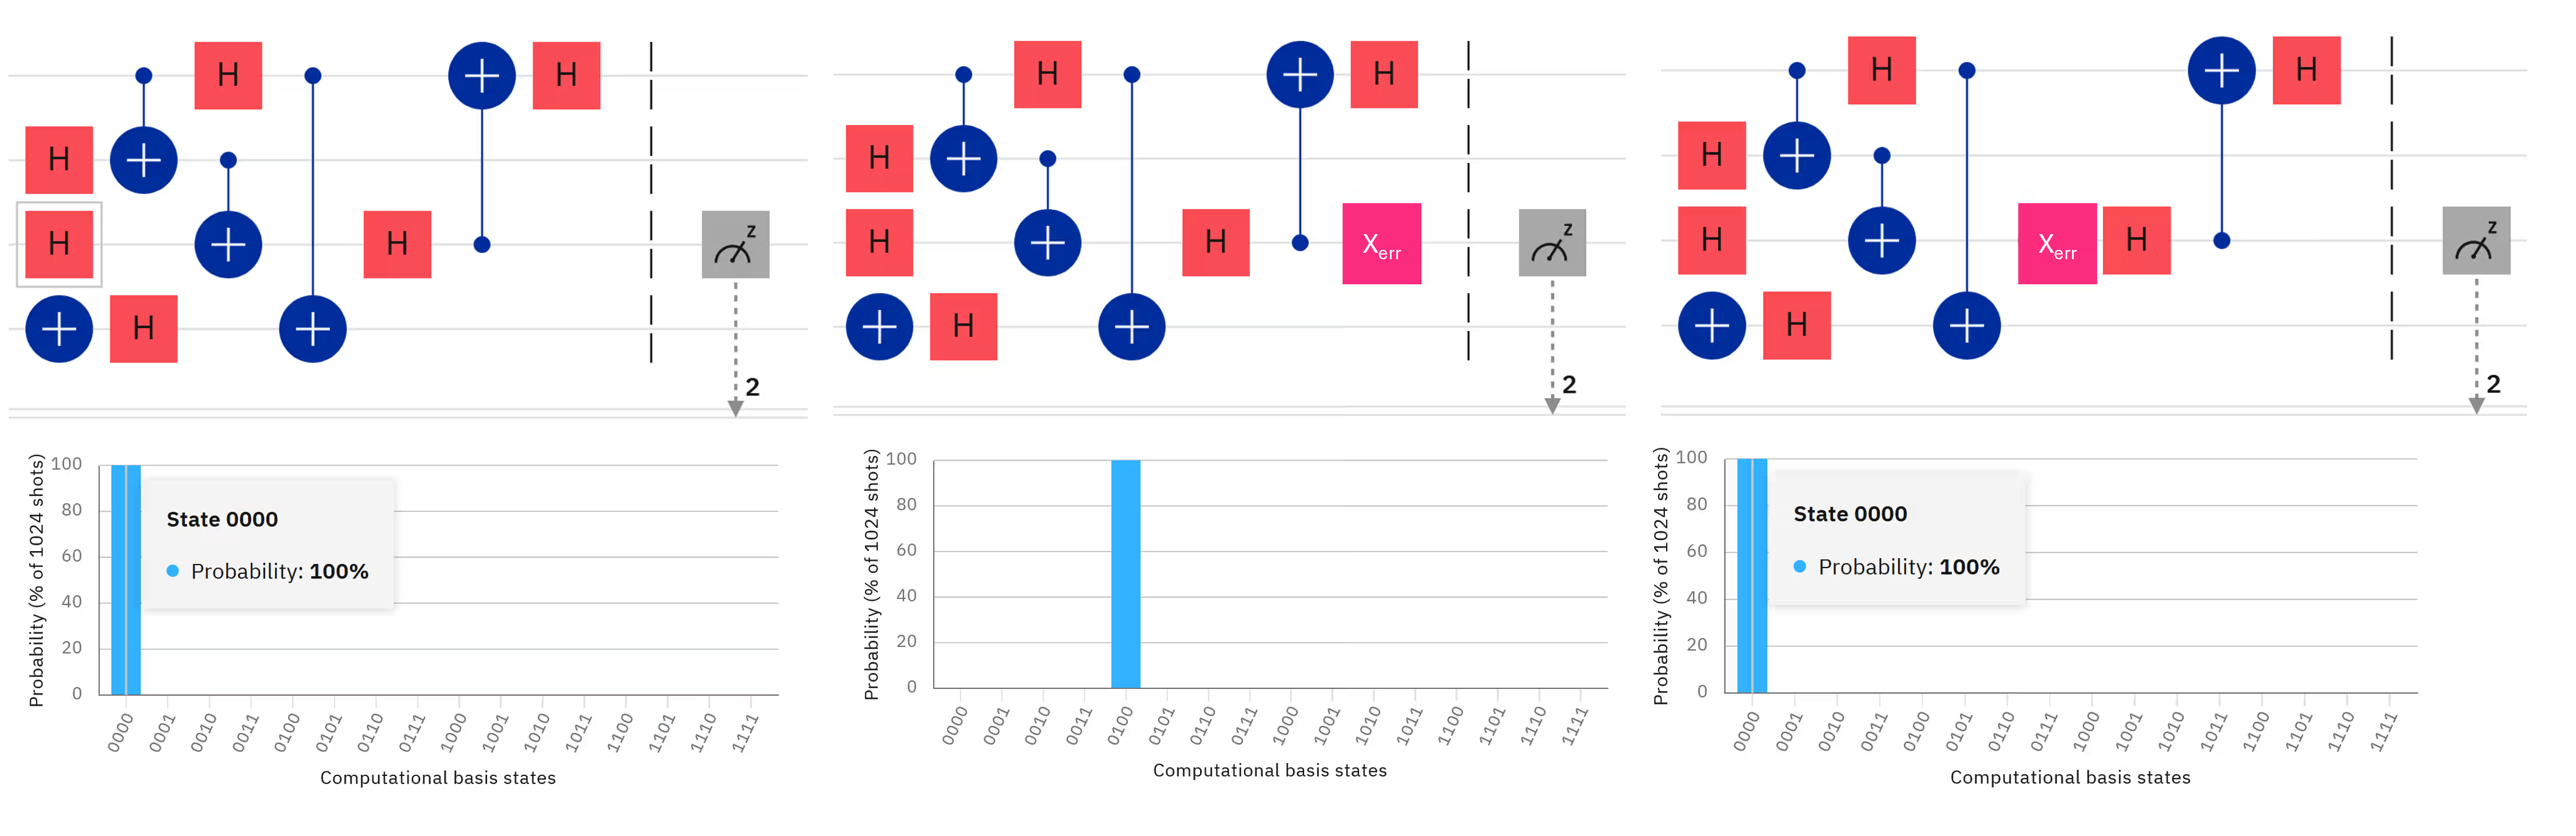
Por exemplo, observe o seguinte:
-
Um erro Z imediatamente antes de uma medição na base Z não tem efeito sobre o resultado da medição.
-
Um erro X imediatamente antes de uma medição na base Z pode mudar o resultado de forma drástica.
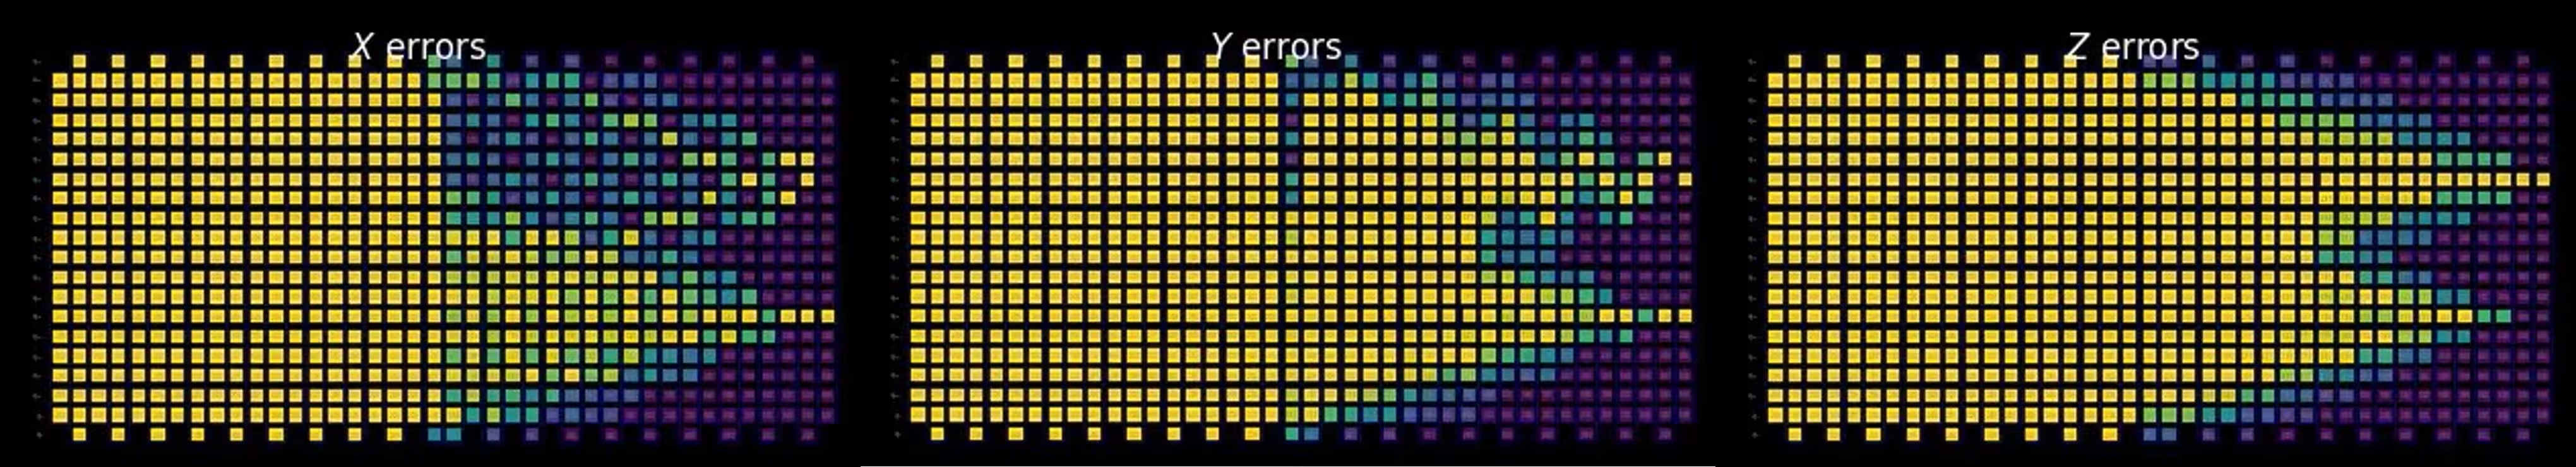
Portanto, alguns tipos de erro merecem mais esforço de mitigação do que outros. Essa distinção pode reduzir substancialmente o overhead de técnicas como PEC. Na prática, o addon gera análises de sensibilidade separadas para cada um dos seguintes tipos de erro:
-
X errors
-
Z errors
-
Erros Y (ou XZ a menos de uma fase)
Essa sensibilidade a erros geralmente tem aparência diferente para cada tipo de erro, porque diferentes erros causalmente conectados têm impactos diferentes na medição. Observe também que a sensibilidade muda ao longo do circuito. Um erro X imediatamente antes da medição pode ser altamente prejudicial, enquanto um erro que ocorre muitas camadas antes pode ter um efeito menor depois de se propagar por um estado altamente emaranhado.
Os lightcones sombreados quantificam essa diferença atribuindo um valor de sensibilidade a erros potenciais ao longo do circuito.
Os mapas resultantes indicam o seguinte:
-
Onde os erros importam
-
Quais tipos de erro importam
-
Com que intensidade eles influenciam o observável final
Os lightcones sombreados não mitigam os erros por si só, mas podem ajudar a concentrar o esforço de mitigação onde ele traz o maior benefício.
Aprender e injetar ruído
Depois que um circuito foi construído, otimizado e anotado, restam duas tarefas complementares: aprender o ruído e usar o modelo de ruído (por exemplo, para injetar ruído ou para propagar os efeitos do ruído).
NoiseLearnerV3
O NoiseLearnerV3 é a ferramenta atual para aprendizado de ruído. A interface NoiseLearner anterior aceitava circuitos inteiros e produzia modelos de ruído de Pauli-Lindblad. Já o NoiseLearnerV3 opera diretamente sobre instruções de circuito em caixas. Em resumo, o NoiseLearnerV3 faz o seguinte:
-
Aceita coleções de camadas de circuito rotuladas
-
Reutiliza informações de camadas repetidas
-
Oferece suporte ao aprendizado de ruído de medição
-
Oferece suporte ao pós-processamento de modelos aprendidos
-
Permite fluxos de injeção e escalonamento de ruído
Esse design se alinha de perto ao fluxo de trabalho orientado a camadas do Samplomatic. Em particular, o NoiseLearnerV3 usa os seguintes métodos para cada conjunto de instruções:
-
Aprendizado de Pauli-Lindblad para operações de porta
-
Aprendizado baseado em TREX para medições
Você pode então usar um modelo de ruído aprendido em muitos dos métodos que já vimos. Por exemplo, lembre-se de que a extrapolação para ruído zero (ZNE) com dobramento de portas pode levar a circuitos intratavelmente profundos. O método alternativo para escalar o ruído nesse caso era amostrar de um modelo de ruído conhecido, o que aumenta efetivamente o nível de ruído, até mesmo por fatores não inteiros. Esse método, a amplificação probabilística de erros (PEA), é um bom exemplo de como você pode usar um modelo de ruído para mitigar erros. Um bom modelo de ruído também é necessário para o cancelamento probabilístico de erros (PEC) e a absorção de ruído propagado (PNA).
Em resumo, com um modelo de ruído de alta qualidade, o ruído se torna um recurso programável, e não apenas uma fonte de erro.
Lightcones sombreados versus NoiseLearnerV3
O NoiseLearnerV3 e o SLC estão intimamente relacionados, mas recebem entradas distintas e respondem a perguntas diferentes. O SLC determina onde concentrar o esforço de mitigação. O NoiseLearnerV3 caracteriza o ruído real presente nessas regiões. Esses processos também envolvem tipos diferentes de overhead. A tabela a seguir resume essas diferenças.
| Lightcones sombreados | NoiseLearnerV3 | |
|---|---|---|
| Finalidade | Identifica onde a mitigação importa | Aprende como os erros se comportam |
| Overhead | Principalmente overhead clássico | Requer execuções em hardware |
| Saída | Produz mapas de sensibilidade | Produz descrições de canais de ruído |
| Entrada | Usa a estrutura do circuito e a propagação de operadores | Usa a estrutura do circuito e dados experimentais de hardware |
Executor e execução em runtime
O Executor realiza a etapa final de execução. Ele pode operar com qualquer uma das seguintes entradas:
-
Um circuito template e um samplex gerados pelo Samplomatic
-
Um circuito quântico convencional sem o Samplomatic
Com essa flexibilidade, você pode adotar tantos ou tão poucos componentes do fluxo de execução direcionada quanto precisar.
O Executor trabalha em conjunto com o Samplomatic, que gerencia as escolhas de randomização, a alocação de shots, as seleções de injeção de ruído e os metadados de execução relacionados, conforme descrito anteriormente.
Para exemplos práticos do modelo de execução direcionada, consulte o guia Modelo de execução direcionada, bem como os tutoriais e a documentação dos addons do Qiskit na IBM Quantum® Platform.
Conclusão
Os fluxos de trabalho quânticos modernos dependem cada vez mais de um conjunto de ferramentas complementares, em vez de uma única primitiva de execução.
Essas ferramentas dão suporte a todas as etapas do fluxo de trabalho:
-
Mapeamento do problema
-
Construção do circuito
-
Transpilação e otimização
-
Supressão de erros
-
Mitigação de erros
-
Aprendizado de ruído
-
Execução estruturada
-
Pós-processamento
Juntas, ferramentas como Samplomatic, Executor, NoiseLearnerV3, lightcones sombreados, absorção de ruído propagado, corte de circuitos e AQC-Tensor oferecem significativamente mais controle do que os modelos de execução anteriores.
O campo continua evoluindo rapidamente. À medida que os processadores quânticos se tornam maiores e mais conectados, é provável que essas técnicas tenham um papel cada vez mais importante para alcançar uma vantagem quântica útil e, eventualmente, para se integrar sem atritos a fluxos de computação quântica tolerante a falhas.