Supressão e moldagem de erros
Supressão de erros pode se referir a qualquer técnica que antecipe e tente evitar certos tipos de ruído e erros. Isso é mais fácil de explicar por meio de exemplos concretos, mas tenha em mente que esses métodos não se limitam aos exemplos mostrados aqui, e novos métodos estão sendo continuamente explorados. Às vezes não é possível suprimir erros, mas é possível afetar como eles se acumulam. Se pudermos fazer os erros se acumularem mais lentamente, podemos descrever isso como supressão do erro geral, mas é mais precisamente visto como moldagem de ruído. Nesta lição, abordamos exemplos canônicos de supressão de erros (desacoplamento dinâmico) e de moldagem/formatação de ruído (Pauli twirling).
Um vídeo para acompanhar esta lição será lançado nos próximos dias e será incorporado aqui.
Desacoplamento dinâmico
Vamos começar com um estado muito simples em um único qubit e introduzir um modelo de ruído simples. Isso é insuficiente para explicar completamente o desacoplamento dinâmico, mas nos dá um exemplo claro. Suponha que tenhamos um qubit preparado em um estado de superposição usando um gate Hadamard:
Este estado é visualizado na esfera de Bloch como mostrado abaixo à esquerda. No caso ideal com ruído zero, esse qubit permaneceria nesse estado até que a próxima operação fosse realizada. No entanto, sabemos pela lição anterior que não é isso que observamos. O ruído faz com que a informação quântica se degrade.
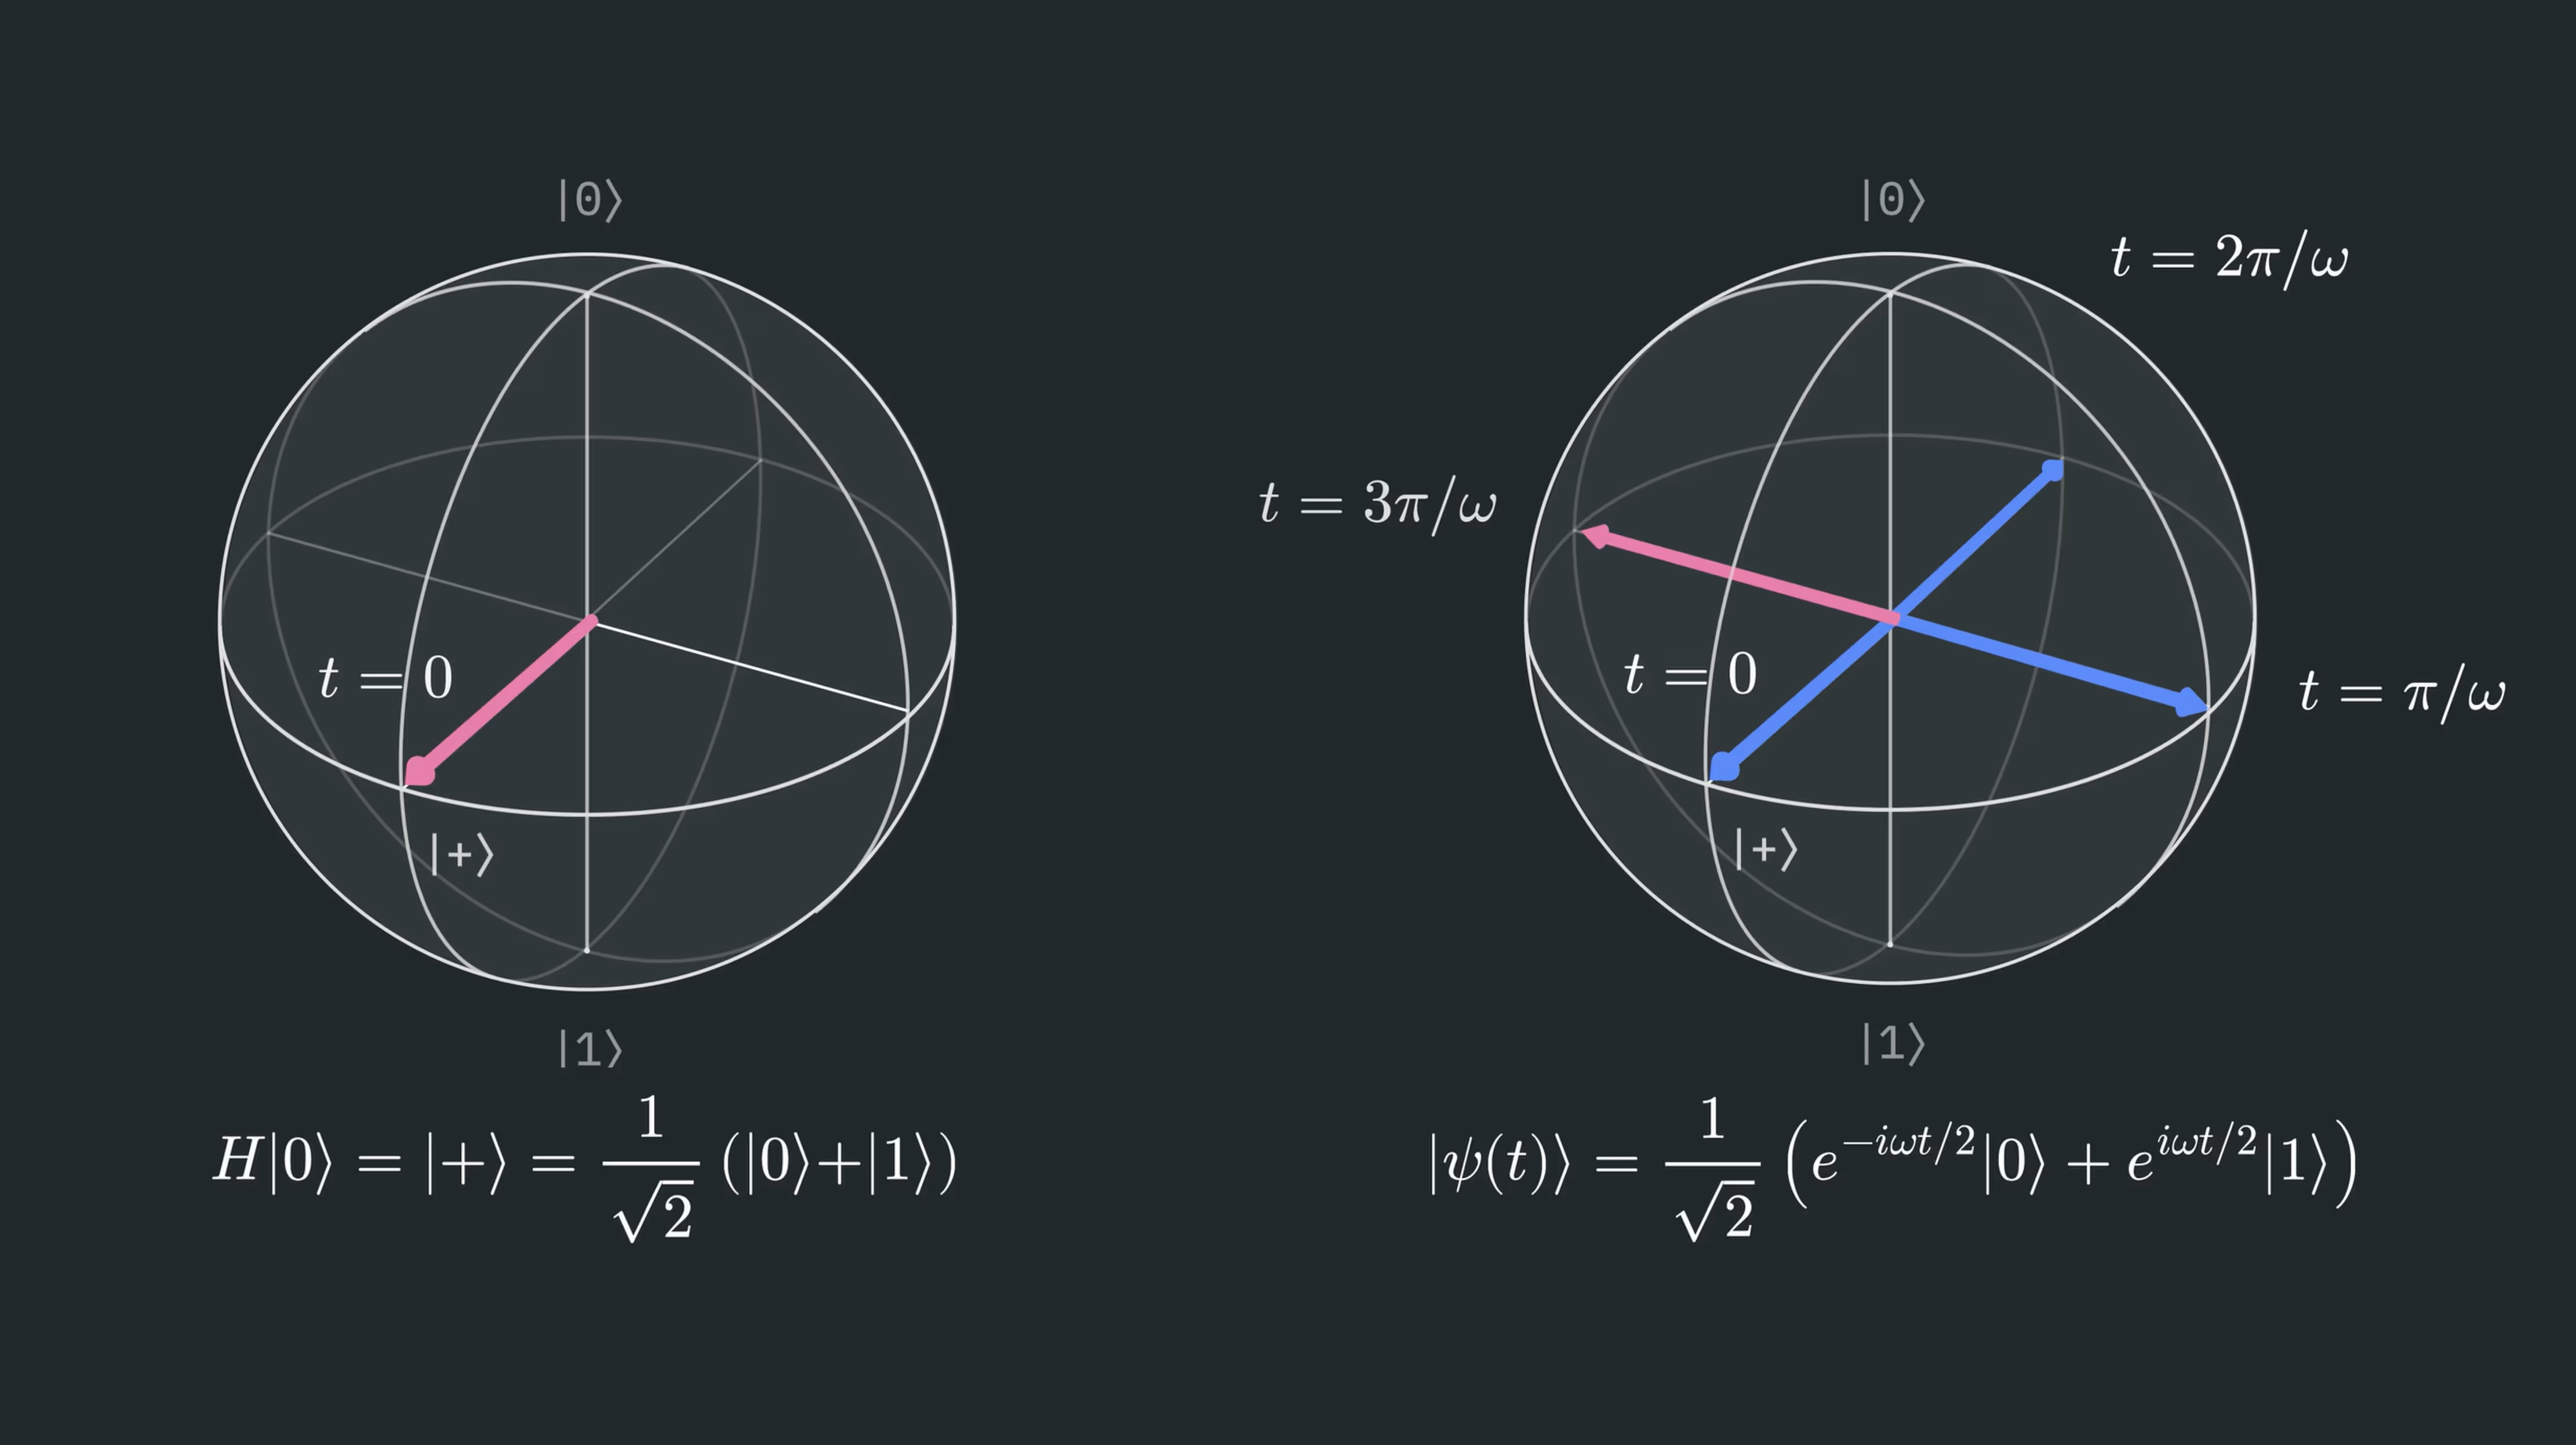
O ruído ou o acoplamento ambiental pode fazer com que a fase relativa entre os estados de base mude. Ou seja, as probabilidades de e não mudam, já que os valores absolutos de seus coeficientes não mudam. Em vez disso, as fases das amplitudes mudam, alterando seus componentes reais e imaginários. Para tornar essa discussão mais concreta, vamos considerar um tipo de interação que pode causar isso: acoplamento a um campo magnético orientado na direção Z: .
Considere o que acontece com o estado à medida que o tempo passa:
Aqui usamos o fato de que um campo magnético na direção Z causa precessão em torno do eixo Z com uma frequência que depende do momento magnético efetivo e da intensidade do campo magnético. Os detalhes são menos importantes do que o fato de que essa interação causa evolução em torno do eixo Z, resultando em acúmulo de fase oposto para os dois estados de base computacionais. Aplicando esse operador a cada termo em , encontramos o seguinte:
Essa fase dependente do tempo corresponde à precessão em torno do eixo Z na representação da esfera de Bloch. Isso é mostrado na metade direita da figura acima.
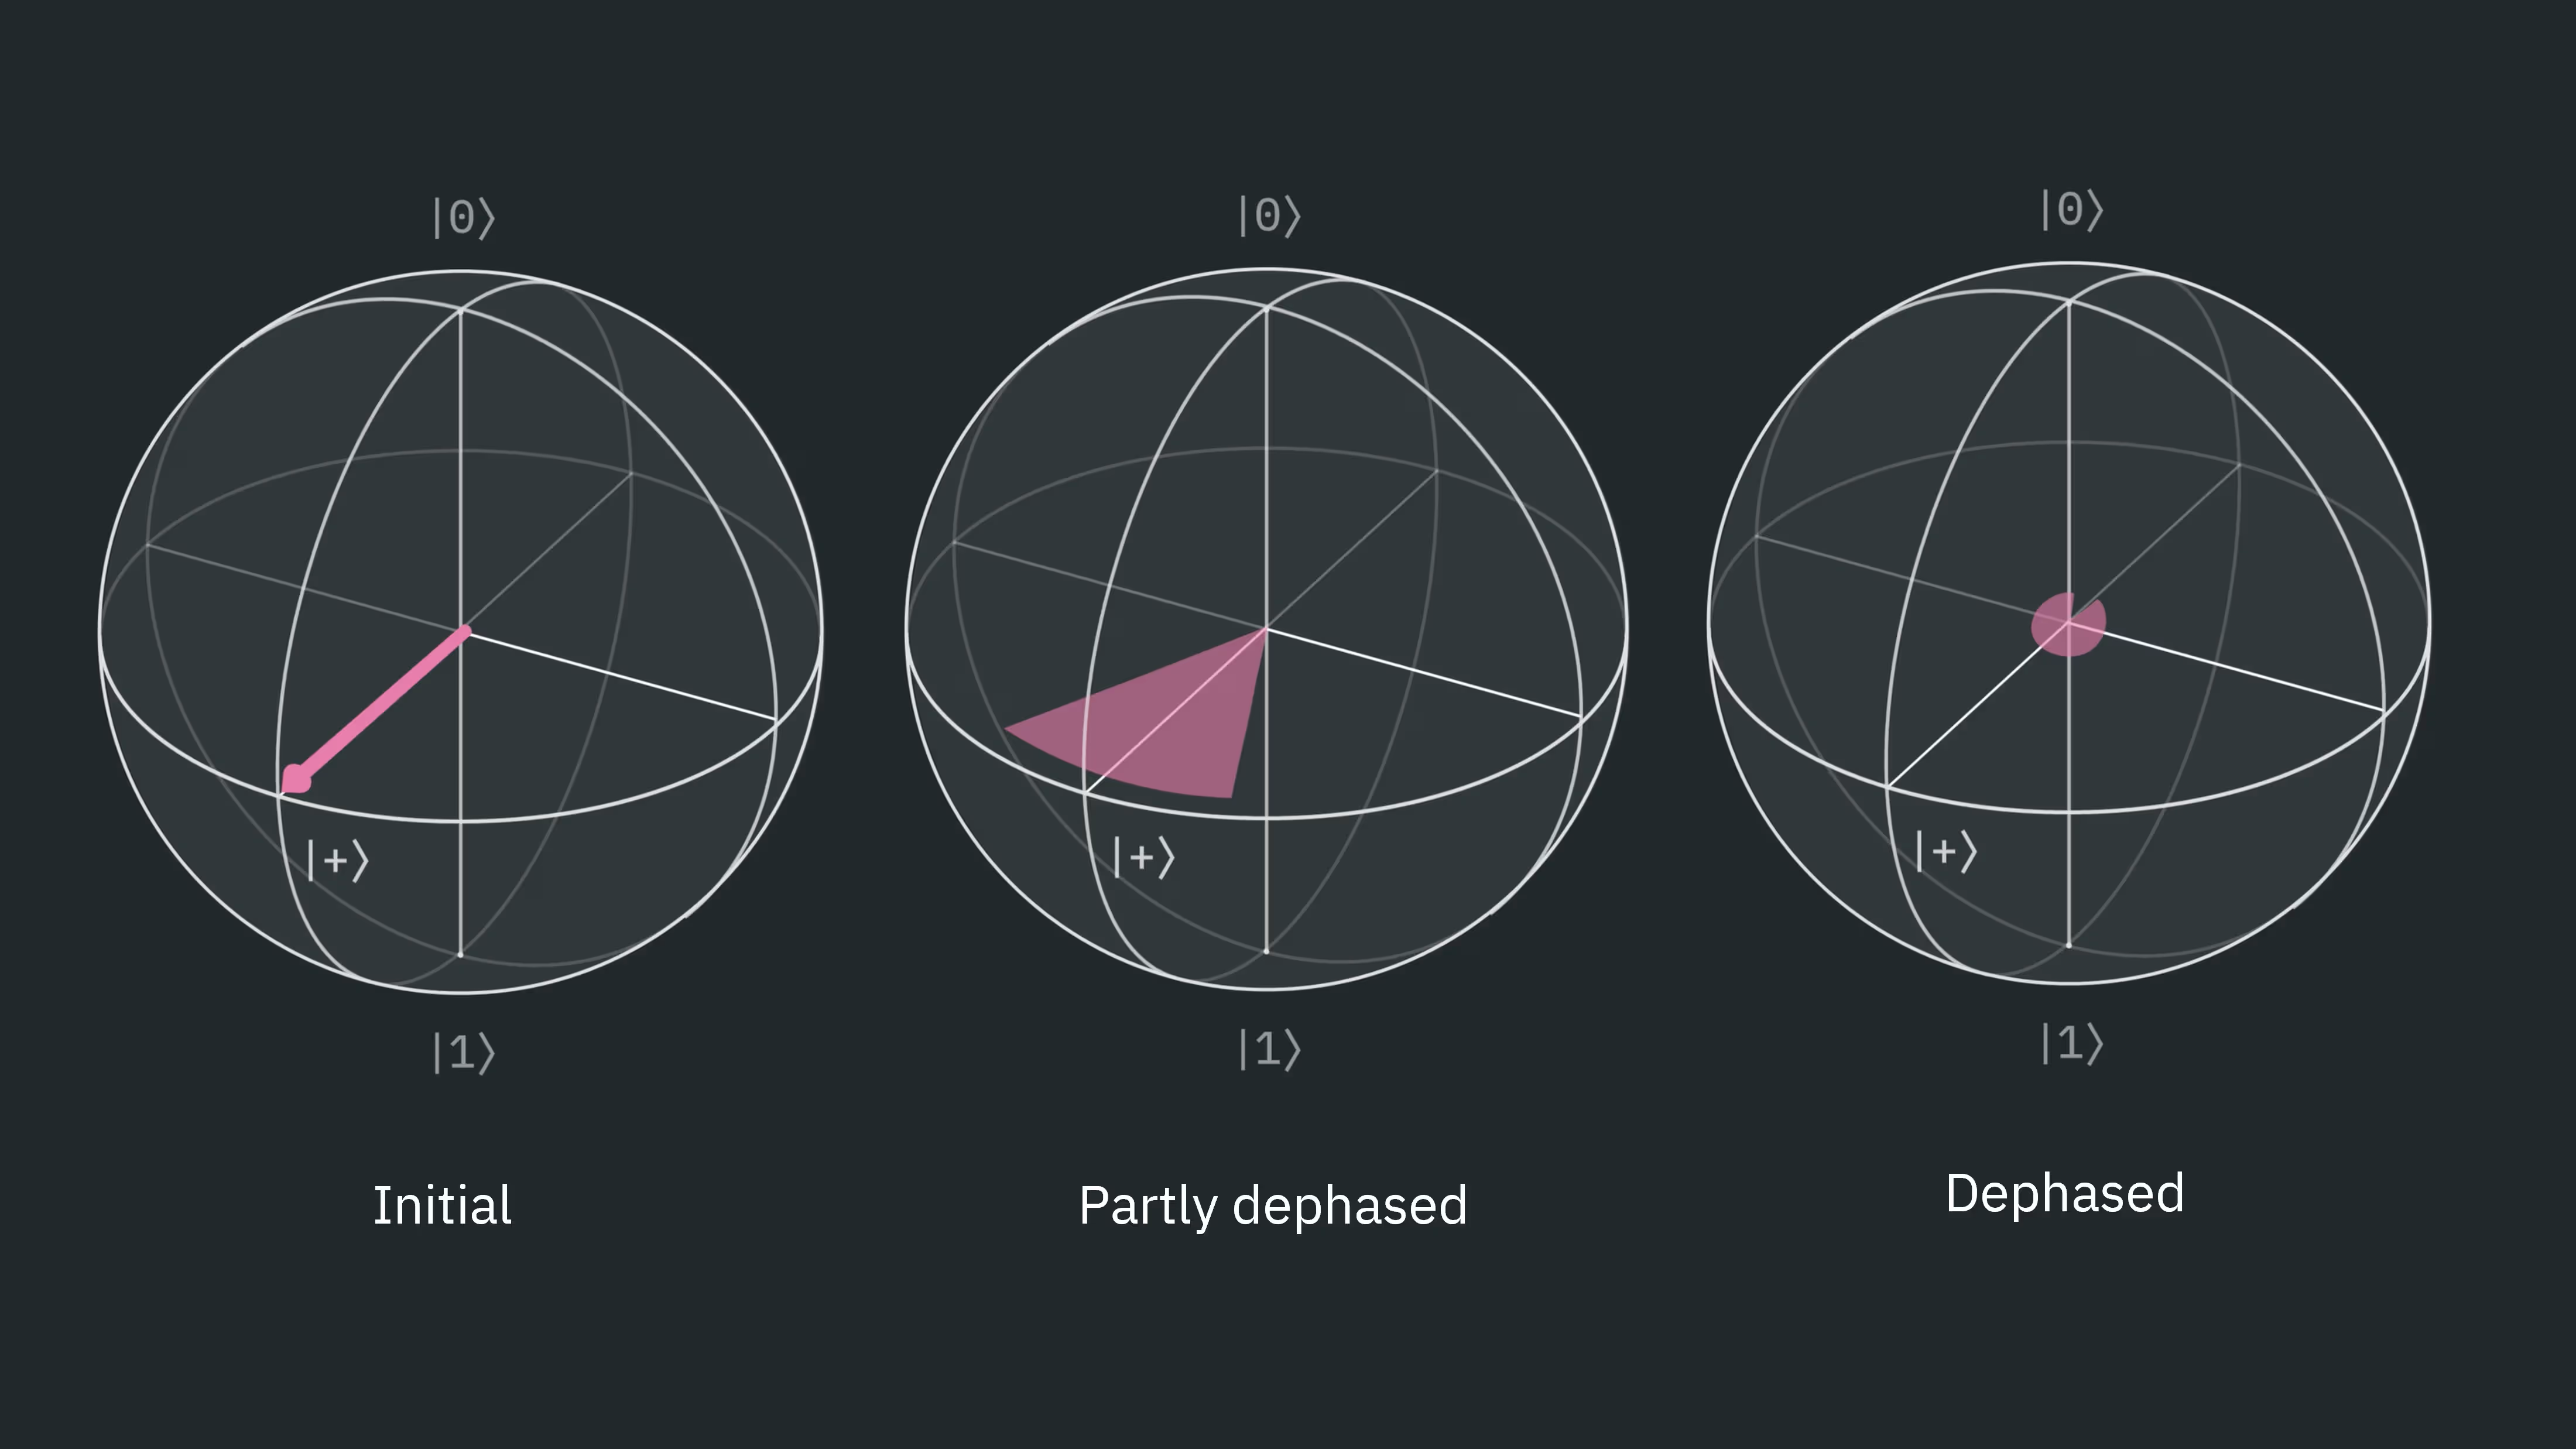
Se soubéssemos que essa interação estava ocorrendo de forma controlada, poderíamos prevê-la. Para modelar esse tipo de ruído, consideramos em vez disso uma distribuição de possíveis intensidades de campo magnético, cada uma ocorrendo com alguma probabilidade clássica (outras fontes de ruído precisariam ser modeladas de forma diferente). Precisamos considerar o que acontece quando há uma probabilidade clássica diferente de zero de que o estado não tenha rotacionado em nada, e também alguma probabilidade de que tenha rotacionado por uma pequena quantidade, ou até mesmo por uma grande quantidade. Essa distribuição de possíveis rotações é a razão para a dispersão do estado na representação da esfera de Bloch abaixo. Se houver mais desse ruído de defasagem, a fase ficará menos bem definida. No limite de forte defasagem, o qubit fica completamente defasado, correspondendo à perda da coerência quântica armazenada no estado.
Claro, em um experimento não temos ideia de qual acoplamento aleatório ocorrerá. O que podemos fazer a respeito?
Suponha que o acoplamento ambiental permaneça aproximadamente constante durante um intervalo de tempo . Considere o que aconteceria se seguíssemos esta prescrição:
-
Permitir que a fase mude por um tempo
-
Aplicar um gate X ao qubit
-
Permitir que o mesmo acoplamento ambiental ocorra por mais um tempo
-
Aplicar um segundo gate X
Após a evolução temporal inicial, teríamos exatamente o estado acima. Aplicando o primeiro gate X temos:
Agora, quando o segundo intervalo de passa, a mesma interação ocorre. Mas agora as amplitudes estão associadas aos autoestados Z opostos, o que significa que o sinal da rotação em torno do eixo Z se inverteu. Após deixar o sistema evoluir no tempo por mais , temos o estado:
E inserindo temos:
Aplicar o gate X final não faz nada neste caso, mas geralmente é necessário:
Recuperamos o estado quântico original, incluindo sua fase relativa. Este processo é um exemplo especialmente simples de desacoplamento dinâmico.
De forma mais geral, desacoplamento dinâmico (DD) envolve a inserção de alguns gates de um único qubit para reduzir o efeito de interações com sistemas fora do qubit (desacoplando-o do ambiente). O refoco completo de todos os históricos de fase possíveis de volta ao estado original, como mostrado acima, é um tanto idealizado, mas ainda é um cenário possível. Vamos discutir quando o DD é útil e quais ressalvas existem.
Verifique seu entendimento
No texto acima, percorremos o efeito de uma sequência DD XX no estado inicial . Verifique se os mesmos passos acima também retornam o estado ao seu estado inicial sob as mesmas suposições de um campo magnético que varia lentamente ao longo da direção z.
Resposta
Após a evolução temporal inicial, teríamos exatamente o estado acima. Aplicando o primeiro gate X temos:
Agora, quando o segundo intervalo de passa, a mesma interação ocorre. Mas agora as amplitudes estão associadas aos autoestados Z opostos, o que significa que o sinal da rotação em torno do eixo Z se inverteu. Após deixar o sistema evoluir no tempo por mais , temos o estado:
E inserindo temos
Aplicando o gate X final, temos:
Quando usar DD
A primeira e mais óbvia ressalva é que assumimos um canal puramente de defasagem em nosso tratamento. Interações do mundo real normalmente produzem uma mistura de defasagem e outros mecanismos de erro. No tratamento acima, escolhemos aplicar gates X especificamente. Isso é chamado de sequência XX no desacoplamento dinâmico. Essa sequência específica é apropriada para erros puramente de defasagem. Mas existem outras sequências que podem ser mais amplamente aplicáveis, como XY4 (mostrado no diagrama de circuito abaixo) e o mais complexo XY8.

Outra ressalva é que o desacoplamento dinâmico adiciona gates de um único qubit, que podem adicionar erros de um único qubit devido a imperfeições de gate ou até mesmo crosstalk. Essas taxas de erro de um único qubit são tipicamente muito mais baixas do que os erros de gates de múltiplos qubits, então isso geralmente não é uma grande preocupação, mas é algo a se ter em mente se muitos qubits estiverem usando DD muitas vezes ao longo do seu circuito.
O DD é útil quando o acoplamento externo tem tempo para afetar o estado do qubit. Como os qubits são cuidadosamente bem isolados e os acoplamentos externos devem ser fracos, esse tipo de ruído é mais perceptível quando um qubit fica ocioso por longos períodos. Para tempos ociosos curtos, o efeito do DD poderia ser adicionar erros de gate de um único qubit enquanto suprime muito pouco ruído; a fidelidade do seu circuito poderia realmente ser reduzida.
Conclusão principal: Use o desacoplamento dinâmico quando os qubits permanecerem ociosos por períodos suficientemente longos, e preste atenção ao tipo de sequência DD sendo usada.
Desacoplamento dinâmico usando Qiskit
Vamos explorar o uso de DD examinando o caso de vários qubits preparados no estado , que então permanecem ociosos por um longo tempo. Na ausência de erros, preparar o estado multi-qubit e depois aplicar um gate Hadamard antes da medição (medindo assim na base X) deveria sempre produzir 0. Com ruído, o resultado da medição será 0 apenas em uma fração do tempo, em vez de com 100% de probabilidade. Calculamos o valor esperado médio de X em vários qubits. Ou seja, estamos interessados no seguinte:
onde com o operador X na posição a partir da direita e é o estado de todo o sistema.
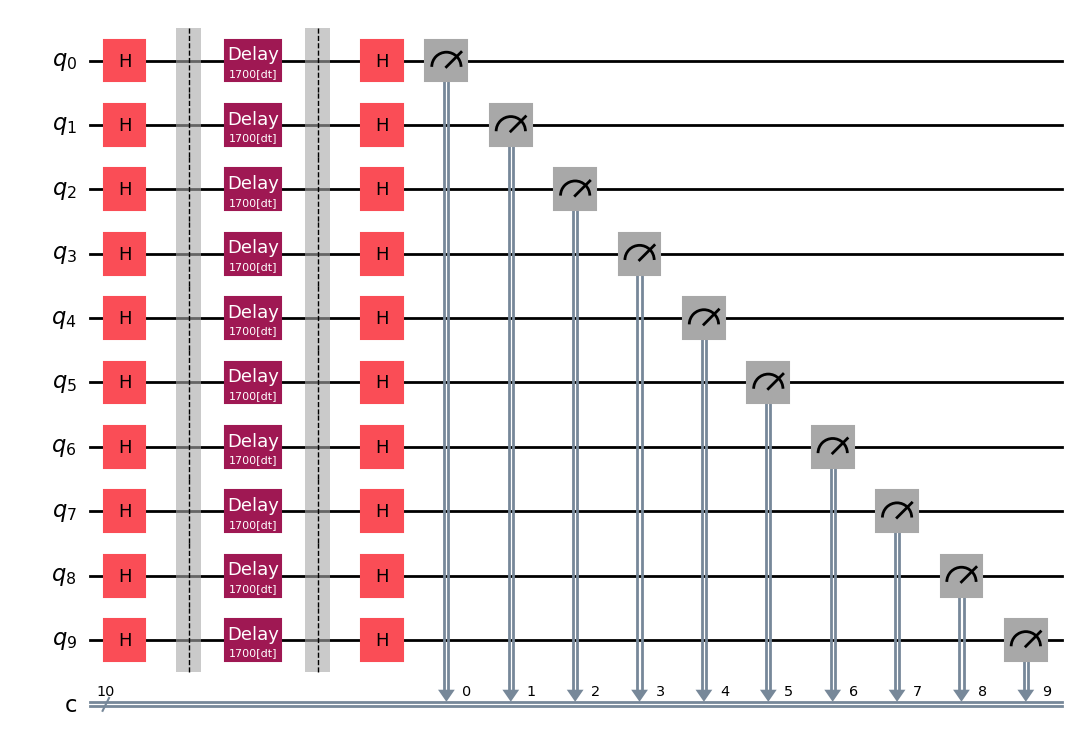
Este circuito contém atrasos intencionais, o que é um tanto artificial para um benchmark. No entanto, é muito comum que circuitos reais contenham qubits que ficam ociosos durante parte da execução. Você pode pensar nisso como um modelo simplificado de um circuito mais complexo no qual alguns qubits permanecem ociosos durante parte da computação. Esse tipo de benchmarking baseado na evolução de estados é frequentemente referido como Ramsey benchmarking.
Começamos carregando os pacotes necessários e configurando o serviço.
# Added by doQumentation — required packages for this notebook
!pip install -q matplotlib numpy qiskit qiskit-aer qiskit-ibm-runtime
# Load key packages

from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_ibm_runtime import SamplerV2 as Sampler
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager
from qiskit import QuantumRegister, ClassicalRegister, QuantumCircuit
import numpy as np

# --------- Configuration ----------

service = QiskitRuntimeService()  # assumes credentials are saved
backend = service.backend("ibm_fez")  # adjust if needed
Agora definimos algumas funções auxiliares. Primeiro, queremos abordar o ponto sobre longos tempos ociosos. O que exatamente significa "longo" nesse contexto? Poderíamos simplesmente relatar o tempo ocioso em microssegundos. No entanto, é útil saber quantos gates de dois qubits poderiam ser executados durante esse mesmo intervalo. Isso torna os tempos ociosos mais diretamente indicativos da profundidade do circuito que poderia ter sido executada durante o mesmo período. A primeira função auxiliar obtém o gate de dois qubits nativo do backend e determina a duração desse gate.
A segunda função simplesmente cria um circuito Ramsey (um com qubits no estado ), implementa um atraso, rotaciona usando um gate H e depois mede. Lembre-se de que um gate Hadamard (H) mapeia para , então medir na base Z após o Hadamard corresponde ao qubit ter estado em imediatamente antes do Hadamard.
Nossa função final converte as contagens brutas de resultados de medição 0 e 1 em um valor esperado de X.
from typing import Tuple
from qiskit.providers import Backend
from numpy.typing import NDArray

# --------- Utilities ----------
def detect_twoq_gate_and_duration(
    backend: Backend, pair: tuple[int, int] = (0, 1)
) -> Tuple[str, float]:
    props = backend.properties()
    candidates = ["cx", "ecr", "cz"]
    for name in candidates:
        try:
            dur = props.gate_length(name, list(pair))
            if dur is not None:
                return name, dur
        except Exception:
            pass
    raise RuntimeError(
        "Could not find a two-qubit gate duration among cx/ecr/cz on this backend."
    )

def make_multiqubit_ramsey_circuit(n: int, delay_dt_ticks: int) -> QuantumCircuit:
    q = QuantumRegister(n, "q")
    c = ClassicalRegister(n, "c")
    qc = QuantumCircuit(q, c)

    qc.h(q)
    qc.barrier()

    for i in range(n):
        qc.delay(delay_dt_ticks, q[i], unit="dt")
    qc.barrier()

    qc.h(q)
    qc.measure(q, c)
    return qc

def counts_to_x_expectations(counts: dict[str, int], n: int) -> NDArray[np.float64]:
    total = sum(counts.values())
    if total == 0:
        return np.zeros(n)

    p0 = np.zeros(n, dtype=float)
    for bitstring, cnt in counts.items():
        bits_rev = bitstring[::-1]
        for i in range(n):
            if bits_rev[i] == "0":
                p0[i] += cnt
    p0 /= total
    return 2.0 * p0 - 1.0
Agora especificamos os detalhes do nosso teste, incluindo o número de qubits e a sequência de gates a ser usada no DD (neste caso XX). Observe especialmente que definimos o nível de otimização como zero. Na prática, você geralmente selecionaria um nível de otimização mais alto; aqui usamos o nível 0 para garantir que os efeitos dos erros visados pelo DD permaneçam visíveis. Finalmente, determinamos o tempo característico para gates de dois qubits neste backend e imprimimos alguns tempos relevantes.
n_qubits = 10  # number of qubits to test in parallel
shots = 4096
opt_level = 0  # we want to ignore optimization for now
num_steps = 6  # number of delay points
gates_per_step = 20  # "equivalent 2q gates" per step
dd_sequence = "XX"  # "XX" for your request; you might try "XY4" too

# --------- Derive timing: dt and 2q gate time ----------
dt = backend.dt  # seconds per dt
twoq_name, t2q = detect_twoq_gate_and_duration(backend, (0, 1))  # seconds
delay_unit_dt = int(round(t2q / dt))  # dt ticks equivalent to one 2q gate

print(f"Backend: {backend.name}")
print(f"dt = {dt*1e9:.3f} ns per tick")
print(f"Using 2q gate '{twoq_name}' with duration ~ {t2q*1e9:.1f} ns")
print(f"One 2q gate ≈ {delay_unit_dt} dt ticks")
Backend: ibm_fez
dt = 4.000 ns per tick
Using 2q gate 'cz' with duration ~ 68.0 ns
One 2q gate ≈ 17 dt ticks
Agora construímos nossos circuitos e os transpile para o backend escolhido.
# --------- Build circuits for a sweep of delays ----------
pm = generate_preset_pass_manager(optimization_level=opt_level, backend=backend)

equiv_gates_list = [
    j * gates_per_step for j in range(num_steps)
]  # e.g., 0, 100, 200, ...
delay_dt_list = [int(round(delay_unit_dt * m)) for m in equiv_gates_list]
delay_us_list = [(dt * d) * 1e6 for d in delay_dt_list]  # for printing/plotting

circuits = []
for delay_dt in delay_dt_list:
    qc = make_multiqubit_ramsey_circuit(n_qubits, delay_dt)
    qc_isa = pm.run(qc)  # ISA-level scheduling/placement; DD is handled at runtime
    circuits.append(qc_isa)

print("Delay sweep (approx microseconds):", [f"{t:.2f}" for t in delay_us_list])
Delay sweep (approx microseconds): ['0.00', '1.36', '2.72', '4.08', '5.44', '6.80']
Devemos visualizar pelo menos um circuito para garantir que codificamos nosso circuito com os estados e atrasos desejados. Pode ser mais fácil visualizar o circuito pré-transpile qc, ou você pode verificar o transpile qc_isa.
qc.draw("mpl")
Executar
Estamos finalmente prontos para executar em hardware. Usamos o Sampler para obter muitas medições de cada qubit, e o usaremos duas vezes: uma vez com o DD explicitamente desligado, e uma vez com o DD ligado e usando a sequência de gates XX.
# --------- Run: NO DD ----------
sampler = Sampler(mode=backend)
sampler.options.default_shots = shots
sampler.options.dynamical_decoupling.enable = False

job = sampler.run(circuits)
res_nodd = job.result()
job_id = job.job_id()  # job id for dd off/false
print("job number for no dd is ", job_id)

# --------- Run: WITH DD (XX) ----------
sampler = Sampler(mode=backend)
sampler.options.default_shots = shots
sampler.options.dynamical_decoupling.enable = True
sampler.options.dynamical_decoupling.sequence_type = (
    dd_sequence  # "XX" first; you can try "XY4" too
)
sampler.options.dynamical_decoupling.scheduling_method = "alap"
sampler.options.dynamical_decoupling.extra_slack_distribution = "middle"

job = sampler.run(circuits)
res_dd = job.result()
job_id = job.job_id()  # job id for dd on/XX
print("job number for dd using XX is ", job_id)
Podemos extrair as contagens dos vários circuitos.
# --------- Extract counts per circuit ----------

from typing import Iterable, Any

def extract_counts_list(res: Iterable[Any]) -> list[dict[str, int]]:
    counts_list: list[dict[str, int]] = []

    for r in res:  # each r corresponds to one circuit
        counts: dict[str, int] = r.data.c.get_counts()
        counts_list.append(counts)

    return counts_list

counts_list_nodd = extract_counts_list(res_nodd)
counts_list_dd = extract_counts_list(res_dd)
Pós-processamento
Agora temos as contagens da medição, mas queremos transformar isso no valor esperado de X e depois calcular a média desses valores esperados em todos os qubits que usamos, para aprender sobre a preservação da informação de fase. Para isso, usamos nossa função counts_to_x_expectations definida anteriormente.
# --------- Compute X-expectations and a scalar contrast ----------
# For each circuit (each delay), compute per-qubit <X> and average absolute contrast.

xexp_nodd = []
xexp_dd = []
contrast_nodd = []
contrast_dd = []

for counts in counts_list_nodd:
    x_vec = counts_to_x_expectations(counts, n_qubits)
    xexp_nodd.append(x_vec)
    contrast_nodd.append(float(np.mean(np.abs(x_vec))))  # average |<X>| across qubits

for counts in counts_list_dd:
    x_vec = counts_to_x_expectations(counts, n_qubits)
    xexp_dd.append(x_vec)
    contrast_dd.append(float(np.mean(np.abs(x_vec))))

# --------- Print a small summary ----------
print("\n=== Summary (average |<X>| per delay) ===")
for m, d_us, c0, c1 in zip(equiv_gates_list, delay_us_list, contrast_nodd, contrast_dd):
    print(
        f"Delay ~ {m:4d} * {twoq_name}  (~{d_us:7.2f} µs):  NoDD={c0: .3f},  DD({dd_sequence})={c1: .3f}"
    )

# Optionally, inspect per-qubit values for the last delay point
print("\nPer-qubit <X> (abs) at the longest delay:")
print("NoDD:", np.round(np.abs(xexp_nodd[-1]), 3))
print("DD  :", np.round(np.abs(xexp_dd[-1]), 3))
=== Summary (average |<X>| per delay) ===
Delay ~    0 * cz  (~   0.00 µs):  NoDD= 0.954,  DD(XX)= 0.961
Delay ~   20 * cz  (~   1.36 µs):  NoDD= 0.827,  DD(XX)= 0.927
Delay ~   40 * cz  (~   2.72 µs):  NoDD= 0.793,  DD(XX)= 0.900
Delay ~   60 * cz  (~   4.08 µs):  NoDD= 0.729,  DD(XX)= 0.876
Delay ~   80 * cz  (~   5.44 µs):  NoDD= 0.661,  DD(XX)= 0.854
Delay ~  100 * cz  (~   6.80 µs):  NoDD= 0.586,  DD(XX)= 0.826

Per-qubit <X> (abs) at the longest delay:
NoDD: [0.05  0.744 0.712 0.867 0.844 0.234 0.473 0.755 0.59  0.587]
DD  : [0.583 0.89  0.921 0.88  0.908 0.832 0.893 0.773 0.807 0.773]
Finalmente, vamos plotar nossos resultados.
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values with no DD
ax.scatter(
    equiv_gates_list, contrast_nodd, c="blue", linestyle="-", label="No DD", alpha=0.7
)

## Add values with DD
ax.scatter(
    equiv_gates_list, contrast_dd, c="red", linestyle="-", label="With DD", alpha=0.7
)

# Add labels and plot
ax.set_xlabel("Idle Time in # of 2-qubit gates")
ax.set_ylabel("<X>")
ax.legend()
ax.set_title("Dephasing and DD")
ax.grid(True)

plt.show()
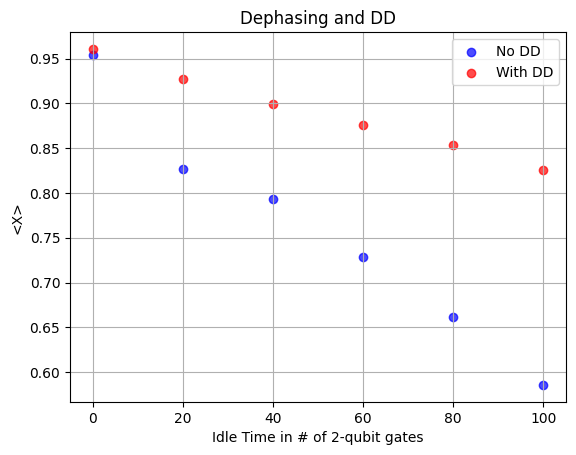
Como você pode ver, sem atraso explícito, os valores esperados estão de fato próximos de 1, o que esperaríamos se toda a informação de fase fosse preservada. Se toda a informação de fase fosse perdida, não haveria preferência para a rotação final produzir em vez de , e o valor esperado médio se aproximaria de zero. Nos dados, vemos que, à medida que os tempos de atraso aumentam, o valor esperado médio de X diminui, começando a se aproximar de zero. Observe que o DD foi muito eficaz aqui; os valores esperados com DD são tipicamente mais de 20% melhores (mais próximos de 1) do que os valores sem DD. Mas observe também que o primeiro ponto de dados atrasado corresponde a um atraso aproximadamente equivalente a 100 operações de gate de dois qubits. Isso reforça o ponto de que o DD é mais útil quando os qubits permanecem ociosos por períodos relativamente longos.
Verifique seu entendimento
Se aplicarmos DD usando XY4 ao mesmo circuito de antes, você espera que ele produza resultados muito melhores, muito piores, ou aproximadamente os mesmos, comparado ao DD usando XX? Explique.
Resposta
Aproximadamente os mesmos, talvez ligeiramente piores. O circuito que usamos tinha estados rotacionados para o plano XY. Esse estado armazena informação principalmente em sua fase, tornando-o especialmente sensível a erros de defasagem em vez de relaxamento T1. XY4 pode ajudar com uma variedade maior de erros, mas o XX já está otimizado para ajudar o circuito que estamos usando. XY4 pode ser igualmente bom, mas não acrescentaria nada substancial, ou o fato de o XY4 conter mais gates pode permitir que erros de gate adicionais tornem os resultados ligeiramente piores.
O último resultado usou a sequência de gates DD mais simples, XX. Vamos ver como implementar uma sequência mais complexa, XY4. Definimos um Sampler na próxima seção.
# --------- Run: WITH DD (XY4) ----------
dd_sequence = "XY4"

sampler = Sampler(mode=backend)
sampler.options.default_shots = shots
sampler.options.dynamical_decoupling.enable = True
sampler.options.dynamical_decoupling.sequence_type = dd_sequence
sampler.options.dynamical_decoupling.scheduling_method = "alap"
sampler.options.dynamical_decoupling.extra_slack_distribution = "middle"

job = sampler.run(circuits)
res_xy4 = job.result()
job_id = job.job_id()  # job id for dd on/XY4
print("job number for dd using Xy4 is ", job_id)
job number for dd using Xy4 is d6k6ti860irc7395d3hg
# --------- Extract counts per circuit ----------

counts_list_xy4 = extract_counts_list(res_xy4)
# --------- Compute X-expectations and a scalar contrast ----------
# For each circuit (each delay), compute per-qubit <X> and average absolute contrast.
xexp_xy4 = []
contrast_xy4 = []

for counts in counts_list_xy4:
    x_vec = counts_to_x_expectations(counts, n_qubits)
    xexp_xy4.append(x_vec)
    contrast_xy4.append(float(np.mean(np.abs(x_vec))))  # average |<X>| across qubits

# --------- Print a small summary ----------
print("\n=== Summary (average |<X>| per delay) ===")
for m, d_us, c0, c1, c2 in zip(
    equiv_gates_list, delay_us_list, contrast_nodd, contrast_dd, contrast_xy4
):
    print(
        f"Delay ~ {m:4d} * {twoq_name}  (~{d_us:7.2f} µs):  NoDD={c0: .3f},  DD({dd_sequence})={c1: .3f}"
    )

# Optionally, inspect per-qubit values for the last delay point
print("\nPer-qubit <X> (abs) at the longest delay:")
print("NoDD:", np.round(np.abs(xexp_nodd[-1]), 3))
print("DD XX :", np.round(np.abs(xexp_dd[-1]), 3))
print("DD XY4 :", np.round(np.abs(xexp_xy4[-1]), 3))
=== Summary (average |<X>| per delay) ===
Delay ~    0 * cz  (~   0.00 µs):  NoDD= 0.968,  DD(XY4)= 0.968
Delay ~  100 * cz  (~   6.80 µs):  NoDD= 0.612,  DD(XY4)= 0.839
Delay ~  200 * cz  (~  13.60 µs):  NoDD= 0.462,  DD(XY4)= 0.705
Delay ~  300 * cz  (~  20.40 µs):  NoDD= 0.339,  DD(XY4)= 0.580
Delay ~  400 * cz  (~  27.20 µs):  NoDD= 0.225,  DD(XY4)= 0.481
Delay ~  500 * cz  (~  34.00 µs):  NoDD= 0.204,  DD(XY4)= 0.393

Per-qubit <X> (abs) at the longest delay:
NoDD: [0.002 0.208 0.447 0.034 0.286 0.306 0.322 0.044 0.163 0.232]
DD XX : [0.433 0.669 0.526 0.516 0.572 0.284 0.303 0.055 0.365 0.208]
DD XY4 : [0.38  0.662 0.521 0.538 0.621 0.252 0.353 0.038 0.239 0.073]
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values with no DD
ax.scatter(
    equiv_gates_list, contrast_nodd, c="blue", linestyle="-", label="No DD", alpha=0.7
)

## Add values with DD using XX sequence
ax.scatter(
    equiv_gates_list, contrast_dd, c="red", linestyle="-", label="With XX", alpha=0.7
)

## Add values with DD using XY4 sequence
ax.scatter(
    equiv_gates_list,
    contrast_xy4,
    c="black",
    linestyle="-",
    label="With XY4",
    alpha=0.7,
)

# Add labels and plot
ax.set_xlabel("Idle Time in # of 2-qubit gates")
ax.set_ylabel("<X>_av")
ax.legend()
ax.set_title("Dephasing and DD")
ax.grid(True)

plt.show()
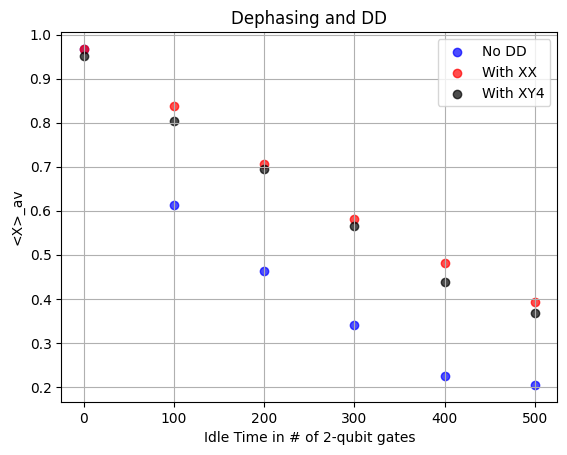
Aqui vemos que XY4 não é sensivelmente diferente de XX. Pode ser muito ligeiramente pior devido a gates adicionais na sequência XY4, mas o mais importante é que já explicamos por que XX teria o efeito desejado ao preservar a fase especificamente para um estado como . Não há razão para pensar que, para tal estado inicial, uma sequência diferente melhoraria os resultados.
Verifique seu entendimento
Verifique que a sequência XY4 deixa o estado inalterado a menos de uma fase global.
Resposta
Pauli twirling
Devemos começar observando que o Pauli twirling é frequentemente usado não como uma técnica de supressão de erros, mas como uma técnica de moldagem de erros: ele faz com que o ruído/erros se comportem de forma diferente, às vezes de forma mais previsível, para permitir outros métodos. Embora o Pauli twirling não previna erros, ele pode prevenir seu acúmulo coerente.
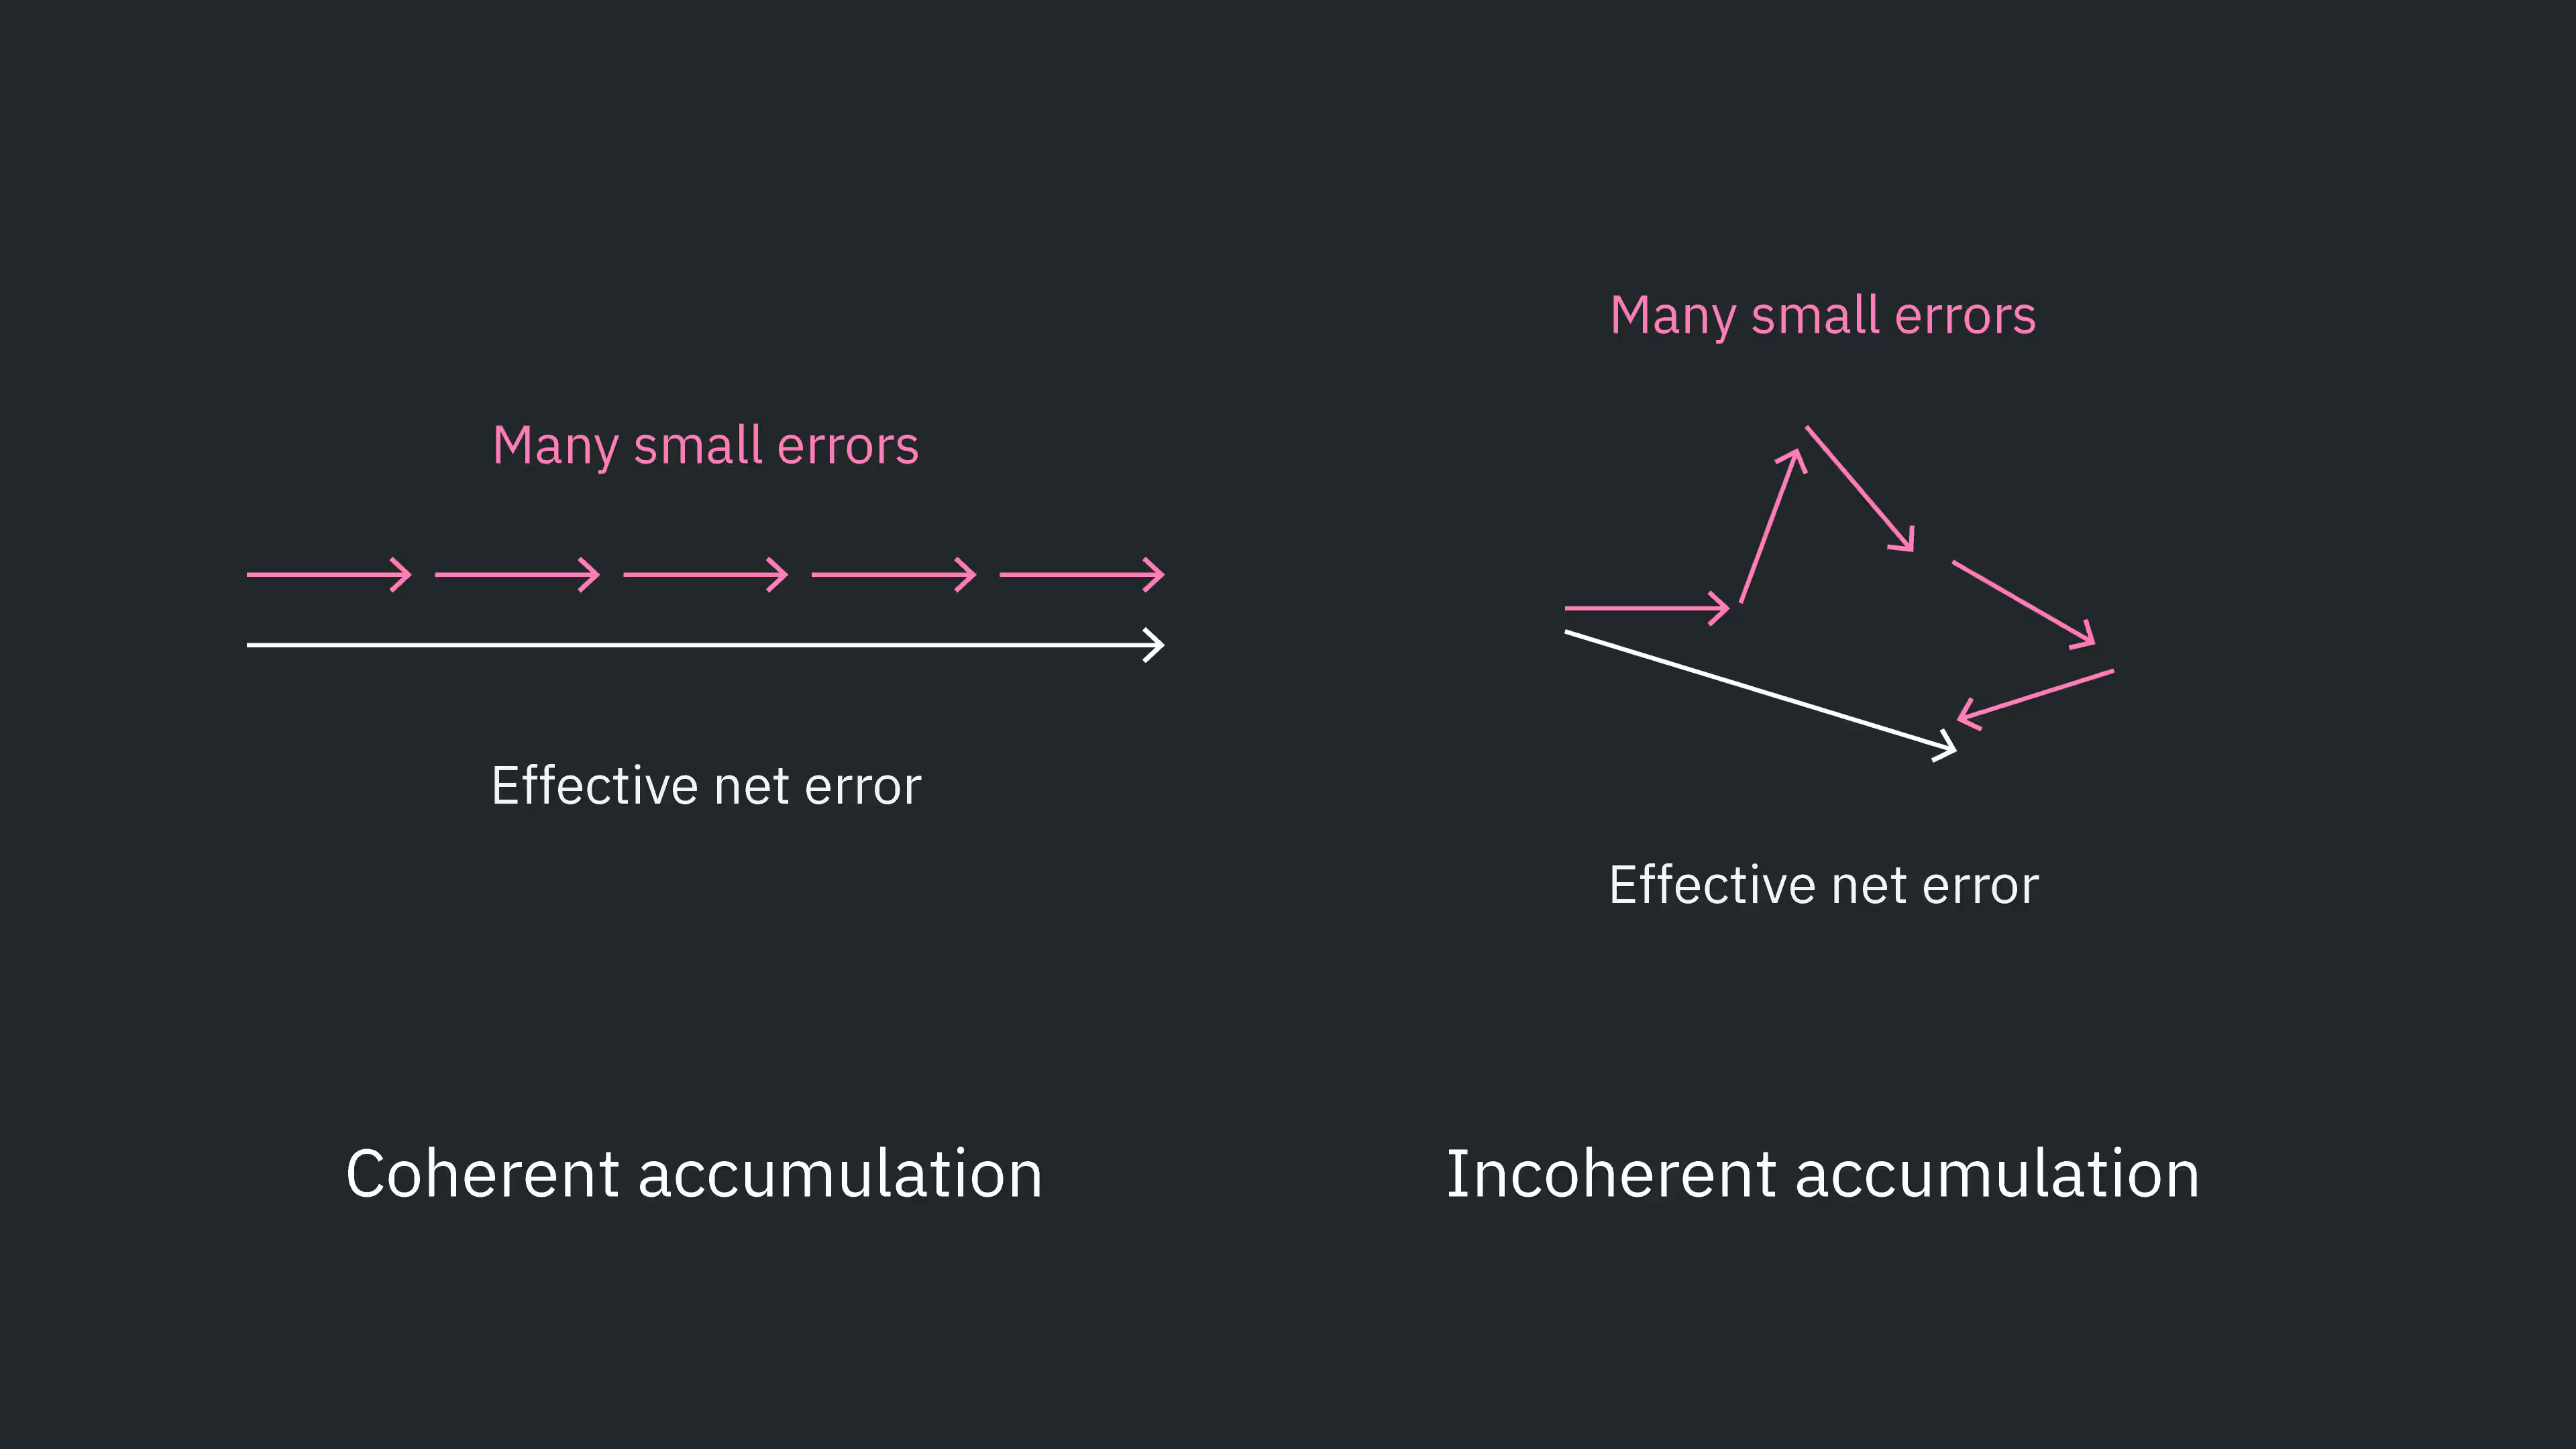
Em um circuito quântico, múltiplas fontes diferentes de erro se somam. Os erros podem se somar de diferentes formas, notavelmente coerentemente e incoerentemente. O acúmulo coerente de erros significa que o ruído ou implementações imperfeitas tendem a direcionar os erros na mesma direção em várias camadas e gates. Um exemplo seria a sobre-rotação coerente ao aplicar um gate de rotação.
Considere um gate de rotação ideal, como , que rotaciona em torno do eixo X exatamente . Claro, a implementação do gate não é perfeita, e a rotação real pode ser para uma implementação, e pode até ser o caso de ser sempre do mesmo sinal, e possivelmente similar em magnitude em várias aplicações de . Assim, a aplicação repetida de gates de rotação pode resultar em acúmulo coerente dessas muitas sobre-rotações (ou sub-rotações), .
O acúmulo incoerente de erros é exatamente o oposto: erros em direções aleatórias com sinais aleatórios, de forma que erros em diferentes camadas nem sempre interferem aditivamente, mas às vezes se cancelam ou se somam em quadratura. Claramente, erros incoerentes se acumulam mais lentamente em termos do efeito geral sobre o estado do qubit. Um diagrama ilustrativo disso é mostrado na figura abaixo. Isso é uma simplificação. Erros quânticos reais não estão restritos a um espaço cartesiano bidimensional; nem todas as contribuições de erro terão a mesma magnitude, e há mais complexidades. Mas a intuição de uma imagem como essa é útil: erros coerentes tendem a se acumular mais rapidamente do que os incoerentes.
Muitas vezes é possível obter resultados de maior fidelidade transformando o acúmulo coerente de erros em acúmulo incoerente de erros. Uma forma principal de realizar isso é chamada de Pauli twirling.
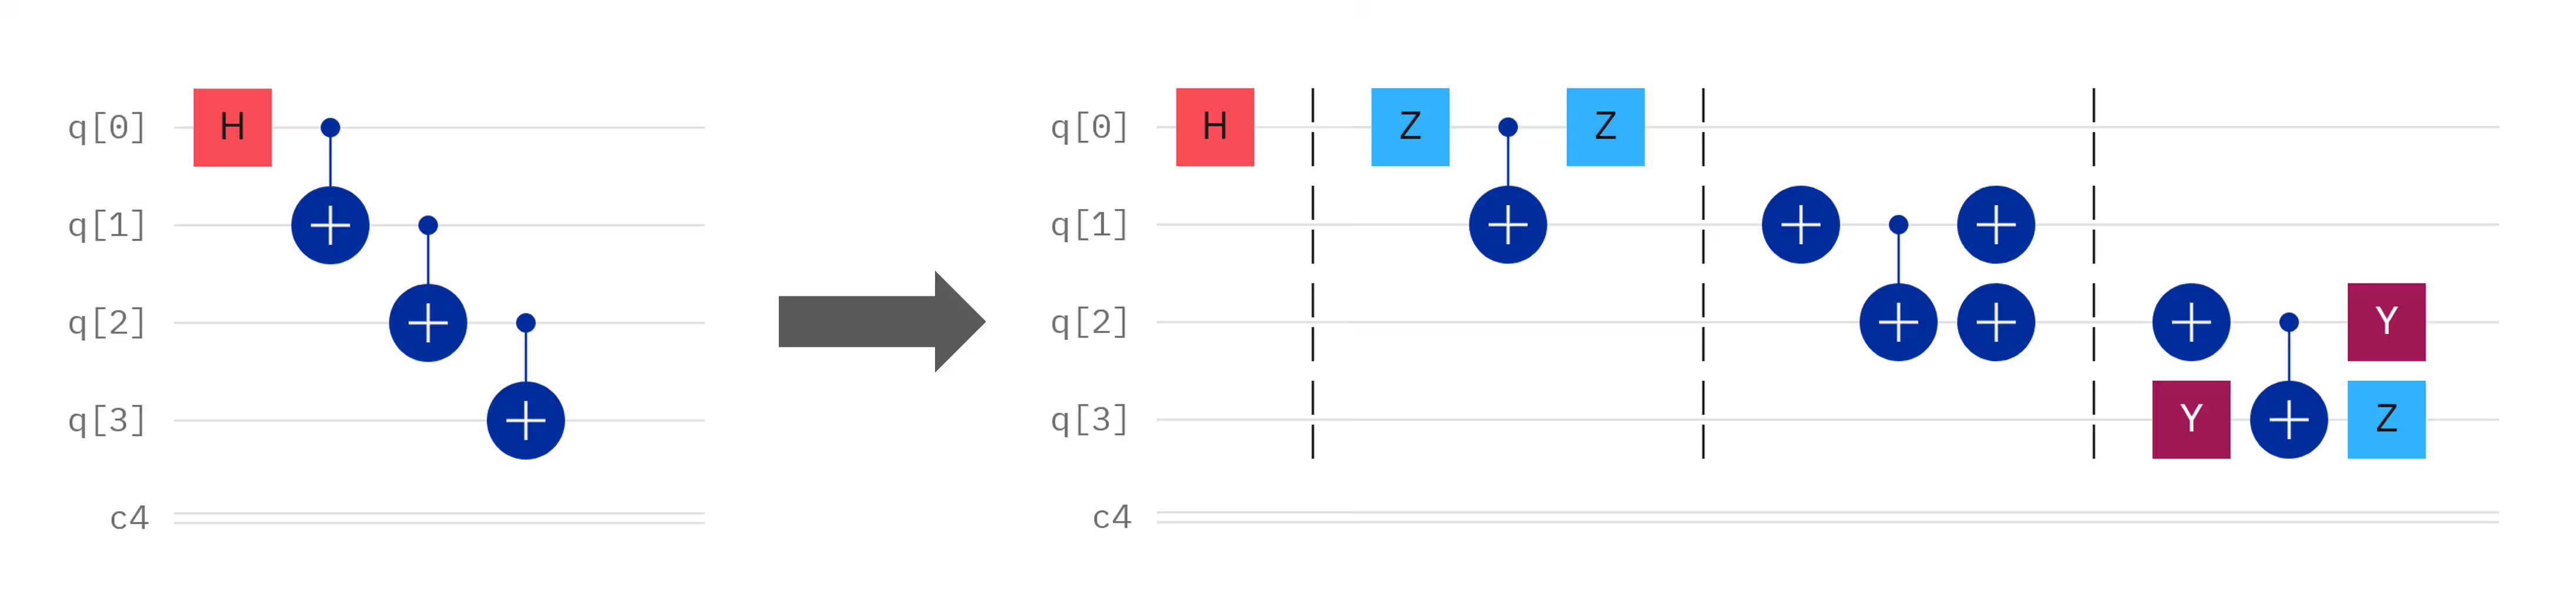
Pauli twirling refere-se a adicionar combinações de gates Pauli antes e depois de uma operação de gate desejada de forma que . Aqui, e não são Paulis únicos, mas coleções de operadores Pauli frequentemente atuando em múltiplos qubits. Às vezes você pode ver a afirmação de que a ação dos gates Pauli extras é "equivalente à identidade". Mas isso é impreciso e potencialmente confuso. Os gates Pauli são separados por e o objetivo é deixar a ação lógica de todos os gates igual a . Às vezes é chamado de "payload" para distinguir essa operação pretendida dos gates adicionados para supressão. Alguns exemplos de Pauli twirling em torno de um gate CNOT são mostrados abaixo.

Vamos percorrer apenas um exemplo para verificar que o twirling deixa o efeito lógico do payload inalterado. Sem perda de generalidade, sejam os estados de dois qubits envolvendo e :
Como sempre, estamos usando a convenção de ordenação de qubits . Aplicando um gate CX com como alvo, obtemos
Agora vamos considerar o terceiro circuito mostrado, usando gates X para o Pauli twirling. Poderíamos simplesmente multiplicar as matrizes juntas e verificar que elas produzem uma matriz CNOT. Alternativamente, podemos rastrear a operação em um estado quântico arbitrário através do circuito, como fazemos abaixo. Os estados em diferentes pontos do circuito foram rotulados a-d.

Isso é exatamente que obtivemos antes sem twirling. De fato, essa sequência de gates com twirling deixa a ação lógica do payload inalterada. No entanto, se diferentes sequências de twirling válidas forem selecionadas aleatoriamente de camada em camada, o acúmulo coerente de erros pode ser convertido em acúmulo estocástico (incoerente) de erros de forma eficaz. Para deixar claro, não se escolhe um único padrão de twirling e o usa por todo o circuito. Em vez disso, diferentes sequências de twirling válidas são selecionadas para diferentes camadas. Um exemplo com muitas camadas de emaranhamento pode se parecer com isto.
Verifique seu entendimento
Verifique que o Pauli twirling no quarto painel da figura acima também deixa o efeito lógico do CNOT inalterado.
Resposta
Seguimos o exemplo acima e mostramos que a ação em qualquer estado arbitrário de dois qubits é equivalente a uma operação CNOT. Vamos nos referir aos pontos rotulados neste diagrama.

Isso é equivalente à ação de um CNOT com o qubit 0 como controle e o qubit 1 como alvo.
Você consegue criar uma sequência de Pauli twirling para o gate CNOT que não seja mostrada acima?
Resposta
Sim, existem muitas outras. Um exemplo é antes do CNOT, e um e depois do CNOT.
Quando usar o Pauli twirling
Como apresentado aqui, o Pauli twirling é aplicado apenas a gates de múltiplos qubits. Aplicar um protocolo similar a gates de um único qubit exigiria uma lógica diferente e geralmente não é útil na prática. O próprio Pauli twirling usa vários gates de um único qubit (os gates Pauli). Os gates Pauli adicionais provavelmente introduziriam mais erro do que seria ganho ao aleatorizar qualquer acúmulo coerente de erros. As taxas de erro associadas a gates de dois qubits são muito maiores do que as associadas a gates de um único qubit. Além disso, alguns gates de um único qubit são não-Clifford, que não podem ser totalmente twirled. É por isso que o Qiskit inclui opções de Pauli twirling que automaticamente aplicam twirling em torno de gates de dois qubits, e não em torno de gates de um único qubit.
Isso estava implícito na figura acima: o Pauli twirling foi implementado em torno dos gates CX, mas não em torno do gate Hadamard.
Vamos ver dois exemplos de Pauli twirling em ação.
Pauli twirling para suprimir o acúmulo coerente
Para observar como o Pauli twirling pode transformar o acúmulo coerente de erros em acúmulo incoerente mais lento, queremos um circuito e um observável que funcionem como um teste de estresse de erro coerente. O único propósito é tornar visíveis os erros de dois qubits que se acumulam coerentemente, e então mostrar como o Pauli twirling converte esse acúmulo coerente em decaimento estocástico.
Gates CNOT (ou CZ) são uma fonte comum de erros coerentes. O experimento mais simples que podemos fazer neste caso é inicializar um estado (digamos ), aplicar camadas de pares de gates CNOT (usando o fato de que dois CNOTs produzem uma identidade), e verificar como os erros se acumulam à medida que o número de camadas aumenta, tanto com quanto sem Pauli twirling.
O observável de interesse é em um único qubit, que plotamos em função do número de repetições de pares de CNOT.
# --- Imports ---

import numpy as np
from qiskit import QuantumCircuit
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_ibm_runtime import SamplerV2 as Sampler
# Build the circuit with CX/CX identity per layer

def identity_cx_pairs(layers: int) -> QuantumCircuit:
    q = QuantumRegister(2, "q")
    c = ClassicalRegister(1, "c")  # we only measure q0
    qc = QuantumCircuit(q, c, name=f"N={layers}")

    # |+> on q0
    qc.h(q[0])

    for _ in range(layers):
        qc.barrier()
        qc.cx(q[0], q[1])
        qc.cx(q[0], q[1])

    # Measure in X basis: H then measure q0

    qc.h(q[0])
    qc.measure(q[0], c[0])

    return qc
Como rotacionamos nossa base antes das medições, uma medição de corresponde ao estado ter estado em imediatamente antes do gate Hadamard final, e similar para e . Portanto, nosso valor esperado pode ser simplesmente calculado a partir das contagens de menos as contagens de .
# Compute <X> from SamplerV2 counts

def x_expect_from_counts(counts: dict[str, int]) -> float:
    shots = sum(counts.values())
    p0 = counts.get("0", 0) / shots
    p1 = counts.get("1", 0) / shots
    return p0 - p1  # <X> = P(0) - P(1) after H,measure
Selecionamos um número razoável de camadas de CNOT sobre as quais permitir que o erro se acumule, construímos nossos circuitos e depois os transpile.
# Choose the number of layers for the experiment
N_layers_list = [0, 1, 2, 3, 4, 5]

circuits = [identity_cx_pairs(n) for n in N_layers_list]

# Transpile to backend ISA so that primitives run native instructions
pm = generate_preset_pass_manager(backend=backend, optimization_level=0)
isa_circuits = [pm.run(c) for c in circuits]
Tenha em mente que cada camada consiste em mais de um gate de dois qubits. Monitore a profundidade transpile de dois qubits usando a função abaixo.
# We can check the 2-qubit depths of any of our circuits like this:
print(
    "two-qubit depth",
    isa_circuits[5].decompose().depth(lambda instr: len(instr.qubits) > 1),
)
two-qubit depth 15
# Configure two Samplers: (A) no twirling, (B) gate twirling
#    - No DD, no measurement twirling in both (to isolate gate twirling)
# ------------------------------
shots = 8192

# (A) No twirling
sampler_no_twirl = Sampler(mode=backend)
# Ensure no extra suppression/mitigation:
sampler_no_twirl.options.dynamical_decoupling.enable = False
# Be explicit about twirling:
sampler_no_twirl.options.twirling.enable_gates = False
sampler_no_twirl.options.twirling.enable_measure = (
    False  # TREX-style measurement twirling off
)
sampler_no_twirl.options.default_shots = shots  # default shots for this primitive

# (B) Gate twirling ON
sampler_twirl = Sampler(mode=backend)
sampler_twirl.options.dynamical_decoupling.enable = False
sampler_twirl.options.twirling.enable_gates = True  # <-- enable Pauli gate twirling
sampler_twirl.options.twirling.enable_measure = False
sampler_twirl.options.default_shots = shots

# (Optional) Inspect options dicts if you’re curious
# print(asdict(sampler_no_twirl.options))
# print(asdict(sampler_twirl.options))
Agora executamos os jobs.
# Run both jobs; extract counts; compute <X>

# Helper to run a sampler and compute <X> per circuit
def run_and_x_expect(sampler: Sampler, circ_list: list[QuantumCircuit]) -> list[float]:
    job = sampler.run(
        circ_list
    )  # shots taken from options.default_shots unless overridden
    result = job.result()
    # For SamplerV2, use join_data().get_counts() to combine registers if needed
    exp_vals = []
    for pub in result:
        counts = pub.join_data().get_counts()
        exp_vals.append(x_expect_from_counts(counts))
    return exp_vals

x_no_twirl = run_and_x_expect(sampler_no_twirl, isa_circuits)
x_twirl = run_and_x_expect(sampler_twirl, isa_circuits)

# ------------------------------
# 6) Print a small table
# ------------------------------
print("\nN_layers   <X> (no twirl)   <X> (gate twirl)")
for n, a, b in zip(N_layers_list, x_no_twirl, x_twirl):
    print(f"{n:7d}   {a:14.6f}   {b:14.6f}")
N_layers   <X> (no twirl)   <X> (gate twirl)
      0         0.984375         0.987549
      1         0.934326         0.936523
      2         0.844238         0.892822
      3         0.712158         0.879395
      4         0.592529         0.844971
      5         0.449463         0.785156
Finalmente, visualizamos esses resultados.
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values using XX
ax.scatter(
    N_layers_list, x_no_twirl, c="blue", linestyle="-", label="No twirl", alpha=0.7
)

## Add values with XY4
ax.scatter(N_layers_list, x_twirl, c="red", linestyle="-", label="Twirled", alpha=0.7)

# Add labels and plot
ax.set_xlabel("CX layers")
ax.set_ylabel("<X>")
ax.legend()
ax.set_title("Pauli twirling")
ax.grid(True)

plt.show()
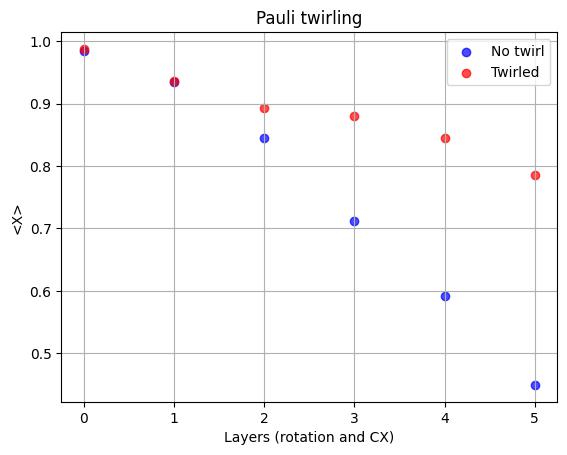
Podemos ver claramente que o circuito com twirling produz um valor esperado mais próximo do ideal . Este exemplo cumpriu seu propósito, mas vamos passar para algo mais útil: twirling na produção de estados altamente emaranhados.
Pauli twirling na preparação de estados GHZ
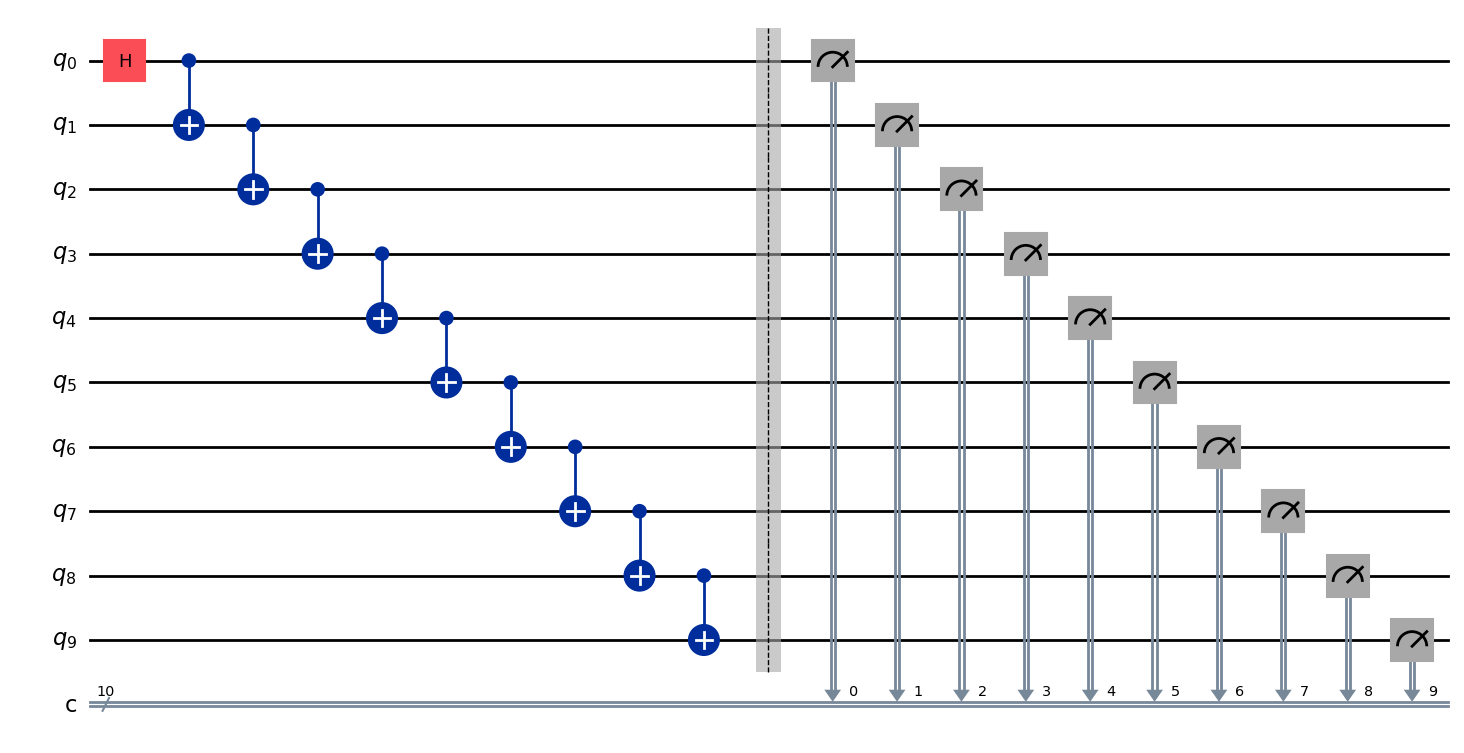
O exemplo anterior mostrou um caso convincente para o Pauli twirling na destruição do acúmulo coerente de erros associados a gates CNOT. A produção de estados GHZ usa muitos gates CNOT para produzir estados altamente emaranhados úteis para muitas aplicações de computação quântica. Vamos explorar como o Pauli twirling ajuda nesse contexto, com estados GHZ de tamanho crescente.
# Imports if not already loaded in previous cells
# from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager
# from qiskit import QuantumRegister, ClassicalRegister, QuantumCircuit

# Define a GHZ circuit building function, so that we can build GHZ states of increasing size.

def ghz_circuit(n: int) -> QuantumCircuit:
    q = QuantumRegister(n, "q")
    c = ClassicalRegister(n, "c")
    qc = QuantumCircuit(q, c)

    qc.h(q[0])
    for i in range(n - 1):
        qc.cx(q[i], q[i + 1])

    qc.barrier()

    qc.measure(q, c)
    return qc

# Build a test state with 10 qubits to remind ourselves of GHZ structure.

num_qubits = 10

qc_ghz = ghz_circuit(num_qubits)
qc_isa = pm.run(qc_ghz)
qc_ghz.draw("mpl")
Agora construímos nossos circuitos e os transpile. Neste caso, não temos gates artificialmente repetidos que se reduzem à identidade. Portanto, podemos permitir que o pass manager faça um pouco mais de otimização por nós. Vamos configurá-lo para o nível três.
# Set up a pass manager

opt_level = 3
# --------- Build circuits for a sweep of delays ----------
pm = generate_preset_pass_manager(optimization_level=opt_level, backend=backend)

# Build GHZ circuits of increasing size.

nmin = 5
nmax = 15
circuits = []
for n in range(nmin, nmax):
    qc = ghz_circuit(n)
    qc_isa = pm.run(qc)
    circuits.append(qc_isa)
Podemos ver que o otimizador mapeou nosso circuito abstrato para os qubits 123, 124, 136, 142 e 143.
circuits[0].draw("mpl")
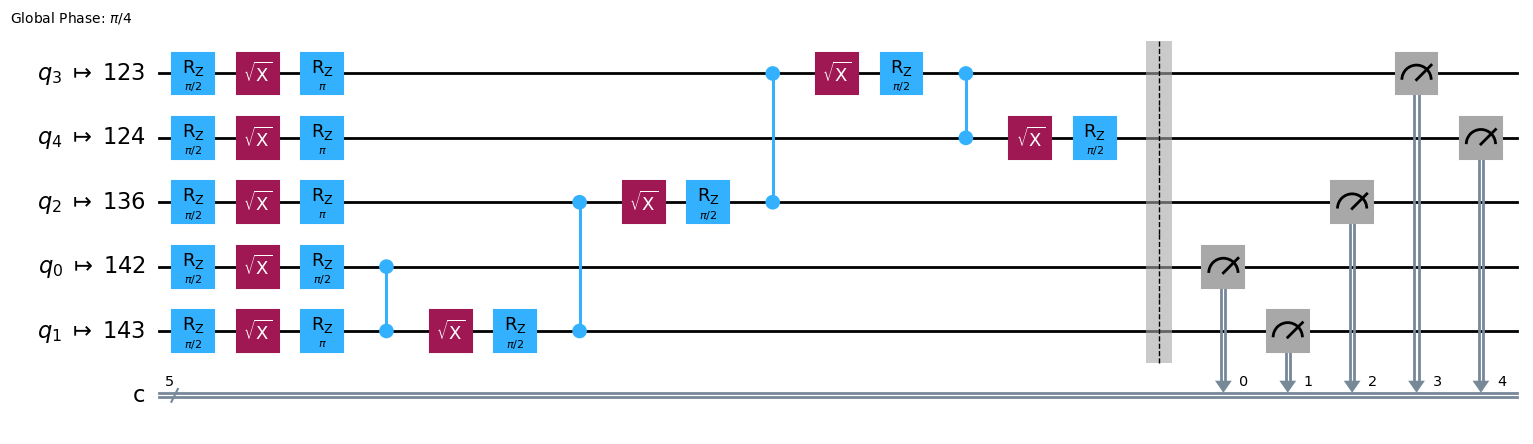
Para entender o porquê, vamos olhar um mapa do layout do nosso backend (nesta imagem, ibm_fez, mas você pode fazer análises equivalentes em qualquer backend).
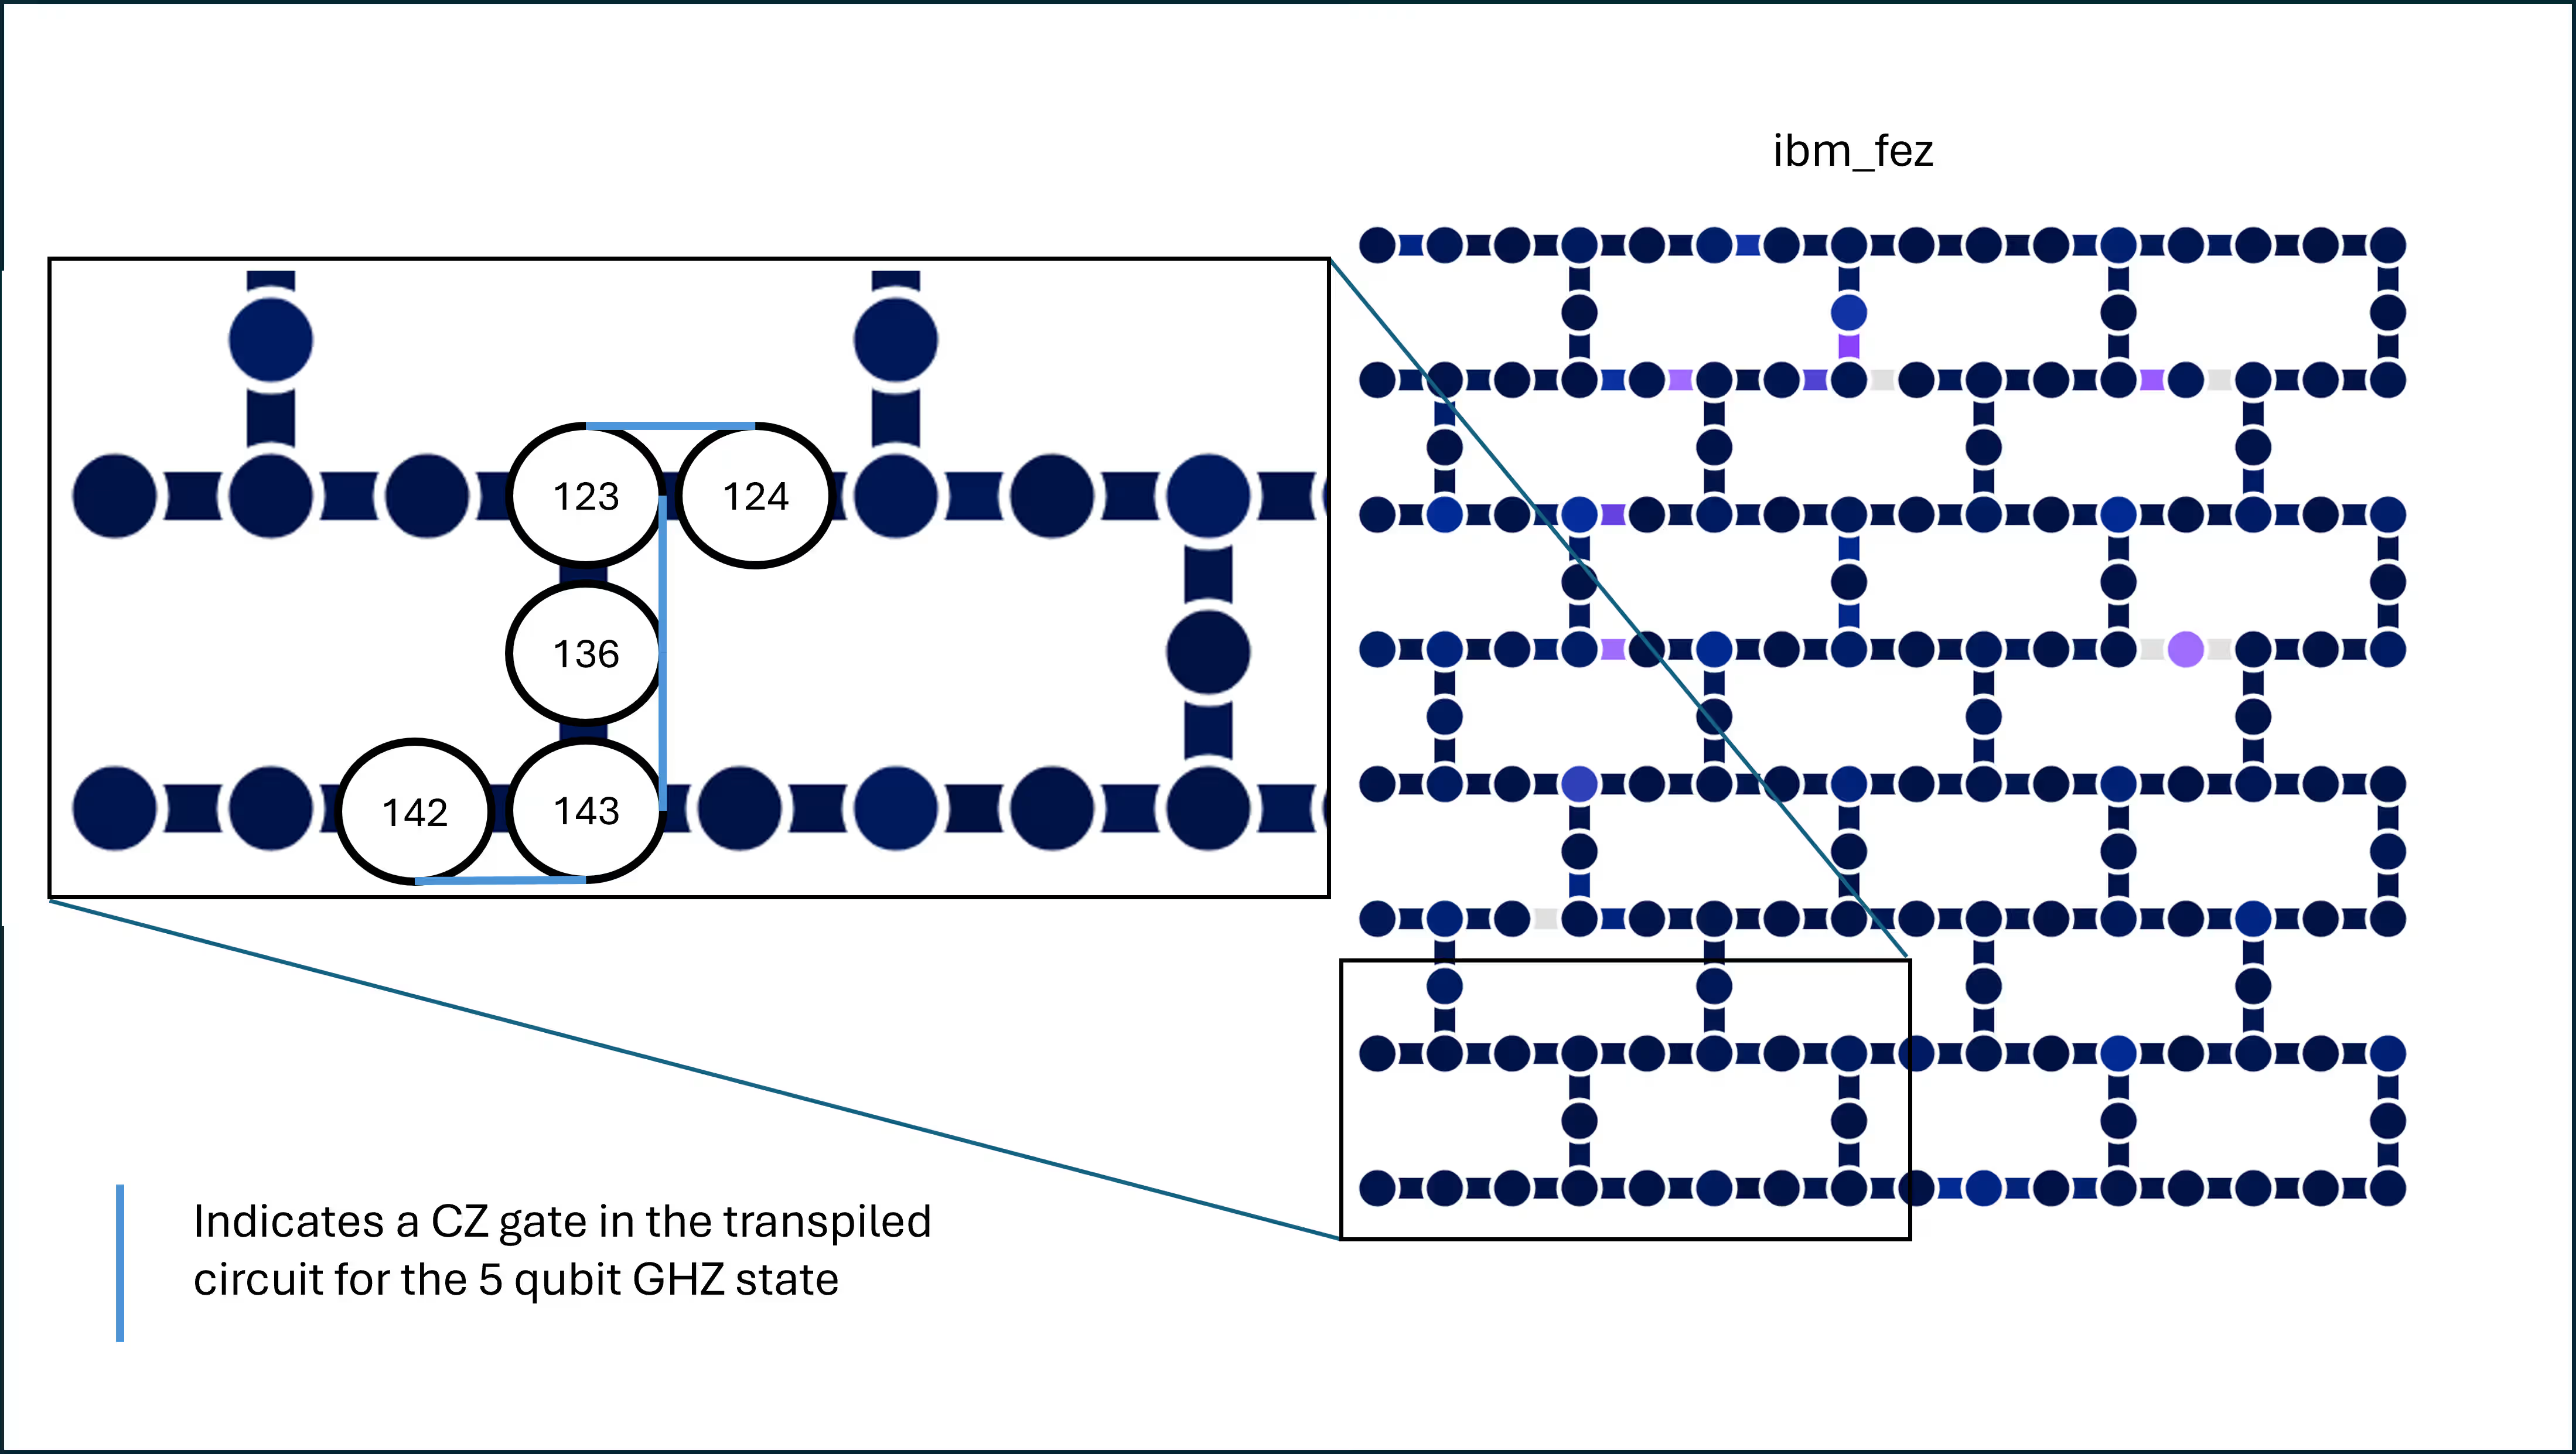
Vemos que os qubits foram selecionados em uma cadeia para minimizar gates swap e, assim, a profundidade do circuito. Além disso, cada gate CZ implementado no circuito é entre qubits adjacentes. Finalmente, todos os cinco qubits têm taxas de erro relativamente baixas, incluindo taxas de erro de atribuição de leitura. Você pode verificar essas taxas de erro em qualquer backend na página Recursos de computação. Encontrar tal layout não é difícil para uma cadeia linear simples, mas à medida que os problemas se tornam mais complexos, a otimização do layout do circuito se torna mais difícil e mais valiosa.
Agora configuramos nossa primitiva Sampler. Desligamos outras ferramentas de supressão/mitigação para focar no Pauli twirling.
# Configure two Samplers: (A) no twirling, (B) gate twirling
# No DD, no measurement twirling in both (to isolate gate twirling)

shots = 8192

# (A) No twirling
sampler_no_twirl = Sampler(mode=backend)
# Ensure no extra suppression/mitigation:
sampler_no_twirl.options.dynamical_decoupling.enable = False
# Be explicit about twirling:
sampler_no_twirl.options.twirling.enable_gates = False
sampler_no_twirl.options.twirling.enable_measure = (
    False  # TREX-style measurement twirling off
)
sampler_no_twirl.options.default_shots = shots  # default shots for this primitive

# (B) Gate twirling ON
sampler_twirl = Sampler(mode=backend)
sampler_twirl.options.dynamical_decoupling.enable = False
sampler_twirl.options.twirling.enable_gates = True  # <-- enable Pauli gate twirling
sampler_twirl.options.twirling.enable_measure = False
sampler_twirl.options.default_shots = shots

# (Optional) Inspect options dicts if you’re curious
# print(asdict(sampler_no_twirl.options))
# print(asdict(sampler_twirl.options))
Finalmente, executamos nossos jobs. Você pode opcionalmente imprimir os números de ID do job para recuperação posterior.
job = sampler_twirl.run(circuits)
res_ghz_twirl = job.result()
job_id = job.job_id()  # job id for twirling on/true
print("job number for twirling the ghz prep is ", job_id)

job = sampler_no_twirl.run(circuits)
res_ghz_no_twirl = job.result()
job_id = job.job_id()  # job id for twirling off/false
print("job number for NO twirling the ghz prep is ", job_id)
job number for twirling the ghz prep is  d7h967bjne2c7393s0b0
job number for NO twirling the ghz prep is  d7h96f7b91ec73aufing
Extraímos as contagens de cada estado de base computacional medido para todos os circuitos, tanto com quanto sem twirling.
# --------- Extract counts per circuit ----------
def extract_counts_list(res):
    counts_list = []
    for r in res:  # each r corresponds to one circuit
        # r.data.<classical_register_name>.get_counts()
        counts = r.data.c.get_counts()
        counts_list.append(counts)
    return counts_list

counts_list_ghz_twirl = extract_counts_list(res_ghz_twirl)
counts_list_ghz_no_twirl = extract_counts_list(res_ghz_no_twirl)
print(counts_list_ghz_twirl[0])
print(counts_list_ghz_twirl[4])
{'11111': 3440, '11101': 87, '00000': 3434, '10111': 87, '00001': 168, '10011': 4, '11000': 102, '00011': 39, '01111': 93, '00111': 111, '01000': 90, '11110': 235, '00110': 6, '00010': 75, '11011': 30, '11100': 42, '10000': 82, '00101': 7, '10001': 2, '11001': 6, '11010': 5, '01010': 3, '01110': 7, '00100': 14, '10101': 1, '10110': 8, '01001': 6, '10100': 1, '01101': 4, '01011': 1, '10010': 2}
{'111111111': 2683, '000000000': 2976, '111000000': 53, '110000000': 74, '111111100': 47, '111011111': 76, '111111110': 195, '111111000': 67, '000000010': 66, '011111110': 10, '011110001': 1, '101110111': 7, '101011111': 9, '111110111': 87, '111100000': 96, '111011000': 2, '010000000': 60, '111111010': 3, '100000000': 110, '111111011': 32, '000000111': 51, '000100000': 84, '000011111': 82, '000000001': 176, '100000010': 6, '111100001': 3, '000000011': 36, '101111111': 98, '100000011': 2, '001111111': 75, '000001000': 60, '000011101': 4, '110111111': 38, '111111101': 72, '111100100': 3, '000100010': 1, '001011101': 1, '000000110': 8, '110000011': 1, '000111111': 48, '000000100': 23, '000001111': 65, '010000101': 2, '000100001': 8, '111110000': 51, '010001111': 1, '111000111': 2, '111000001': 2, '000111100': 1, '011111111': 116, '111110001': 1, '000011110': 10, '000010000': 23, '000101111': 3, '000101110': 1, '011110111': 4, '010000111': 7, '111101111': 36, '001000000': 40, '010100000': 3, '101111110': 8, '110111000': 5, '000000101': 8, '010000010': 4, '000110001': 2, '110111110': 4, '111100010': 2, '111010111': 2, '000001110': 5, '111110101': 3, '001110000': 4, '101100000': 5, '001111110': 8, '100000001': 5, '111011110': 3, '111110100': 5, '110001011': 1, '001110111': 4, '000010110': 2, '111001111': 2, '000011000': 5, '010111110': 1, '000101000': 4, '101000000': 4, '100111111': 4, '111110011': 2, '000101100': 1, '101111100': 2, '111011100': 1, '001111011': 3, '011111011': 3, '110100000': 5, '000001011': 3, '111110110': 5, '111111001': 5, '000001001': 8, '010000001': 5, '011111101': 2, '001010111': 1, '011101110': 1, '110110110': 1, '001111100': 3, '100001000': 3, '001000011': 1, '001011111': 6, '110000010': 2, '110010000': 1, '010011111': 2, '111101101': 3, '101110000': 1, '111100111': 6, '010111111': 5, '110110000': 2, '011011111': 2, '110011111': 1, '110000111': 6, '001000001': 2, '001100000': 3, '101101111': 1, '000111110': 5, '111011101': 2, '100100000': 2, '101111101': 3, '001001111': 1, '001010000': 2, '111001000': 1, '011110000': 2, '011101111': 3, '000001100': 1, '110101000': 1, '011000000': 4, '111101000': 3, '110000001': 4, '000010111': 4, '011111100': 1, '111000010': 1, '101011000': 1, '101111000': 2, '001101111': 1, '010001100': 1, '000100011': 1, '111110010': 1, '111101110': 1, '100001111': 1, '100011011': 1, '010110111': 1, '001110110': 2, '100000100': 1, '001000110': 1, '100011111': 2, '010010001': 1, '111010110': 1, '011110110': 1, '000111000': 2, '000100111': 1, '011010000': 1, '001111000': 2, '100010000': 1, '011111000': 2, '110111100': 2, '110110111': 1, '110001000': 1, '000110111': 1, '000101011': 1, '000110000': 1, '011100000': 3, '001000010': 1, '001001000': 1, '001000111': 1, '001111101': 3, '111101011': 1, '111010000': 1, '100000101': 1, '000010010': 1, '001011110': 1, '000011011': 1, '111101100': 1}
Sabemos que a distribuição ideal de um estado GHZ é aquela em que metade dos shots retorna e a outra metade retorna . Construa isso para comparação.
ideal_dist = []
for n in range(nmin, nmax):
    ideal_dist.append({"0" * n: int(shots / 2), "1" * n: int(shots / 2)})
Agora usamos a fidelidade de Hellinger como uma medida da qualidade do nosso estado final.
from qiskit.quantum_info import hellinger_fidelity

num_qubits = []
fidelities_twirl = []
fidelities_no_twirl = []
for n in range(len(ideal_dist)):
    num_qubits.append(nmin + n)
    fidelities_twirl.append(hellinger_fidelity(counts_list_ghz_twirl[n], ideal_dist[n]))
    fidelities_no_twirl.append(
        hellinger_fidelity(counts_list_ghz_no_twirl[n], ideal_dist[n])
    )
Finalmente, plotamos nossos resultados.
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values using no twirling
ax.scatter(
    num_qubits,
    fidelities_no_twirl,
    c="blue",
    linestyle="-",
    label="No twirl",
    alpha=0.7,
)

## Add values with twirling
ax.scatter(
    num_qubits, fidelities_twirl, c="red", linestyle="-", label="Twirled", alpha=0.7
)

# Add labels and plot
ax.set_xlabel("Qubits in GHZ state")
ax.set_ylabel("Hellinger fidelity")
ax.legend()
ax.set_title("Pauli twirling in GHZ states")
ax.grid(True)

plt.show()
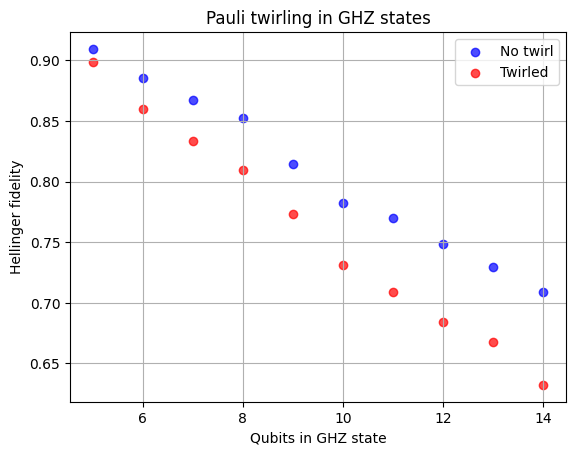
Os resultados usando Pauli twirling não são melhores (e até ligeiramente piores) do que sem twirling. O que aconteceu?
Duas coisas aconteceram. Primeiro, o Pauli twirling não reduz a quantidade total de ruído — em vez disso, ele remodela erros coerentes e sistemáticos em erros estocásticos do tipo Pauli, de forma que o crescimento do erro se torna previsível e modelável. Nunca houve qualquer promessa de redução de erro, exceto em casos especiais.
Em segundo lugar, em circuitos GHZ, alguns erros coerentes podem se cancelar parcialmente ou agir como deslocamentos de fase benignos devido à simetria da construção GHZ; o twirling remove essa proteção acidental e a substitui por ruído Pauli estocástico não correlacionado, de forma que a fidelidade GHZ se torna ligeiramente pior com o twirling.
Essa segunda afirmação requer alguma explicação. A afirmação não é que os circuitos GHZ estejam protegidos de todos os tipos de acúmulo coerente de erros, apenas de alguns tipos — e que, nesses casos, a proteção é destruída pelo twirling. Especificamente, vamos considerar a sobre-rotação coerente associada aos gates CX. Vamos chamar o gate CX real com sobre-rotação de :
onde é qualquer produto de operadores de Pauli, como , , , , etc. Para estados gerais, qualquer uma dessas sobre-rotações poderia afetar as estatísticas de medição (e, portanto, as medidas de fidelidade do estado). Um subconjunto delas, no entanto, deixa muitos observáveis padrão de GHZ inalterados, incluindo operadores como e . No contexto da preparação de um estado GHZ, os erros de sobre-rotação relevantes desse tipo seriam:
A preparação de todo o estado GHZ de qubits seria assim:
Depois de preparar o estado GHZ, o estado é idealmente:
Esse estado é um autoestado simultâneo de um grande conjunto de operadores de Pauli, incluindo os seguintes:
com autovalor . Como resultado, um operador da forma atua sobre o estado GHZ como multiplicação pelo fator de fase , o que não afeta observáveis padrão de GHZ como paridade, coletivo, ou populações na base computacional. Assim, embora os erros de sobre-rotação sejam coerentes e sistemáticos, eles são efetivamente invisíveis para as medições usadas para avaliar a fidelidade GHZ. Nesse sentido, o circuito GHZ desfruta de uma proteção acidental de coerência: certos erros coerentes de CX comutam com a estrutura do estado sendo preparado e, portanto, não degradam o desempenho medido.
A twirling de Pauli muda fundamentalmente essa situação. A twirling não preserva o erro coerente de sobre-rotação como um processo determinístico . Em vez disso, ela converte o canal de erro coerente em um canal de Pauli estocástico efetivo. Como resultado, o canal de erro agora inclui termos como , , e , que não comutam com os estabilizadores GHZ.
Quando esses erros de Pauli estocásticos ocorrem, eles criam falhas reais de bit-flip e phase-flip em qubits individuais ou pares de qubits. Esses erros tiram o estado do subespaço estabilizador GHZ, reduzem a interferência entre e , e diminuem diretamente a fidelidade GHZ e os sinais de paridade multi-qubit. Em outras palavras, a twirling de Pauli remove a estrutura coerente do erro, mas também remove o cancelamento baseado em simetria que anteriormente tornava esses erros benignos. O resultado é um estado GHZ ligeiramente pior — não porque a twirling adiciona ruído, mas porque converte um erro coerente majoritariamente inofensivo em erros estocásticos genuinamente prejudiciais.
Esse exemplo destaca uma lição importante: a twirling de Pauli não é uma estratégia de melhoria universal. Ela é mais benéfica quando erros coerentes se acumulam ao longo de um circuito de forma destrutiva para a fidelidade exigida. Em circuitos altamente simétricos como a preparação de estados GHZ, alguns erros coerentes estão naturalmente alinhados com os estabilizadores do estado, e randomizá-los deliberadamente pode eliminar essa proteção acidental.
Combine métodos
Em princípio, é possível combinar a twirling de Pauli com o dynamical decoupling. Não usamos DD neste caso por dois motivos: primeiro, não deveria haver nenhum período ocioso extremamente longo nesse circuito. Segundo, os estados GHZ não armazenam a maior parte de sua informação em coerência de fase de qubit único, particularmente se estivermos observando a fidelidade apenas em termos de contagens de bitstrings, e não em termos da fase entre as bitstrings desejadas e .
Se fôssemos estender a preparação GHZ para 100+ qubits, então os atrasos na medição dos primeiros qubits poderiam de fato ser longos o suficiente para que o DD fosse útil. Isso é especialmente verdadeiro quando levamos em conta a profundidade transpilada do circuito.
Twirling de Pauli em estrutura de eco RTZ
Nosso exemplo final de twirling de Pauli no contexto de redução do acúmulo de erro coerente usa um circuito com camadas de combinações X-CZ-X-CZ. Essa é uma sequência de portas bem conhecida, frequentemente usada para cancelar termos de erro ZZ coerentes em portas de dois qubits, mesmo sem twirling. Mas com twirling, podemos reduzir ou randomizar outras formas de acúmulo de erro coerente.
Vamos começar definindo uma função para construir circuitos semelhantes a RTZ com um número variável de camadas.
from qiskit import QuantumCircuit

def rtz_echo_circuit(n_qubits: int, depth: int) -> QuantumCircuit:
    """
    Construct an RTZ echo-style circuit.

    Args:
        n_qubits: Number of qubits in the circuit.
        depth: Number of repeated echo layers.

    Returns:
        A QuantumCircuit implementing the echo sequence with measurements.
    """
    q = QuantumRegister(n_qubits, "q")
    c = ClassicalRegister(n_qubits, "c")
    qc = QuantumCircuit(q, c)

    for _ in range(depth):
        qc.h(q)

        for i in range(0, n_qubits - 1, 2):
            qc.cz(q[i], q[i + 1])

        qc.x(q)

        for i in range(1, n_qubits - 1, 2):
            qc.cz(q[i], q[i + 1])

        qc.h(q)

    qc.measure(q, c)
    return qc
Agora construímos circuitos com camadas crescentes, até uma profundidade total razoável de dois qubits transpilada.
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

circuits = []
qcs = []
depths = list(range(3, 27, 4))
n_qubits = 10

opt_level = 0
pm = generate_preset_pass_manager(
    optimization_level=opt_level,
    backend=backend,
    initial_layout=[0, 1, 2, 3, 4, 5, 6, 7, 8, 9],
)

for d in depths:
    qc = rtz_echo_circuit(n_qubits, d)
    qcs.append(qc)
    qc_isa = pm.run(qc)
    circuits.append(qc_isa)
# We can check the 2-qubit depths of any of our circuits like this:
two_qubit_depths = []
for n in range(len(circuits)):
    two_qubit_depths.append(
        circuits[n].decompose().depth(lambda instr: len(instr.qubits) > 1)
    )
print(two_qubit_depths)
[6, 14, 22, 30, 38, 46]
qcs[0].draw("mpl")
# circuits[0].draw("mpl")
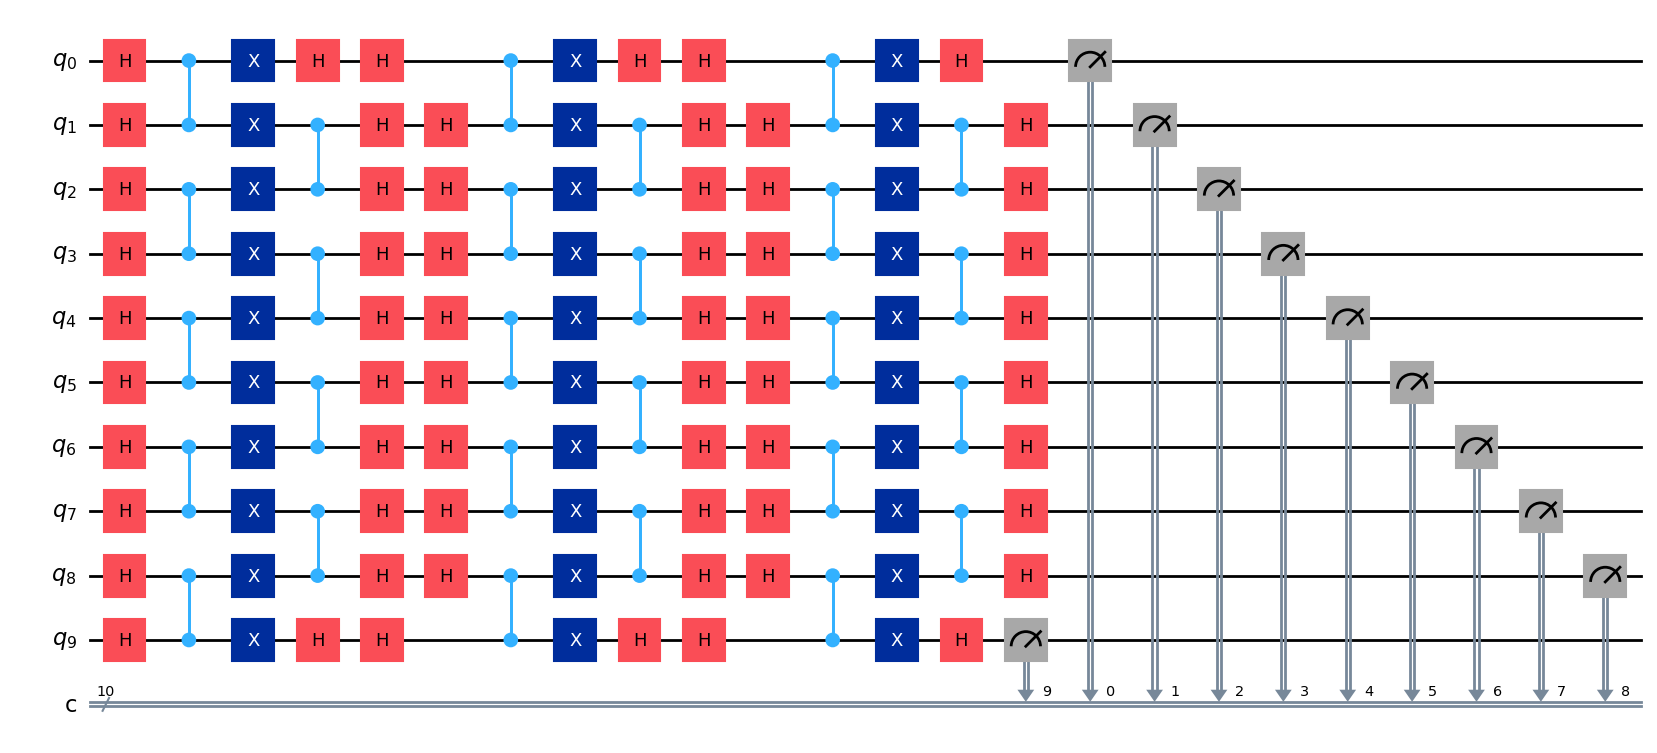
Na extremidade superior, alguns desses são bastante profundos. Vamos usar o AerSimulator sem modelo de ruído para obter os estados ideais ao final de cada um desses circuitos. Podemos então comparar nossos resultados de computadores quânticos reais usando a fidelidade de Hellinger.
from qiskit_aer import AerSimulator

sim = AerSimulator()
ideal_results = sim.run(circuits, shots=8192).result()
ideal_counts = ideal_results.get_counts()
Agora definimos um SamplerV2 com twirling, e um sem twirling.
from qiskit_ibm_runtime import SamplerV2 as Sampler

shots = 8192

# --- No Twirling ---
sampler_no = Sampler(mode=backend)
sampler_no.options.twirling.enable_gates = False
sampler_no.options.twirling.enable_measure = False
sampler_no.options.default_shots = shots

# --- With Twirling ---
sampler_tw = Sampler(mode=backend)
sampler_tw.options.twirling.enable_gates = True
sampler_tw.options.twirling.enable_measure = False
# sampler_tw.options.twirling.num_randomizations = "auto"
sampler_tw.options.twirling.num_randomizations = 32
sampler_tw.options.twirling.strategy = "active-circuit"
sampler_tw.options.default_shots = shots
Agora executamos nossos jobs.
# Each job took 17 sec (34 sec total) on ibm_fez. Your times might vary.

job_no = sampler_no.run(circuits)
job_tw = sampler_tw.run(circuits)

res_no = job_no.result()
res_tw = job_tw.result()
Obtemos as contagens de cada uma das execuções em um computador quântico real.
counts_no = [r.data.c.get_counts() for r in res_no]
counts_tw = [r.data.c.get_counts() for r in res_tw]
Agora encontramos a fidelidade de Hellinger comparando cada uma dessas execuções com os resultados do AerSimulator sem ruído.
from qiskit.quantum_info import hellinger_fidelity

f_no = [hellinger_fidelity(counts_no[i], ideal_counts[i]) for i in range(len(circuits))]

f_tw = [hellinger_fidelity(counts_tw[i], ideal_counts[i]) for i in range(len(circuits))]
Agora visualizamos nossos resultados.
import matplotlib.pyplot as plt

plt.figure(figsize=(8, 5))
plt.plot(two_qubit_depths, f_no, "o-", label="No Twirling")
plt.plot(two_qubit_depths, f_tw, "o-", label="With Twirling")
plt.xlabel("Two-qubit transpiled depth")
plt.ylabel("Hellinger Fidelity")
plt.title("RTZ Echo Circuit: Twirling vs No Twirling")
plt.legend()
plt.grid(True)
plt.show()
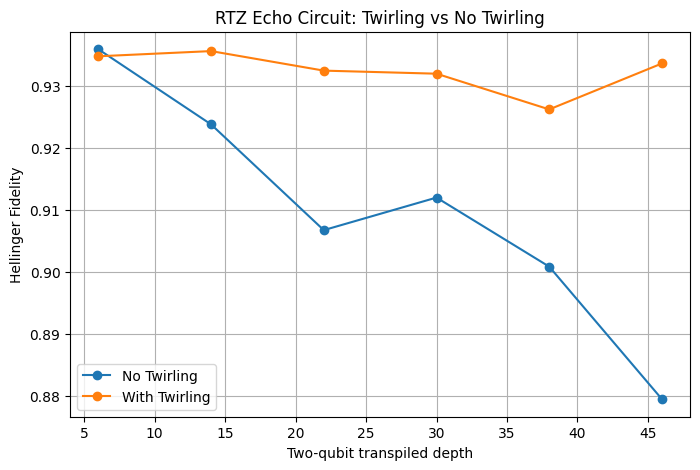
Ao longo desta lição, examinamos casos em que a twirling de Pauli é usada para limitar o acúmulo de erro coerente, um contexto em que ela poderia ser descrita como supressão de erro. No entanto, a twirling de Pauli é frequentemente mais útil como ferramenta para remodelar o comportamento do erro, convertendo erros coerentes em uma forma mais previsível e mais fácil de modelar. A utilidade disso ficará mais evidente no contexto de técnicas de mitigação de erro como a extrapolação de ruído zero (ZNE), que dependem de um escalonamento de ruído razoavelmente previsível. Isso é discutido na próxima lição.