Mitigação de erros
Esta lição fornece o contexto de várias técnicas de mitigação de erros para ajudar os usuários a desenvolver intuição sobre como e quando elas são mais bem usadas. É importante notar que as aplicações modernas dessas técnicas aproveitarão ferramentas mais sofisticadas, como Samplomatic, Shaded Lightcones e Executor. Esses fluxos de trabalho serão abordados em lições posteriores.
Este vídeo apresenta uma visão geral das técnicas de mitigação de erros. O texto abaixo acrescenta mais detalhes e explora esses métodos usando o Qiskit.
Visão geral das técnicas de mitigação de erros
Mitigação de erros refere-se a qualquer processo que tenta reduzir os efeitos dos erros em computações quânticas depois que eles ocorreram. Ela é diferente da supressão, que tenta evitar os erros, e da correção de erros, que codifica informação em muitos qubits físicos e verifica a consistência dessa informação para preservá-la em um único qubit lógico. Ao longo desta lição, as técnicas de mitigação de erros podem ser mais bem entendidas como métodos para construir melhores estimadores de valores esperados ideais ou melhores amostradores de distribuições de probabilidade, não como métodos para corrigir estados quânticos durante a execução. Vamos examinar os métodos de mitigação de erros abaixo, todos disponíveis no Qiskit e em seus addons, e que são ferramentas promissoras na busca pela vantagem quântica.
Twirled readout error extinction (TREX) torna aleatório o processo de medição aplicando operações de Pauli selecionadas aleatoriamente antes da medição e, depois, desfazendo classicamente seus efeitos conhecidos sobre as bitstrings observadas. Sob premissas adequadas de ruído de medição, isso converte o canal de erro de leitura em uma forma mais simples e mais simétrica, que é mais fácil de calibrar e mitigar.
Matrix-free measurement mitigation (M3) é uma técnica escalável de mitigação de erros de medição que evita construir explicitamente a matriz de atribuição ou sua inversa.
Zero noise extrapolation (ZNE) aproxima o valor que um observável teria na ausência de ruído, escalando artificialmente o ruído por um fator conhecido e extrapolando de volta para o caso de ruído zero. Isso exige que o ruído escale de forma previsível. Essa previsibilidade pode exigir outros métodos discutidos nesta lição (alongamento de pulso, folding de portas e amplificação probabilística de erros (PEA)).
Probabilistic error cancellation (PEC) é uma das técnicas de mitigação de erros mais poderosas, mas também uma das mais caras computacionalmente. Ela funciona aprendendo o comportamento do ruído do sistema e tentando desfazê-lo construindo estatisticamente uma estimativa não enviesada da computação ideal. O PEC produz observáveis corrigidos estatisticamente, não resultados corrigidos por correção de erros.
Agora vamos nos aprofundar em cada um desses métodos.
M3
Os erros de medição são uma das fontes de ruído mais persistentes e específicas de hardware em dispositivos quânticos de curto prazo. Mesmo quando um estado quântico é preparado e evoluído corretamente, a etapa final de leitura pode relatar incorretamente o verdadeiro resultado na base computacional. Esses erros surgem da discriminação imperfeita entre os estados físicos correspondentes a e , do relaxamento durante a medição e de imperfeições na eletrônica de medição. Como resultado, a distribuição observada de bitstrings costuma ser uma versão distorcida da distribuição verdadeira (ideal), com probabilidade reatribuída incorretamente entre os resultados.
A mitigação de medição aborda esse problema modelando explicitamente como os resultados de medição são atribuídos de forma incorreta. Na formulação padrão, esse comportamento é capturado por uma matriz de atribuição , cujos elementos representam a probabilidade de registrar o resultado quando o verdadeiro estado da base era . Se o ruído de medição é clássico e estacionário, o vetor de probabilidades observado se relaciona com a distribuição ideal por uma relação linear simples,
Observe que a matriz de atribuição é um mapa estocástico clássico, não um canal quântico. Ela atua sobre leituras clássicas, não sobre os estados quânticos subjacentes que foram amostrados para obter as leituras.
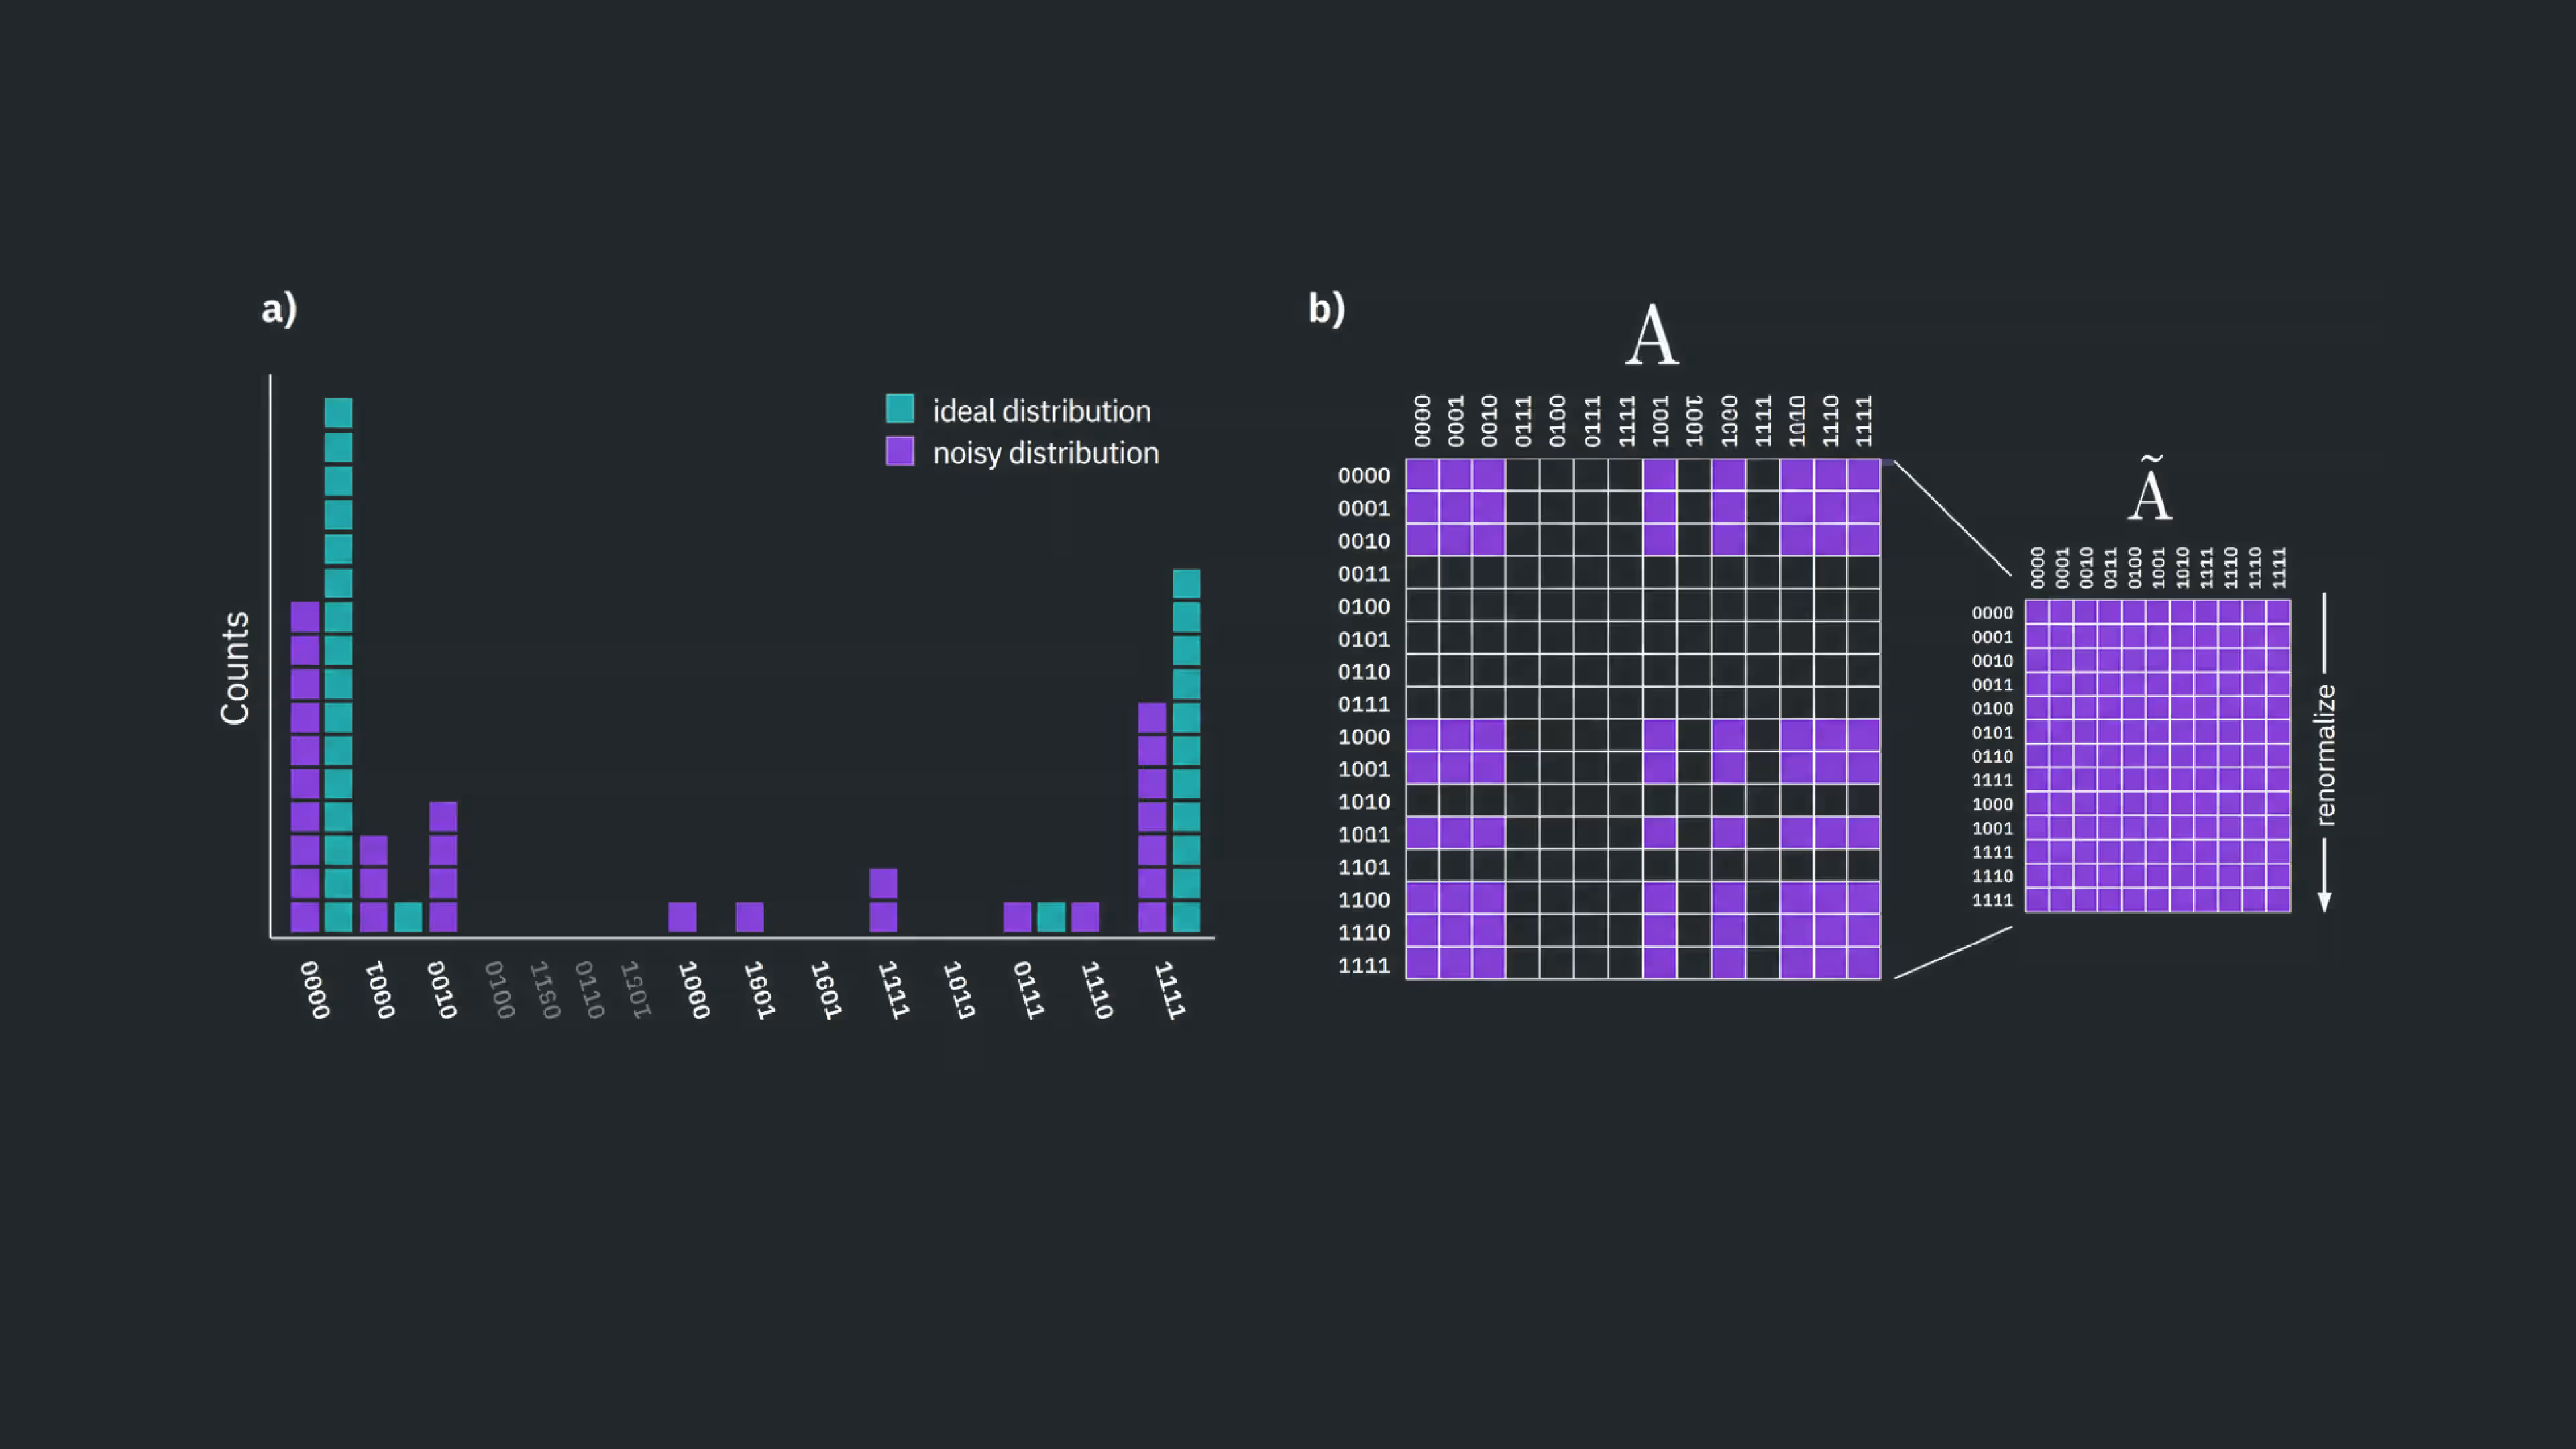
A mitigação de medição sem matriz (M3) usa essa estrutura para construir uma estimativa mitigada de sem nunca formar ou inverter a matriz completa , o que seria inviável para grandes números de qubits. Em vez disso, o M3 explora o fato de que muitas cargas de trabalho quânticas de curto prazo produzem distribuições muito concentradas ou de baixa entropia, de modo que a mitigação se concentra apenas no subconjunto de resultados que contribuem significativamente para a distribuição observada.
Para construir o modelo de atribuição, é preciso executar experimentos de calibração adicionais no hardware quântico. Eles normalmente envolvem preparar estados conhecidos da base computacional e registrar como o sistema de medição os relata. A sobrecarga de calibração escala com o número de qubits medidos, enquanto o custo computacional da mitigação depende da estrutura da distribuição observada. Esse custo é muito menor do que o necessário para caracterizar explicitamente a matriz de atribuição completa . Embora essa sobrecarga de calibração seja real, ela é leve em comparação com técnicas em nível de circuito, como a extrapolação para ruído zero ou o cancelamento probabilístico de erros, o que torna o M3 uma ferramenta prática e amplamente usada para mitigar erros de leitura em experimentos quânticos de curto prazo.
Observe que a calibração só é útil na medida em que o processo de medição permaneça suficientemente estável entre as execuções de calibração e o experimento-alvo.
Primeiro vamos executar um caso simples manualmente para ilustrar como ele funciona e, depois, usar as ferramentas incorporadas ao Qiskit para mostrar o uso do M3 em uma escala mais realista.
Pequeno exemplo de M3
Começamos construindo um estado de Bell simples.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "mthree": "mthree", "numpy": "numpy", "qiskit": "qiskit", "qiskit_aer": "qiskit-aer", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit import QuantumCircuit
import numpy as np

qc = QuantumCircuit(2, 2)
qc.h(0)
qc.cx(0, 1)
qc.measure([0, 1], [0, 1])
<qiskit.circuit.instructionset.InstructionSet at 0x714a5fa4d630>
Podemos usar um simulador com um modelo de ruído porque estamos restringindo este exemplo a um circuito muito pequeno. Configuramos explicitamente nosso modelo de ruído para ter um erro de leitura da forma:
if true=0: [95% chance of reading 0, 5% chance of reading 1]
if true=1: [8% chance of reading 0, 92% chance of reading 1]
Essas taxas de erro de leitura são muito mais altas do que as vistas em computadores quânticos IBM® reais. Os valores altos foram escolhidos por motivos didáticos, para que possamos ver claramente o efeito do M3.
from qiskit_aer import AerSimulator
from qiskit_aer.noise import NoiseModel, ReadoutError

ro_error = ReadoutError([[0.95, 0.05], [0.08, 0.92]])

noise_model = NoiseModel()
noise_model.add_readout_error(ro_error, [0])
noise_model.add_readout_error(ro_error, [1])

backend_noisy = AerSimulator(noise_model=noise_model)
Podemos executar o circuito no simulador com ruído para observar os efeitos do erro de leitura.
result = backend_noisy.run(qc, shots=5000, seed_simulator=123).result()
raw_counts = result.get_counts()
raw_counts
{'01': 290, '11': 2165, '10': 304, '00': 2241}
Em nosso exemplo simplificado, definimos o erro de leitura do nosso modelo de ruído. Mas, ao usar um computador quântico real, o erro de leitura não é conhecido a priori. Em vez disso, ele precisa ser estimado experimentalmente. Para isso, criamos circuitos que preparam um qubit em um estado conhecido da base computacional ou e o medem. Na ausência de erro de leitura, mediríamos exatamente o estado preparado. Coletando estatísticas dessas medições, podemos construir uma matriz de atribuição que descreve o erro de leitura. Neste exemplo simplificado, ela deve ser parecida com a que definimos.
Para um sistema mais realista, seria preciso acumular estatísticas para cada qubit físico. Isso às vezes não é trivial, porque a transpilação mapeia um circuito abstrato para o hardware e o número do qubit muda. Voltaremos a isso no próximo exemplo. Neste exemplo com simulador, atribuímos o mesmo modelo de erro de leitura a todos os qubits, então uma única caracterização é suficiente.
# Define a function to make a state and measure it.
def measure_state(state):
    qc = QuantumCircuit(1, 1)
    if state == 1:
        qc.x(0)
    qc.measure(0, 0)
    return backend_noisy.run(qc, shots=5000, seed_simulator=123).result().get_counts()
# Use the function to get statistics on readout errors
cal_counts_0 = measure_state(0)  # True state = 0
cal_counts_1 = measure_state(1)  # True state = 1

cal_counts_0, cal_counts_1
({'1': 244, '0': 4756}, {'0': 420, '1': 4580})
# Create the normalized readout error matrix

# def normalize(d):
#    s = sum(d.values())
#    return {k: v/s for k,v in d.items()}
# p0 = normalize(cal_counts_0)
# p1 = normalize(cal_counts_1)

p0 = {k: v / sum(cal_counts_0.values()) for k, v in cal_counts_0.items()}
p1 = {k: v / sum(cal_counts_1.values()) for k, v in cal_counts_1.items()}

A_1q = np.array(
    [
        [p0["0"], p1["0"]],  # row: measured 0, columns true 0/1
        [p0["1"], p1["1"]],
    ]
)
A_1q
array([[0.9512, 0.084 ],
       [0.0488, 0.916 ]])
Observe que isso é muito próximo da matriz de erro de leitura usada para construir o simulador.
Novamente, em um computador quântico real teríamos estatísticas como essas para vários qubits físicos. Para este simulador, assumimos que os dois qubits têm erros de leitura idênticos e independentes, o que nos permite construir a matriz de atribuição de dois qubits A_2q como um produto tensorial das matrizes de um qubit correspondentes. Observe também que o objetivo do M3 não é construir a matriz de atribuição inteira. Em vez disso, o M3 se concentra no subconjunto de resultados que contribuem significativamente para a distribuição observada. Vamos construir a matriz inteira para o nosso exemplo muito pequeno para ver como funciona. A implementação do M3 em qiskit-ibm-runtime é mais sofisticada do que este exemplo simplificado, pois precisa lidar com muitos qubits com características de leitura distintas e, ao mesmo tempo, evitar a construção da matriz de atribuição completa.
A_2q = np.kron(A_1q, A_1q)
print(A_2q)
[[0.89794576 0.07107    0.07107    0.005625  ]
 [0.04965424 0.87653    0.00393    0.069375  ]
 [0.04965424 0.00393    0.87653    0.069375  ]
 [0.00274576 0.04847    0.04847    0.855625  ]]
Neste exemplo, assumimos que os erros de leitura em qubits diferentes são independentes, o que permite construir a matriz de atribuição de dois qubits como um produto tensorial das matrizes de um qubit correspondentes.
Obtemos os resultados brutos e mitigados para comparação.
bitstrings = ["00", "01", "10", "11"]
# Normalize raw counts
raw_probs = np.array([raw_counts.get(b, 0) for b in bitstrings], dtype=float)
raw_probs /= raw_probs.sum()
raw_probs
array([0.4482, 0.0592, 0.0598, 0.4328])
Neste ponto, caracterizamos experimentalmente como o processo de medição distorce as probabilidades dos resultados ideais. Nosso objetivo agora é desfazer essa distorção e aplicar a correção resultante às probabilidades brutas.
Como estamos realizando uma inversão linear, e não uma correção física, as "probabilidades" resultantes nem sempre precisam ser positivas. Quase-probabilidades negativas muito pequenas são esperadas e refletem o fato de que a mitigação de medição produz um estimador, e não uma distribuição de probabilidade física.
# Explicit inversion is feasible only for very small systems
# This is why M3 avoids creating the entire A matrix.

A_inv = np.linalg.inv(A_2q)

# Note: mitigated_probs might contain negative values.
# This is expected and reflects estimator, not physical, probabilities.

mitigated_probs = A_inv @ raw_probs
print(mitigated_probs)
[ 4.96000451e-01 -4.69852308e-04 2.17747967e-04 5.04251654e-01]
Convertemos esses valores em contagens para plotagem.
shots = sum(raw_counts.values())  # e.g., 5000
ideal_probs = [0.50, 0.00, 0.00, 0.50]  # ideal Bell distribution
# Convert probabilities to integer counts for plotting only.
# Not physically meaningful when probabilities are negative

def probs_to_counts(bitstrings, probs, shots):
    """
    Convert a probability vector into a Qiskit-style counts dictionary.
    Ensures integer shot counts and correct normalization.
    """
    counts = {}
    # First convert to raw integer counts
    int_counts = [round(p * shots) for p in probs]
    # Fix rounding error by adjusting the last entry
    diff = shots - sum(int_counts)
    int_counts[-1] += diff
    # Build dict
    for b, c in zip(bitstrings, int_counts):
        if c > 0:
            counts[b] = c
    return counts

mitigated_counts = probs_to_counts(bitstrings, mitigated_probs, shots)
ideal_counts = probs_to_counts(bitstrings, ideal_probs, shots)
Por fim, olhamos as distribuições bruta, mitigada e ideal. As "contagens" mitigadas abaixo são apenas um auxílio de visualização obtido reescalando as quase-probabilidades mitigadas.
from qiskit.visualization import plot_histogram

plot_histogram(
    [raw_counts, mitigated_counts, ideal_counts],
    legend=["Raw", "Mitigated", "Ideal"],
    sort="asc",
    title="Raw vs Mitigated vs Ideal",
)
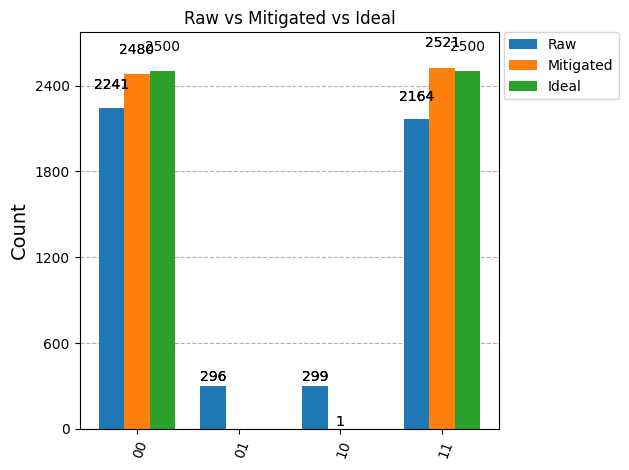
Claramente, os resultados mitigados com M3 estão muito mais próximos das distribuições ideais, e podemos ver por quê.
Aplicar o M3 a fluxos de trabalho mais realistas é muito mais complexo. Considere:
- Computadores quânticos reais contêm muitos qubits físicos, cada um com suas próprias características de erro de leitura. Esses erros precisam ser modelados e combinados de forma adequada.
- A matriz de atribuição completa cresce exponencialmente com o número de qubits e rapidamente se torna impraticável de construir explicitamente. É por isso que o M3 se concentra no subconjunto de resultados que contribuem significativamente para a distribuição observada, em vez de construir a matriz de atribuição inteira.
- Em problemas reais de interesse, a distribuição ideal pode não ser conhecida.
Por todas essas razões, o fluxo de trabalho completo de mitigação está encapsulado no addon mthree do Qiskit.
Exemplo maior de M3
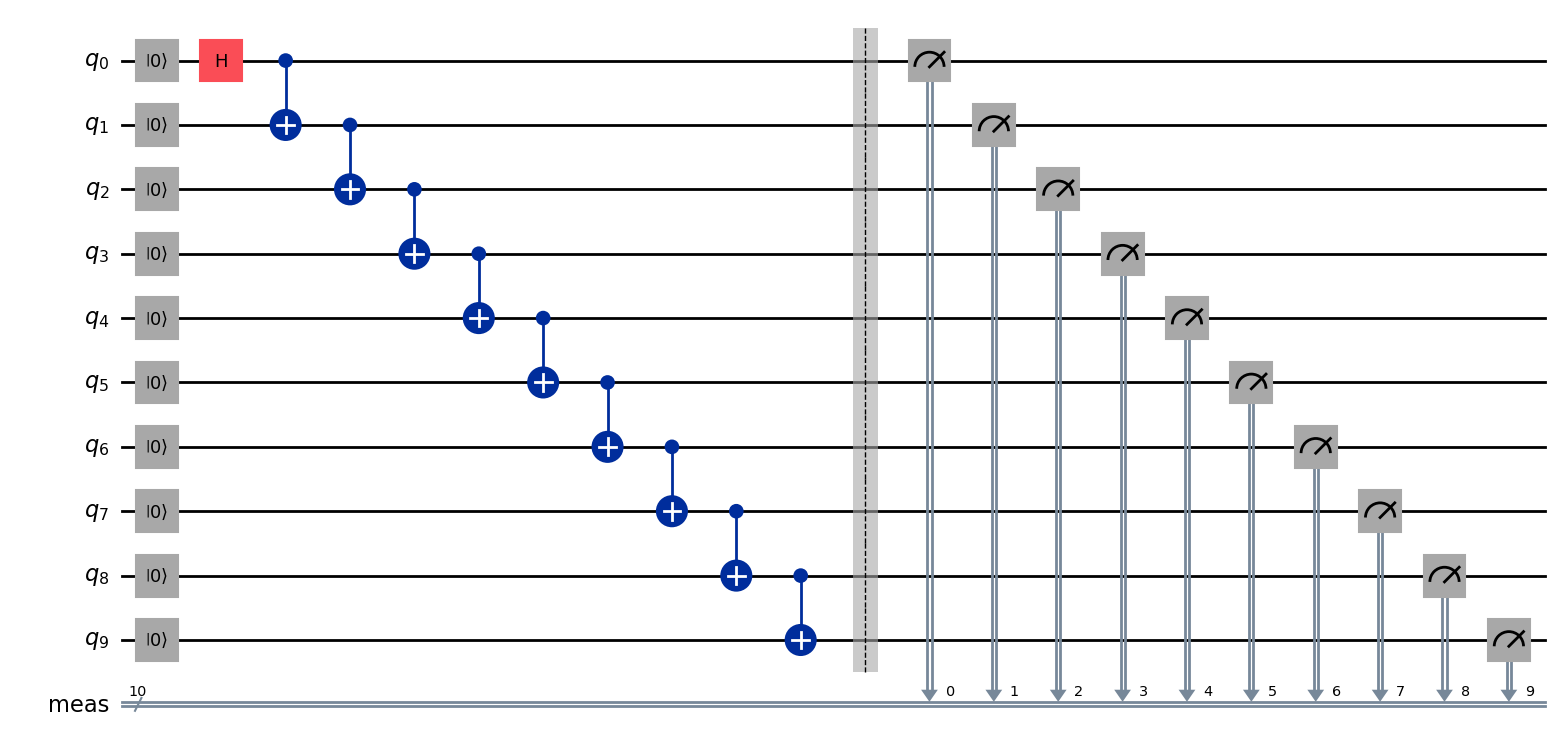
Agora aplicamos o M3 a um circuito maior, no qual determinar manualmente o subespaço relevante de seria trabalhoso, mas que ainda é simples o bastante para que conheçamos a distribuição ideal: um estado GHZ. Começamos importando o pacote mthree e definindo um circuito quântico GHZ.
import numpy as np
from qiskit import QuantumCircuit

# from qiskit_ibm_runtime.fake_provider import FakeCasablancaV2
import mthree

num_qubits = 10

qc = QuantumCircuit(num_qubits)
qc.reset(range(num_qubits))
qc.h(0)
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)
qc.measure_all()
qc.draw("mpl")
Para executar isso em um computador quântico real, importamos qiskit_ibm_runtime e outros pacotes necessários. Usamos SamplerV2 para obter uma distribuição de saídas.
# Import packages needed for using real quantum computers

from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_ibm_runtime.executor_sampler import SamplerV2 as Sampler
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

# --------- Configuration ----------
service = QiskitRuntimeService(channel="ibm_quantum_platform", instance="your crn here")

# backend_real = service.backend("ibm_fez")     # adjust if needed
backend_real = service.least_busy(simulator=False, operational=True)
Agora transpilamos o circuito para o nosso backend. Estamos definindo o nível de otimização como 0 aqui para nos concentrarmos nos efeitos do M3, sem adicionar ferramentas extras. Isso significa que a fidelidade final não será representativa do que é possível alcançar no hardware IBM Quantum® usando o conjunto completo de ferramentas disponíveis, mas nos permite focar especificamente na utilidade do M3.
# Exclude any optimization to focus only on M3 effects
opt_level = 0
pm = generate_preset_pass_manager(optimization_level=opt_level, backend=backend_real)
qc_isa = pm.run(qc)
Agora configuramos o Sampler, novamente desabilitando técnicas adicionais de supressão de erros, como o desacoplamento dinâmico e o twirling.
shots = 8192

# No twirling
sampler_no_twirl = Sampler(mode=backend_real)
sampler_no_twirl.options.twirling.enable_gates = False
sampler_no_twirl.options.twirling.enable_measure = False
sampler_no_twirl.options.default_shots = shots
sampler_no_twirl.options.dynamical_decoupling.enable = False
Por fim, executamos nosso job.
# This job took 7 seconds on ibm_fez. Your actual execution time can vary.
job = sampler_no_twirl.run([qc_isa])
res_real = job.result()
job_id = job.job_id()
print("job number for real  ", job_id)
job number for real d7ark4e5nvhs73a2fu6g
Podemos extrair as contagens brutas do circuito acima.
counts_real = []
for i in range(len(res_real)):
    counts_real.append(res_real[i].data.meas.get_counts())
Agora executamos mthree em nosso backend para caracterizar o modelo de atribuição usado na mitigação de medição. Reescalamos a distribuição bruta usando essa informação. Observe que isso às vezes pode resultar em probabilidades negativas muito pequenas (daí o termo quase-probabilidades).
# Added 6 sec on ibm_fez, on top of original 7 sec to run circuits. Your time might differ.
mit_real = mthree.M3Mitigation(backend_real)
mappings_real = mthree.utils.final_measurement_mapping(qc_isa)
mit_real.cals_from_system(mappings_real)
quasis_real = mit_real.apply_correction(counts_real, mappings_real)
A correção do mthree produz quase-probabilidades, e não contagens. Podemos reescalar para contagens manualmente. A função auxiliar abaixo converte para contagens e arredonda para valores inteiros. Além disso, em circuitos grandes haverá muitas strings errôneas com pouquíssimas contagens, mas que poluem um histograma. A segunda função auxiliar abaixo elimina qualquer string com menos contagens do que um limiar que escolhermos, para nos dar uma visão clara dos termos dominantes da distribuição.
def quasidistribution_to_counts(quasi_list, shots):
    return [
        {bitstr: int(round(float(prob) * shots)) for bitstr, prob in quasi.items()}
        for quasi in quasi_list
    ]

def filter_counts_by_threshold(counts_list, t):
    filtered = []

    for counts in counts_list:
        new_counts = {}
        for bitstr, val in counts.items():
            c = int(round(float(val)))  # FORCE conversion
            if abs(c) >= t:
                new_counts[bitstr] = c
        filtered.append(new_counts)

    return filtered
quasi_counts = quasidistribution_to_counts(quasis_real, shots)
trim_threshold = 30
trimmed_quasi = filter_counts_by_threshold(quasi_counts, trim_threshold)
trimmed_raw = filter_counts_by_threshold(counts_real, trim_threshold)
Também podemos produzir facilmente a distribuição ideal teórica, na qual há probabilidades iguais para os estados todo-zero e todo-um e probabilidade zero para todos os outros resultados, para comparação.
ideal = [
    {
        "0" * num_qubits: int(round(float(shots) / 2)),
        "1" * num_qubits: int(round(float(shots) / 2)),
    }
]
Por fim, podemos visualizar nossos resultados.
from qiskit.visualization import plot_histogram

plot_histogram(
    [trimmed_raw[0], trimmed_quasi[0], ideal[0]],
    legend=["Raw", "Mitigated", "Ideal"],
    sort="asc",
    title="Raw vs Mitigated vs Ideal",
)
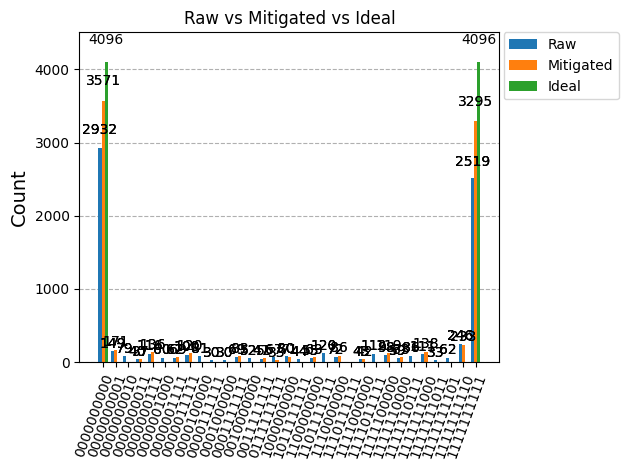
Os resultados mitigados estão mais próximos da distribuição ideal do que os não mitigados. Podemos quantificar isso melhor usando as contagens das bitstrings ideais.
def extract_all_zero_and_all_one(counts):
    """
    Extract counts for the all-0 and all-1 bitstrings.

    Parameters
    ----------
    counts : dict[str, int]
        Counts dictionary.

    Returns
    -------
    dict[str, int]
        Dictionary containing only 00...0 and 11...1 entries if present.
    """
    n = len(next(iter(counts)))  # infer bitstring length
    zero_state = "0" * n
    one_state = "1" * n

    return {k: counts[k] for k in (zero_state, one_state) if k in counts}

correct_counts_raw = extract_all_zero_and_all_one(trimmed_raw[0])
correct_counts_mitigated = extract_all_zero_and_all_one(trimmed_quasi[0])
keys = ["0" * num_qubits, "1" * num_qubits]
fidelity_raw = (
    correct_counts_raw.get(keys[0]) + correct_counts_raw.get(keys[1])
) / shots
fidelity_mit = (
    correct_counts_mitigated.get(keys[0]) + correct_counts_mitigated.get(keys[1])
) / shots
print("Percent correct raw counts: ", fidelity_raw)
print("Percent correct mitigated counts: ", fidelity_mit)
Percent correct raw counts:  0.6654052734375
Percent correct mitigated counts:  0.838134765625
Essa ferramenta simples melhorou nossa fidelidade em 26% em relação à fidelidade não mitigada, com uma sobrecarga bastante baixa. Claramente o M3 pode ser muito valioso. Mas o circuito GHZ foi escolhido como um bom caso de uso porque é muito concentrado em dois estados de saída. Alguns problemas resultam em contagens distribuídas de forma mais uniforme (estados de alta entropia). Em circuitos muito profundos com muitos qubits, erros de porta e ruído não relacionados a erros de medição frequentemente resultarão em um estado de alta entropia. Nesses casos, o M3 opera em um espaço de estados bastante grande. Há três abordagens possíveis para isso:
(1) Aceitar que isso é uma limitação do M3.
(2) Observe que o limite superior do espaço da matriz formada pelo M3 é num_shots num_shots, e não , sendo o primeiro muito menor para um grande número de qubits .
(3) Somente com muito cuidado, remover bitstrings de probabilidade muito baixa das contagens brutas fornecidas ao M3. Isso pode introduzir viés, e a limitação do suporte dos seus estados pode interferir na convergência em abordagens como o método de Krylov. Isso só deve ser feito quando você sabe exatamente por que está fazendo e consegue antecipar todos os seus efeitos. É por isso que esse tipo de corte não é um recurso integrado do M3.
Para mais informações sobre o addon mthree do Qiskit, veja exemplos, instruções de instalação, contexto e referências da API em sua documentação.
Twirled readout error extinction (TREX)
Twirled Readout Error Extinction (TREX) é uma técnica de mitigação de erros de medição usada em computadores quânticos modernos. Seu objetivo é remover o viés introduzido por erros de leitura clássicos sem exigir a caracterização completa nem a inversão da matriz de atribuição de medição.
O TREX não é correção de erros e não melhora a fidelidade do estado. Em vez disso, ele garante que os estimadores de valores esperados sejam não enviesados em relação ao ruído de leitura, até o erro estatístico, calculando médias sobre bases de medição aleatorizadas e reescalando. No hardware IBM Quantum, o TREX é o método de mitigação padrão para estimação de valores esperados e corresponde a resilience_level = 1 na primitiva Estimator do IBM Quantum.
Natureza dos erros de leitura em hardware supercondutor
Em qubits supercondutores da IBM, os erros de leitura são dominados por:
-
Probabilidades assimétricas de inversão de bit (por exemplo, com mais frequência do que o inverso)
-
Relaxamento dependente do estado durante a própria medição
-
Crosstalk leve, mas não desprezível, entre ressonadores de leitura vizinhos
É importante notar que esses erros muitas vezes podem ser modelados como um processo estocástico clássico atuando sobre os resultados de medição. O TREX explora uma ideia padrão de adaptação de ruído (noise tailoring): a aleatorização (twirling) do procedimento de medição. O TREX normalmente avança em duas etapas:
-
Twirling e "untwirling" clássico
-
Reescalonamento dos valores esperados usando circuitos de calibração
Suponha que um valor esperado do observável esteja relacionado a estimativas ruidosas, como a seguinte:
onde é um fator fixo que escala a estimativa e é um viés proveniente das fontes descritas acima. Estamos usando aqui como lembrete de que estamos tratando apenas do erro de leitura; ainda há o erro de porta a considerar.
Imediatamente antes da medição, cada qubit é conjugado aleatoriamente com um operador de Pauli (como I ou X). Os resultados da medição são então "untwirled" classicamente.
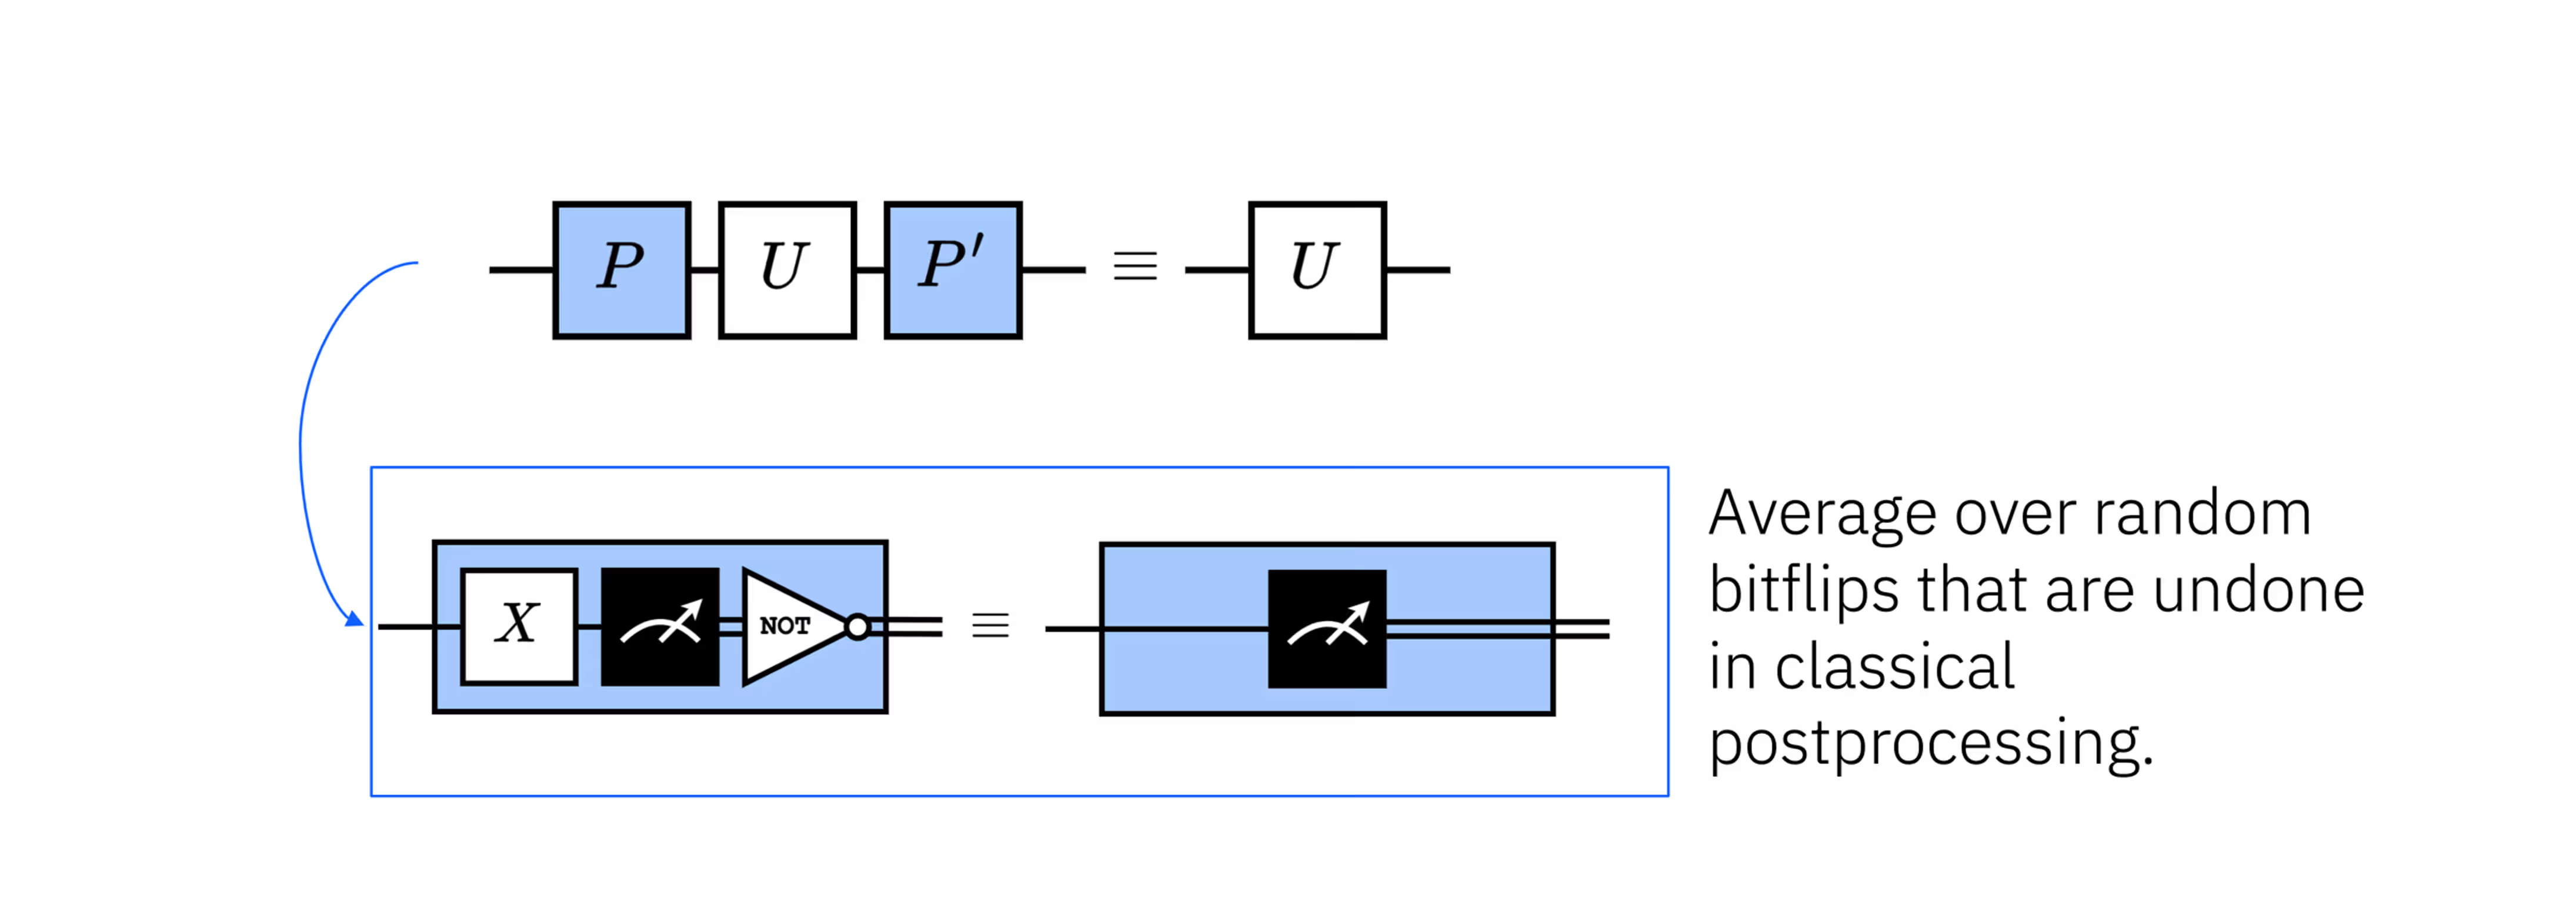
Calcular a média sobre essas aleatorizações simetriza o canal de leitura. Como resultado, assimetrias sistemáticas no processo de leitura são convertidas em um canal de erro mais simétrico, cujo efeito restante pode ser tratado por calibração e reescalonamento. Em termos simples, se, por exemplo, houvesse um viés em direção ao estado , estaríamos perdendo algumas medições de . Ao fazer o twirling em torno da medição, trocamos aleatoriamente qual resultado lógico é associado ao processo de leitura física e depois desfazemos essa troca classicamente. Calcular a média sobre muitas dessas medições aleatorizadas remove a preferência sistemática por um resultado relatado em relação ao outro. Isso remove o viés dominante de medição sob as premissas do modelo TREX, de modo que temos:
No entanto, os valores esperados ainda podem precisar ser reescalados. A segunda etapa usa circuitos de calibração (circuitos com resultados conhecidos) para estimar o fator de escala . Isso pode então ser usado para obter uma estimativa muito melhor.
Os valores esperados de observáveis de Pauli se tornam estimadores não enviesados de seus valores ideais. Nenhum modelo de ruído explícito é aprendido ou invertido, e é por isso que o TREX é numericamente estável e barato. Novamente, o erro de porta não foi tratado aqui.
Na estimação de um valor esperado do observável , pode haver variância devido à amostragem finita, pode haver muitos tipos de erros incoerentes e coerentes, e também pode haver um viés, , devido ao erro de leitura. Esse viés surge de fontes como as transições assimétricas que discutimos. Na prática, esse viés costuma ser bem modelado como um canal estocástico clássico atuando após a evolução quântica. O TREX transforma o canal de medição efetivo de modo que o estimador de seja não enviesado em relação ao erro de leitura. Isso é relativamente fácil de ver usando o exemplo mais simples de portas de twirling: X. Se há assimetria em em comparação com , mas trocamos aleatoriamente qual estado está sendo lido (revertendo depois, classicamente), então isso obviamente remove a assimetria sistemática (embora a amostragem finita ainda signifique que pode haver uma leve assimetria estocástica na medição). Na prática, as portas de twirling para o TREX não se limitam a I e X, mas isso basta para uma explicação.
O TREX nos permite obter uma estimativa de um valor esperado livre de viés devido ao erro de leitura. Ainda pode haver um viés de alguma outra fonte (como super-rotação coerente); o TREX visa apenas a leitura. Como o TREX substitui o viés sistemático por simetrização aleatorizada, ele geralmente converte o viés em variância estocástica adicional, aumentando a variância do estimador a um custo de amostragem fixo.
Verifique seu entendimento
Suponha que usamos o estimator em um circuito que preparou o estado na estimação de . Suponha ainda que erros de medição fazem com que resultados correspondentes a sejam relatados como em 10% das vezes, enquanto resultados correspondentes a são relatados como em apenas 1% das vezes. A assimetria entre esses erros de relato introduz um viés de medição.
(a) Na ausência de quaisquer erros de medição, qual seria o valor esperado ideal do observável ?
(b) Com os erros assimétricos de medição ou leitura, qual é o valor esperado do observável ?
(c) Considere um conjunto limitado de portas de twirling de Pauli: I e X. Suponha que I e X sejam aplicadas aleatoriamente com 50% de probabilidade em múltiplos shots. As mesmas taxas de erro de medição ainda se aplicam. Depois, a porta de Pauli (I ou X) é desfeita classicamente. Faça uma tabela de todos os resultados possíveis e suas probabilidades, devido à superposição inicial, aos erros de medição assimétricos e às portas de Pauli atribuídas aleatoriamente.
(d) Use a tabela para determinar o valor esperado usando a estratégia de twirling.
(e) Compare os valores esperados: ideal, sem twirling e com twirling.
(f) O que foi omitido deste tratamento e que está presente em uma aplicação completa do TREX?
Resposta
(a) Você pode simplesmente usar intuição e simetria para dizer que . Para mostrar explicitamente:
(b) O estado pode colapsar para ou quando medido, cada um com 50% de chance. Mas, dos 50% que colapsam para o estado , 1% deles (ou 0,5% de todos os casos) serão relatados incorretamente como . Dos 50% que colapsam para , 10% (ou 5% de todos os casos) serão relatados incorretamente como . Isso nos deixa com:
- 54,5%
- 45,5% Ignorando todos os outros tipos de erros possíveis, obteríamos uma estimativa de
(c)
| Pauli | Resultado ideal da medição | Resultado após Pauli | Erro de leitura | Desfazer Pauli | Resultado final relatado | Probabilidade |
|---|---|---|---|---|---|---|
| I | 0 | 0 | Nenhum | I | 0 | 50% 50% 99% = 24.75% |
| I | 0 | 0 | I | 1 | 50% 50% 1% = 0.25% | |
| I | 1 | 1 | Nenhum | I | 1 | 50% 50% 90% = 22.5% |
| I | 1 | 1 | I | 0 | 50% 50% 10% = 2.5% | |
| X | 0 | 1 | Nenhum | X | 0 | 50% 50% 90% = 22.5% |
| X | 0 | 1 | X | 1 | 50% 50% 10% = 2.5% | |
| X | 1 | 0 | Nenhum | X | 1 | 50% 50% 99% = 24.75% |
| X | 1 | 0 | X | 0 | 50% 50% 1% = 0.25% |
(d) Das partes anteriores, conhecemos os valores esperados de Z em cada um dos estados finais. Só precisamos calcular a média ponderada:
(e) Neste caso muito simples, nossa aplicação do twirling recuperou exatamente o valor esperado ideal. Isso não é típico. O que é típico é que o twirling desfaz vieses como os introduzidos por transições assimétricas e retorna um valor esperado mais próximo do ideal.
(f) Esta é uma aplicação de modelo simplificado. Pode haver várias coisas faltando. Notavelmente, não executamos circuitos de calibração aqui para estimar um fator de reescalonamento . Isso normalmente é necessário.
Detalhes de implementação
O TREX é aplicado automaticamente ao usar a primitiva EstimatorV2 com resilience_level = 1 (o padrão). Observe que ele não é aplicado automaticamente à primitiva Sampler, porque o Sampler retorna distribuições de probabilidade completas, e não valores esperados.
Quando o TREX está habilitado, o runtime gera variantes de circuito com twirling de medição, inserindo Paulis de um qubit aleatórios imediatamente antes da medição. O pós-processamento clássico reverte esses Paulis. Essas variantes de circuito são aleatórias entre diferentes shots e também entre diferentes qubits dentro de um shot. Todas as variantes de circuito são então combinadas em um único estimador.
O TREX é muito escalável. Ele exige circuitos de calibração adicionais, de modo que a sobrecarga de amostragem costuma ser um pequeno fator constante (frequentemente 2-4x). Mas a mitigação é específica do observável, não preserva a distribuição.
O TREX foi projetado para se integrar bem a muitos métodos de supressão e mitigação de erros, incluindo os seguintes:
-
Desacoplamento dinâmico (DD) - atua durante os tempos ociosos, ortogonal à mitigação de leitura.
-
Twirling de portas ou de Pauli - frequentemente complementar; o TREX já se baseia em twirling, mas visa apenas o ruído de leitura.
-
Zero-Noise Extrapolation (ZNE) - a ZNE visa o ruído de portas, enquanto o TREX trata o viés de medição. Essa combinação é usada no nível de resiliência 2.
-
Amplificação probabilística de erros e cancelamento probabilístico de erros em fluxos de trabalho do Estimator.
No entanto, alguns métodos não podem (ou não devem) ser combinados com o TREX:
-
Correção de probabilidades em nível de Sampler: o TREX não retorna probabilidades de bitstrings corrigidas.
-
Mitigação posterior sobre dados já mitigados pelo TREX: a dupla correção pode reintroduzir viés.
Combinar o TREX com mitigação de leitura baseada em matriz de atribuição, como o M3, é complicado. O M3 assume um canal de medição fixo. O TREX randomiza deliberadamente a medição, invalidando a suposição usada pelo M3. Nesse sentido, você não pode simplesmente combinar essas técnicas. No entanto, se você aplicar twirling de medição durante a calibração usada no M3, talvez consiga aproveitar ao mesmo tempo uma abordagem semelhante à matriz de atribuição e uma abordagem de mitigação por twirling (embora essa abordagem de twirling não seja exatamente igual ao TREX). Este é um tema recorrente ao combinar técnicas de mitigação e supressão: somar técnicas às cegas falha; somá-las com cuidado, de modo que "tenham consciência" umas das outras, pode funcionar e ser muito benéfico.
O TREX só garante valores esperados livres de viés causado por erros de leitura; ele não reduz a variância nem protege contra outros tipos de viés. Certamente não corrige todos os erros. No entanto, costuma ser uma melhoria substancial e pode ser obtido com um overhead muito menor do que alguns outros métodos que exigem aprender modelos de ruído completos. O TREX costuma ser a mitigação de leitura mais barata e robusta disponível, o que o torna um excelente padrão em experimentos.
TREX com Qiskit
Aqui criamos um circuito simples de dois qubits e usamos o Estimator para estimar o valor esperado de um observável muito simples, ZX. O valor esperado ideal é 1. Vamos comparar os valores esperados com e sem o TREX.
# Import packages needed for using real quantum computers

from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp
from qiskit_ibm_runtime import QiskitRuntimeService, EstimatorV2, Session
import numpy as np

# --------- Configuration ----------

backend = service.backend("ibm_fez")  # adjust if needed
Crie o circuito quântico simples.
qc = QuantumCircuit(2)
qc.x(0)
qc.h(0)
qc.cx(0, 1)
qc.h(0)
qc.barrier()
qc.draw("mpl")

Transpile o circuito usando um pass manager.
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

pass_manager = generate_preset_pass_manager(optimization_level=1, backend=backend)

qc_t = pass_manager.run(qc)
Aplique ao observável o mesmo layout da transpilação.
# Observable: X on qubit 0, Z on qubit 1, ideal expectation value is 1.0.
observable = SparsePauliOp("ZX")
observable_t = observable.apply_layout(qc_t.layout)
Execute o experimento em um computador quântico real. Primeiro seguimos com reslience_level = 1; esse é o padrão, mas o deixamos explícito para distinguir os dois casos.
# First, we run this on an ideal simulator to confirm the ideal expectation value.

from qiskit.primitives import StatevectorEstimator as Estimator

estimator = Estimator()

job = estimator.run(pubs=[(qc, observable)])

res = job.result()
val = res[0].data.evs

print("⟨ZX⟩ ideal:", val)
⟨Z₀⟩ ideal: 0.9999999999999996
# This took 27 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 1,  # TREX
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observable_t)])

    res = job.result()
    val = res[0].data.evs

print("⟨ZX⟩ with TREX:", val)
⟨Z₀⟩ with TREX: 0.9520029143897996
Agora definimos resilience_level como 0 para executar sem o TREX.
# This took 12 sec on ibm_fez. Your runtime might differ.
with Session(backend=backend) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 0,  # TREX off
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observable_t)])

    res = job.result()
    val = res[0].data.evs

print("⟨ZX⟩ without TREX:", val)
⟨Z₀⟩ without TREX: 0.8651
O valor esperado fica substancialmente mais próximo do ideal (1) com o TREX, como esperado. É claro que esse foi um único valor esperado em um único qubit. Agora preparamos um circuito usando portas não Clifford e muitos qubits para testar se a melhoria do TREX continua robusta em um cenário diferente.
import numpy as np

num_qubits = 20
qc = QuantumCircuit(num_qubits)
for i in range(num_qubits):
    qc.rx(np.pi * 7 / 8, i)
qc.barrier()
CircuitInstruction(operation=Instruction(name='barrier', num_qubits=20, num_clbits=0, params=[]), qubits=(<Qubit register=(20, "q"), index=0>, <Qubit register=(20, "q"), index=1>, <Qubit register=(20, "q"), index=2>, <Qubit register=(20, "q"), index=3>, <Qubit register=(20, "q"), index=4>, <Qubit register=(20, "q"), index=5>, <Qubit register=(20, "q"), index=6>, <Qubit register=(20, "q"), index=7>, <Qubit register=(20, "q"), index=8>, <Qubit register=(20, "q"), index=9>, <Qubit register=(20, "q"), index=10>, <Qubit register=(20, "q"), index=11>, <Qubit register=(20, "q"), index=12>, <Qubit register=(20, "q"), index=13>, <Qubit register=(20, "q"), index=14>, <Qubit register=(20, "q"), index=15>, <Qubit register=(20, "q"), index=16>, <Qubit register=(20, "q"), index=17>, <Qubit register=(20, "q"), index=18>, <Qubit register=(20, "q"), index=19>), clbits=())
Aqui, não há nada de especial no ângulo de rotação . Simplesmente escolhemos uma superposição desigual qualquer de e para investigar os efeitos de transições erradas assimétricas e como o TREX as trata. Dado esse estado, o valor esperado ideal de Z em cada qubit, na ausência de quaisquer erros (de leitura ou outros), seria:
Portanto, esperamos obter valores esperados próximos de -0,924 em todos os qubits. Vamos ver se o TREX melhora cada valor esperado individualmente e também se melhora a média sobre todos os qubits.
Verifique seu entendimento
Verifique o valor esperado acima por meio de um cálculo direto.
Resposta
Transpilamos usando um pass manager.
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

pass_manager = generate_preset_pass_manager(optimization_level=1, backend=backend_real)

qc_t = pass_manager.run(qc)
Agora construímos um observável por qubit para podermos estimar todos os vinte valores esperados em um único fluxo de trabalho. Ou seja, para o -ésimo qubit, queremos um observável com identidades em todas as posições, exceto na -ésima, onde queremos um . Lembre-se de aplicar também aos seus observáveis o layout transpilado.
# Observables: Z on qubit i for all i.
observables = []
for i in range(num_qubits):
    obs_string = "I" * i + "Z" + "I" * (num_qubits - i - 1)
    obs = SparsePauliOp(obs_string)
    observables.append(obs)
observables_t = [obs.apply_layout(qc_t.layout) for obs in observables]
Agora podemos executar. A célula de código abaixo usa o session mode; se você não tiver acesso a sessões, pode substituí-lo pelo batch mode para executar o mesmo fluxo de trabalho, mas com possíveis tempos de fila entre os circuitos.
# This took 20 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend_real) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 0,  # TREX turned off
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observables_t)])

    res_no_trex = job.result()
    val_no_trex = res_no_trex[0].data.evs

print("⟨Z_i⟩ without TREX:", val_no_trex)
⟨Z_i⟩ without TREX: [-0.90645 -0.89755 -0.89125 -0.9165  -0.87655 -0.91035 -0.8757  -0.87905
 -0.66035 -0.8876  -0.87125 -0.89975 -0.83745 -0.89755 -0.82645 -0.90325
 -0.84385 -0.90195 -0.85865 -0.8884 ]
# This took 36 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend_real) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 1,  # TREX
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observables_t)])

    res_trex = job.result()
    val_trex = res_trex[0].data.evs

print("⟨Z_i⟩ with TREX:", val_trex)
⟨Z_i⟩ with TREX: [-0.92086303 -0.90253698 -0.91688854 -0.93308327 -0.91273953 -0.9221892
 -0.903782   -0.93046052 -0.90348934 -0.90284174 -0.89499677 -0.91630959
 -0.89508481 -0.92233292 -0.90497141 -0.91867138 -0.91421506 -0.91646851
 -0.9268364  -0.91669818]
Aqui comparamos os erros absolutos médios com e sem o TREX.
ideal = np.cos(7 * np.pi / 8)

mean_abs_error_no_trex = np.mean(np.abs(val_no_trex - ideal))
mean_abs_error_trex = np.mean(np.abs(val_trex - ideal))

print("The mean absolute error without TREX is: ", mean_abs_error_no_trex)
print("The mean absolute error with TREX is: ", mean_abs_error_trex)
The mean absolute error without TREX is:  0.05238453251128674
The mean absolute error with TREX is:  0.011980732757900719
zx = list(range(num_qubits))
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values with no DD
ax.scatter(zx, val_no_trex, c="blue", linestyle="-", label="No TREX", alpha=0.7)

## Add values with DD
ax.scatter(zx, val_trex, c="red", linestyle="-", label="With TREX", alpha=0.7)

# Add ideal reference line
ax.axhline(y=-0.924, color="black", linestyle="--", linewidth=2, label="Ideal ⟨Z⟩")

# Add labels and plot
ax.set_xlabel("Qubits")
ax.set_ylabel("<Z>")
ax.legend()
ax.set_title("<Z> in RX(7pi/8)|0> state with and without TREX")
ax.grid(True)

plt.show()
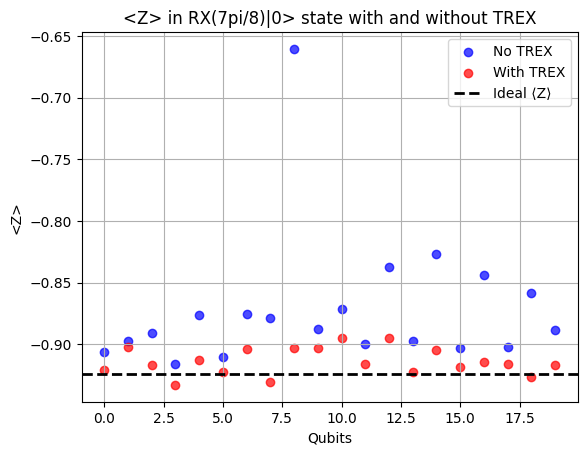
O TREX certamente parece ter ajudado. O valor esperado em cada qubit melhorou, com a única exceção do qubit 16. Um valor atípico desse tipo é esperado. Podemos quantificar a aplicação geral do TREX ao circuito tomando os valores médios.
mean_no_trex = sum(val_no_trex) / num_qubits
mean_trex = sum(val_trex) / num_qubits

print("Mean without TREX", mean_no_trex)
print("Mean with TREX", mean_trex)
Mean without TREX -0.8714950000000001
Mean with TREX -0.9137729590315635
Em média, o TREX aproximou nossos resultados cerca de 2,9% dos resultados ideais e nos deixou com um resultado que difere do ideal teórico, em média, em apenas 0,4%. Isso é ótimo, e essa melhoria de baixo overhead é exatamente o motivo de o TREX ser a mitigação de erros padrão no Estimator. Mas precisamos enfatizar mais uma vez que o TREX está removendo um viés do erro de leitura, não corrigindo todos os nossos erros. Escolhemos um estado inicial com boa chance de ser afetado por assimetria na leitura. O efeito teria sido diferente se tivéssemos preparado cada qubit em um estado diferente. Para um argumento trivial de por que isso tem de ser assim, considere o que aconteceria se deixássemos cada qubit no estado fundamental . Não haveria oportunidade de observar (ou corrigir) uma assimetria no erro de leitura entre os estados e .
Extrapolação para ruído zero (ZNE)
A extrapolação para ruído zero (ZNE) é uma das técnicas de mitigação de erros mais usadas. A estratégia geral também é fácil de entender, embora os detalhes de sua implementação sejam complexos. A ZNE funciona assim:
-
Executando um circuito-alvo em vários "níveis de ruído" — modificações no circuito que fazem seu ruído escalar de maneiras previsíveis
-
Estimando o observável de interesse para cada escala de ruído.
-
Extrapolando de volta para ruído zero usando um modelo de ajuste (linear, polinomial, exponencial e assim por diante).
O resultado é uma estimativa do que o observável teria sido no limite de ruído zero implícito no modelo de extrapolação.
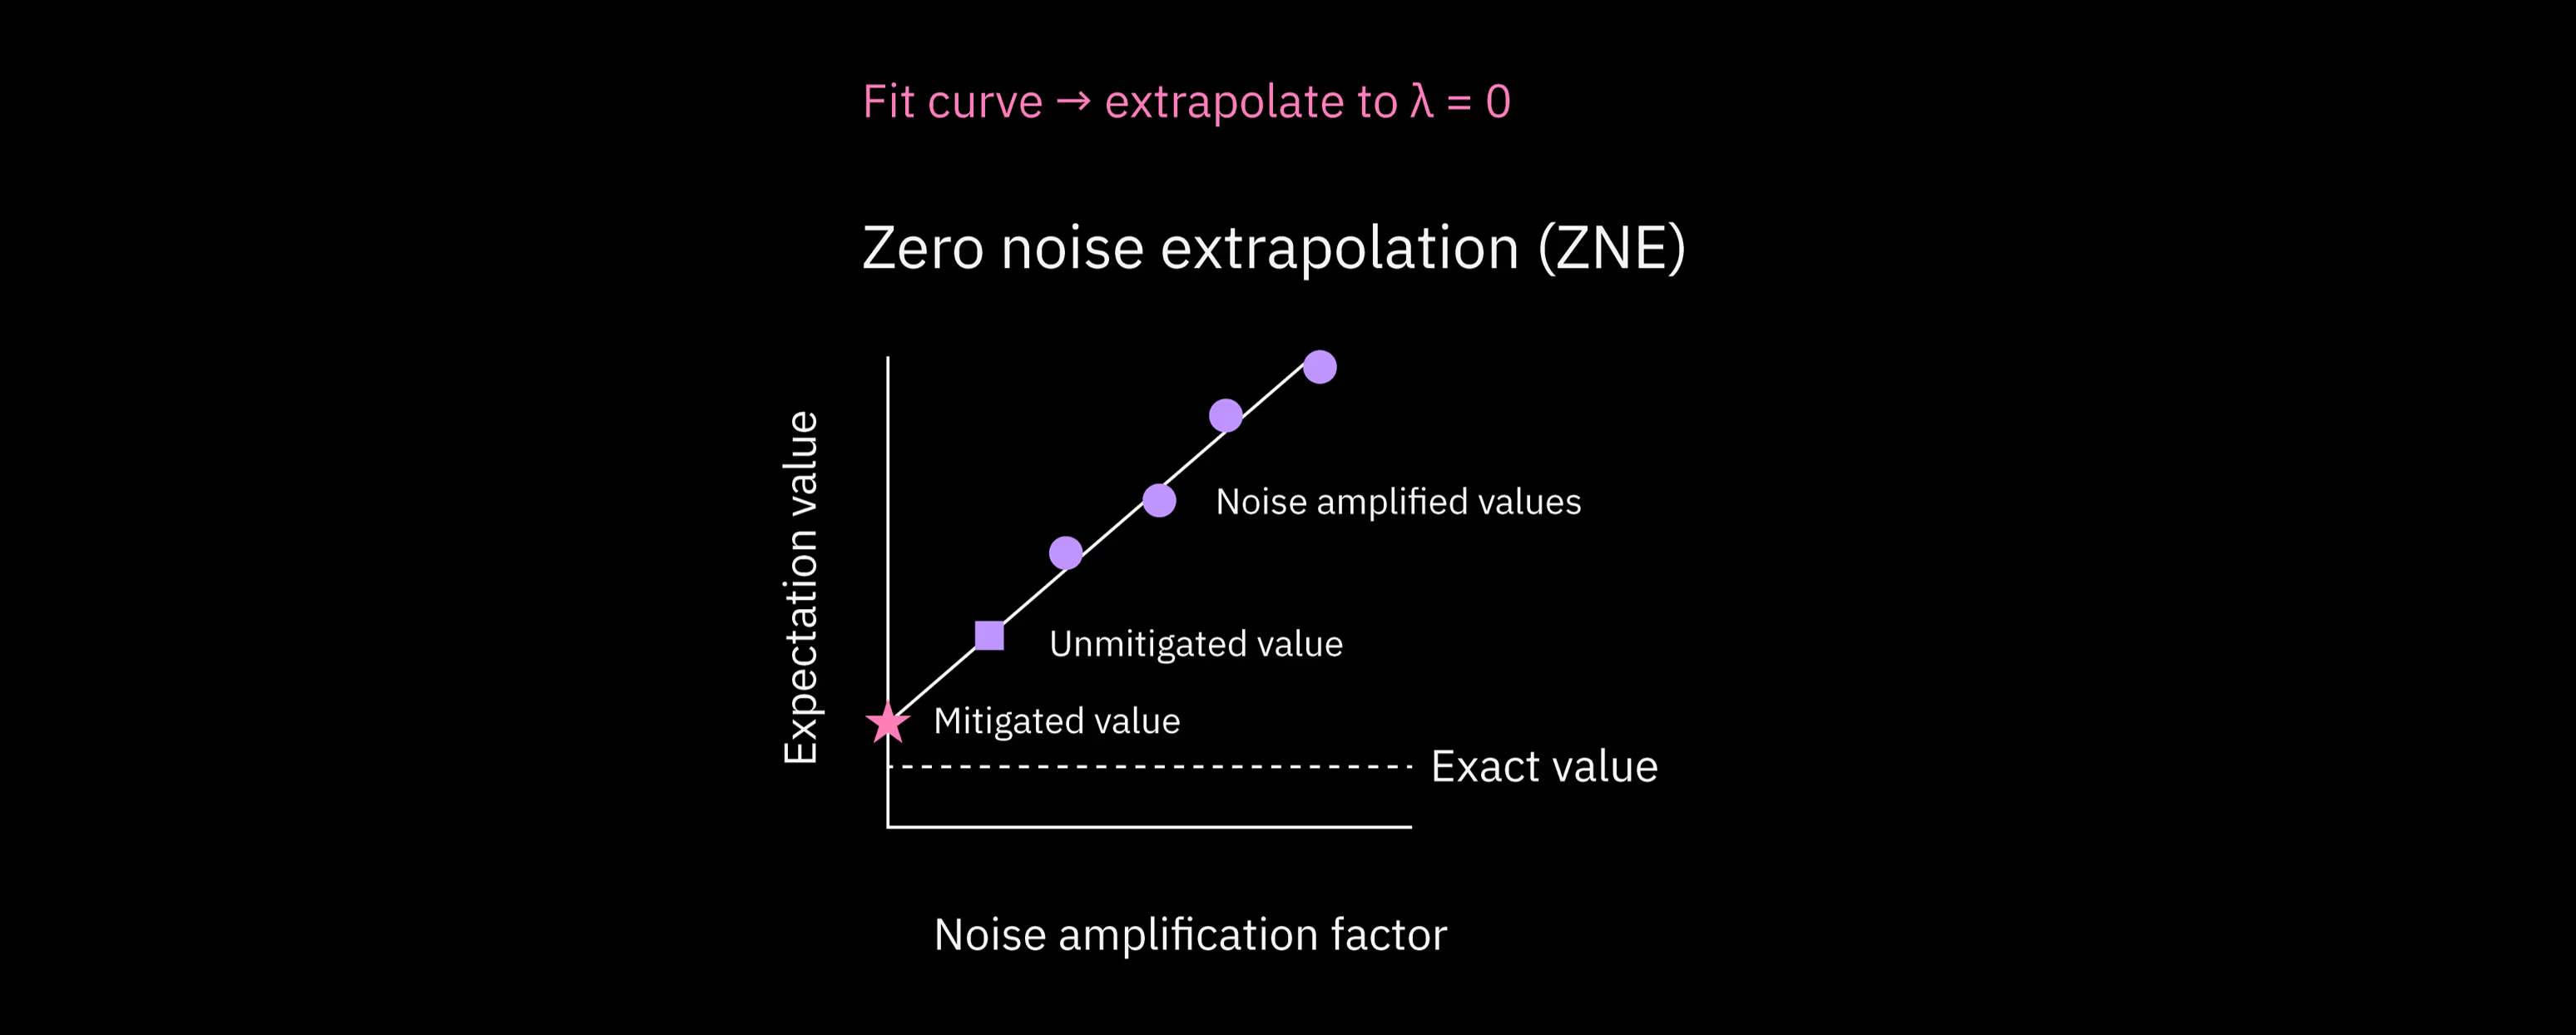
A ZNE não garante que o ruído aumente de forma suave ou linear à medida que modificamos os circuitos. Em vez disso, ela assume que a escala do ruído se comporta bem o suficiente para permitir a extrapolação. A complexidade da ZNE está em como modificar os circuitos para satisfazer essa suposição da melhor forma possível. Vamos examinar algumas abordagens nesta lição.
Escala de recursos da ZNE
Na ZNE, o overhead é principalmente quântico. Ou seja, para obter valores esperados em níveis de ruído, você precisa realizar seu experimento em circuitos, cada um com muitos shots. Para manter uma precisão estatística fixa, o número total de amostras geralmente aumenta à medida que mais circuitos com ruído escalado são introduzidos.
O número de níveis de ruído que você examina, , depende do método usado para escalar o ruído. Para uma técnica simples de escala de ruído (chamada "gate folding", discutida abaixo), costuma ficar entre 3 e 5. Um método diferente (amplificação probabilística de ruído (PNA)) permite fatores de ruído não inteiros e normalmente resulta em níveis de ruído menores que o gate folding. O overhead total escala aproximadamente como:
onde é a contagem de shots de referência. Outro ponto a ter em mente é que, se a escala de ruído envolve portas repetidas, a profundidade do circuito pode aumentar por um fator proporcional ao valor da escala de ruído. O escalonamento do ruído que vem com o aumento da profundidade é justamente o objetivo, mas tenha em mente a profundidade total.
A ZNE é adequada para problemas em que os seguintes pontos se aplicam:
-
Você precisa de um método de mitigação de uso geral, eficaz para muitos tipos de erro.
-
A profundidade do circuito não é muito grande; a ZNE falha quando o circuito escalado fica ruidoso demais para extrapolar.
-
Você tolera um overhead de tempo de execução moderado em troca de maior precisão.
Na prática, isso torna a ZNE ideal para muitos circuitos variacionais, estimativa de valores esperados e outros algoritmos quânticos de curto prazo. Ela é implementada no Estimator usando resilience_level = 2. Observe que a ZNE extrapola em um espaço que tem um único resultado em função do ruído ao longo do circuito. Isso significa que ela se presta a problemas de estimativa, mas não a problemas de amostragem. Ela não foi projetada para funcionar com distribuições de bitstrings.
Fatores de ruído
Como exatamente podemos aumentar o nível de ruído em um circuito? Há duas maneiras principais, embora existam muitas variantes.
-
Substituir uma porta ou bloco de portas por . Como as portas em computadores quânticos são unitárias, sabemos que , de modo que, logicamente: . No entanto, cada repetição de ou adiciona um erro semelhante ou idêntico, permitindo aumentar os níveis de ruído/erro. Observe que a substituição mostrada acima nos leva do ruído original da porta (nível de ruído 1) a três vezes esse nível de ruído em (nível de ruído 3). Na prática, podemos repetir as duas últimas portas vezes: para obter um nível de ruído . Isso é chamado de gate folding, e é uma técnica de escala de ruído muito comum.
-
Existem outros métodos para aumentar o nível de ruído, como a amplificação probabilística de erros (PEA). Na PEA, primeiro aprendemos um modelo de ruído adequado para o circuito, tipicamente expresso como um canal de Pauli. O ruído é então amplificado por amostragem de uma versão reescalada desse canal de ruído aprendido. Ajustando a amostragem, é possível escalar continuamente a intensidade efetiva do ruído, inclusive para valores não inteiros.
Na prática, o gate folding consegue escalar os erros de forma muito confiável, mas também pode levar a circuitos muito profundos. Se você só precisa de três níveis de ruído (1, 3 e 5), isso significa aumentar a profundidade do circuito por um fator de 5 e ainda obter resultados razoáveis. Assim, se o seu circuito-alvo, após a transpilação, tem profundidade de portas de dois qubits de 60 ou mais, a PEA provavelmente é mais adequada que o gate folding.
As portas podem ser dobradas localmente (ou seja, você repete para cada porta de dois qubits assim que ela ocorre) ou podem ser agrupadas em um bloco de portas, e o bloco pode ser repetido (como nas portas ). Muitas vezes a dobra local é preferível para as suposições feitas pela ZNE, mas ambas são possíveis.
Muita nuance está envolvida no tratamento estatístico dos resultados com ruído escalado na ZNE. Por exemplo, com cinco vezes o nível de ruído, seus resultados certamente terão variância maior e serão menos confiáveis. Eles devem ser tratados com o mesmo peso dos pontos de dados com menos ruído? Não. No entanto, para ver a ZNE em ação, vamos ignorar parte dessa complexidade em um experimento de modelo simplificado, no qual construiremos circuitos dobrados manualmente e faremos uma extrapolação ingênua com pesos iguais para ilustrar as etapas principais. Mas, em seguida, faremos um experimento com a funcionalidade de ZNE embutida no Qiskit e veremos que ela lida muito melhor com a complexidade que estamos pulando.
ZNE manual
Começamos selecionando um circuito quântico e um observável para os quais podemos calcular o valor esperado ideal na ausência de ruído e erros. Escolhemos um estado GHZ , com um número par de qubits. Nosso observável é . Escolhemos isso por vários motivos:
- O valor esperado é trivial de calcular no caso ideal. Como o número de qubits é par, obtemos
1de cada , multiplicados entre si, ou obtemos-1de cada , multiplicados entre si um número par de vezes. - Isso será bastante sensível a erros e ruído, pois um único erro em um qubit pode inverter o resultado geral daquele shot de +1 para -1.
- O valor esperado está longe de 0. A ZNE pode encontrar dificuldades quando o valor esperado ideal está muito perto de zero, porque níveis altos de ruído tendem a randomizar os resultados, tornando-os positivos tantas vezes quanto negativos. O resultado é que valores altos de ruído acabam gerando valores próximos do ideal; isso pode tornar a extrapolação muito complicada.
Com essa motivação em mente, vamos construir nossos circuitos.
from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp
from qiskit.transpiler import generate_preset_pass_manager

from qiskit_ibm_runtime import (
    QiskitRuntimeService,
    Estimator,
    EstimatorOptions,
)
num_qubits = 10  # must be even

# # Noise amplification factors used for folding (2* integer +1 for gate folding)
noise_steps = [1, 3, 5]
ghz_amp = []

for j in noise_steps:
    qc = QuantumCircuit(num_qubits)
    qc.h(0)
    # Since CX^2 = I, odd repetitions implement folded versions of the gate.
    for i in range(num_qubits - 1):
        for gates in range(j):
            qc.cx(i, i + 1)
    qc.barrier()
    ghz_amp.append(qc)
Note a sutileza de que aqui . Embora o gate folding tenha sido apresentado como formado por operadores da forma , aqui essa mesma estrutura se parece com CNOT CNOT CNOT.
Vamos garantir que nosso circuito de índice seja de fato o circuito GHZ normal:
ghz_amp[0].draw("mpl")
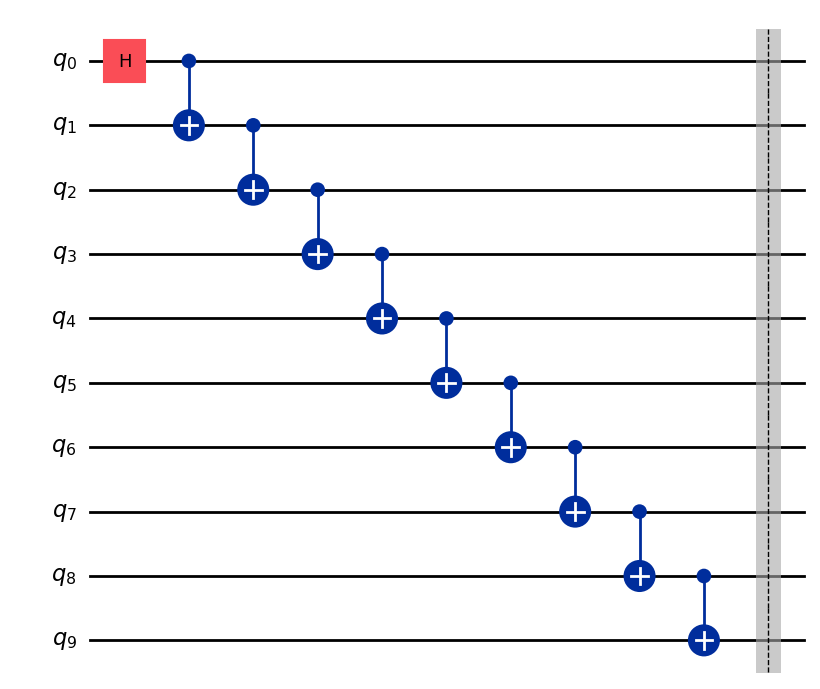
Você pode examinar os outros circuitos para verificar se têm a estrutura esperada.
Agora construímos nossos observáveis.
pauli_string = "Z" * num_qubits
observable = SparsePauliOp(pauli_string)
observables = []
for j in range(len(noise_steps)):
    observables.append(observable)
Construímos um pass manager e o aplicamos aos nossos circuitos. Depois, pegamos os layouts e os aplicamos aos nossos observáveis.
pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=0,
)

qcs_transpiled = []
obs_transpiled = []

for j in range(len(ghz_amp)):
    # Transpile the circuit
    qc_pm = pm.run(ghz_amp[j])
    qcs_transpiled.append(qc_pm)
    # Extract the final layout
    layout = qc_pm.layout
    # Apply the layout to the observable
    obs_transpiled.append(observable.apply_layout(layout))
Formate os pubs.
pubs = [(qc, obs) for qc, obs in zip(qcs_transpiled, obs_transpiled)]
Agora executamos o Estimator. Gostaríamos de focar no papel da ZNE e, por isso, talvez quiséssemos definir resilience_level = 0 para evitar misturar os efeitos do twirling com o efeito da ZNE. No entanto, também queremos comparar nossa ZNE "manual" com as configurações de ZNE embutidas no Qiskit, que incluem twirling. Assim, definimos resilience_level = 1 aqui. Definir resilience_level = 2 invoca as configurações de ZNE do Qiskit, que usaremos em breve.
# This took 21 sec on ibm_fez. Your actual runtime might vary.
options = EstimatorOptions(resilience_level=1)

estimator = Estimator(
    mode=backend_real,
    options=options,
)

job = estimator.run(pubs)

res = job.result()
Agora imprimimos os níveis de ruído e os valores esperados.
# We save this for later comparisons
value_no_zne = res[0].data.evs

# Print all values used for extrapolation
print("Noise level 1: ", res[0].data.evs)
print("Noise level 3: ", res[1].data.evs)
print("Noise level 5: ", res[2].data.evs)
Noise level 1:  0.8327970939283861
Noise level 3:  0.5612869745718734
Noise level 5:  0.3130254281266217
Esta é a parte em que estamos sendo mais displicentes: fazemos um ajuste linear desses dados sem prestar atenção à variância de cada valor obtido e sem tentar prever teoricamente se o ajuste precisa ser linear. Novamente, a ZNE embutida faz um trabalho muito melhor do que o que estamos fazendo manualmente.
# Data
noise_factors = np.array([1, 3, 5])
values = np.array([res[0].data.evs, res[1].data.evs, res[2].data.evs])

# Linear fit: E(lambda) = m * lambda + b
coeffs = np.polyfit(noise_factors, values, deg=1)
slope, intercept = coeffs

print(f"Best-fit slope: {slope}")
print(f"Zero-noise extrapolated value: {intercept}")
Best-fit slope: -0.12994291645044112
Zero-noise extrapolated value: 0.9588652482269501
Vamos plotar isso antes da interpretação.
import matplotlib.pyplot as plt

x_fit = np.linspace(0, 5.5, 100)
y_fit = slope * x_fit + intercept
y_ideal = 1.0

plt.figure()
plt.plot(noise_factors, values, "o", label="Measured data")
plt.plot(x_fit, y_fit, "-", label="Linear fit")
plt.axhline(y_ideal, linestyle="--", label="Ideal")
plt.axvline(0, linestyle="--", color="gray")
plt.scatter(0, intercept, color="red", zorder=3, label="Zero-noise estimate")

plt.xlabel("Noise amplification factor")
plt.ylabel(r"$\langle Z^{\otimes N} \rangle$")
plt.legend()
plt.show()
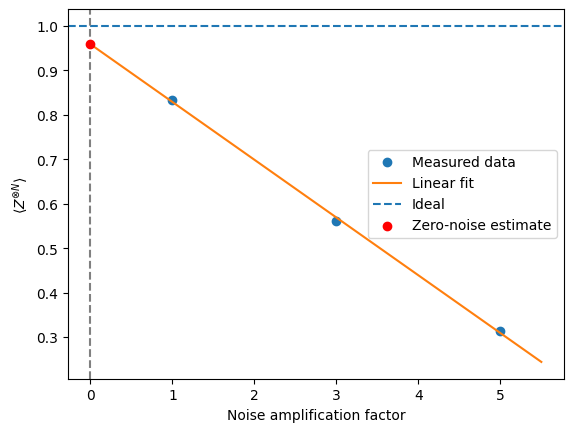
No momento da criação desta lição, da extrapolação para o caso de ruído zero obtemos um valor esperado de 0,959. Seus valores podem ser diferentes. Isso é substancialmente melhor que o valor esperado de 0,83 do circuito bruto, cerca de 13% mais próximo do valor ideal. Mas você também pode ver que estamos usando um ponto de dados em que o valor esperado caiu para 0,31. Obviamente, esse ponto de dados tem qualidade pior. Se esse ponto tivesse recebido um peso menor em nossa aproximação linear, e a reta tivesse sido ajustada mais aos dois primeiros pontos, vemos que a estimativa extrapolada para zero teria sido maior (mais próxima do valor ideal). Esse tipo de consideração é tratado automaticamente na ZNE embutida no Estimator.
ZNE embutida no Estimator
Agora vamos ver o que acontece quando usamos a funcionalidade de ZNE embutida no Estimator. Começamos definindo um circuito GHZ simples, sem nenhum gate folding.
num_qubits = 10  # must be even

qc = QuantumCircuit(num_qubits)
qc.h(0)

for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

qc.barrier()
CircuitInstruction(operation=Instruction(name='barrier', num_qubits=10, num_clbits=0, params=[]), qubits=(<Qubit register=(10, "q"), index=0>, <Qubit register=(10, "q"), index=1>, <Qubit register=(10, "q"), index=2>, <Qubit register=(10, "q"), index=3>, <Qubit register=(10, "q"), index=4>, <Qubit register=(10, "q"), index=5>, <Qubit register=(10, "q"), index=6>, <Qubit register=(10, "q"), index=7>, <Qubit register=(10, "q"), index=8>, <Qubit register=(10, "q"), index=9>), clbits=())
Definimos o mesmo observável de antes.
pauli_string = "Z" * num_qubits
observable = SparsePauliOp(pauli_string)
Definimos novamente um pass manager, usando optimization_level = 1. Voltaremos a essa escolha mais adiante.
pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)
Transpile o circuito e aplique o layout aos observáveis.
# Transpile the circuit
qc_transpiled = pm.run(qc)

# Extract the final layout
layout = qc_transpiled.layout

# Apply the layout to the observable
obs_transpiled = observable.apply_layout(layout)
Executamos o Estimator usando ZNE e twirling e comparamos os resultados com nossa implementação manual da ZNE. Em particular, comparamos com o resultado sem ZNE (value_no_zne).
# This used 18 sec on ibm_fez. Your actual QPU time might vary.

options_zne = {
    "resilience_level": 2,
    "resilience": {
        "zne": {
            "noise_factors": [1, 3, 5],
        }
    },
    "twirling": {
        "enable_gates": True,
        "enable_measure": True,
        "num_randomizations": "auto",
    },
}

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
Podemos recuperar os valores em cada fator de ruído usando a sintaxe job_zne.result()[0].data.evs_noise_factors. Como antes, poderíamos usar esses resultados de forma ingênua para obter um ajuste linear e extrapolar para o caso de ruído zero, mas o estimador com resilience_level = 2 já fez um trabalho melhor, levando em conta a variância e outras considerações. Abaixo mostramos o que uma extrapolação linear geraria e o que a ZNE embutida de fato gerou.
# Data
noise_factors = np.array([1, 3, 5])
values_qiskit_zne = np.array(job_zne.result()[0].data.evs_noise_factors)

# Linear fit: E(lambda) = m * lambda + b
coeffs = np.polyfit(noise_factors, values_qiskit_zne, deg=1)
slope, intercept = coeffs

print(f"Best-fit slope: {slope}")
print(f"Zero-noise extrapolated value: {intercept}")
Best-fit slope: -0.11745451044574956
Zero-noise extrapolated value: 0.9045922788100509
print("Exp val ideal: 1.0")
print("Exp val with no ZNE: ", value_no_zne)
print("Exp val with ZNE: ", value_zne)
print("Fractional improvement: ", (value_zne - value_no_zne) * 100 / 1.0, "%")
Exp val ideal: 1.0
Exp val with no ZNE:  0.8327970939283861
Exp val with ZNE:  0.9877508802932561
Fractional improvement:  15.495378636487 %
import matplotlib.pyplot as plt

x_fit = np.linspace(0, 5.5, 100)
y_fit = slope * x_fit + intercept
y_ideal = 1.0

plt.figure()
plt.plot(noise_factors, values, "o", label="Measured data")
plt.plot(x_fit, y_fit, "-", label="Linear fit")
plt.axhline(y_ideal, linestyle="--", label="Ideal")
plt.axvline(0, linestyle="--", color="gray")
plt.scatter(0, intercept, color="red", zorder=3, label="Linear")
plt.scatter(0, value_zne, color="black", zorder=3, label="Proper ZNE")

plt.xlabel("Noise amplification factor")
plt.ylabel(r"$\langle Z^{\otimes N} \rangle$")
plt.legend()
plt.show()
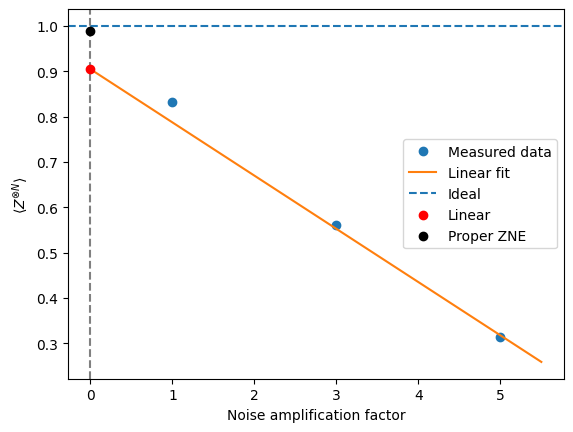
Vemos que a ZNE embutida melhorou nossa estimativa em mais de 15% e funcionou bem melhor que nossa tentativa manual.
Antes de prosseguir, observe que, ao longo desta exploração da ZNE, definimos optimization_level = 1 no pass manager. Níveis mais altos de otimização reduzem o erro, e às vezes essa redução de erro pode fazer os erros escalarem de forma menos previsível. Como acontece com frequência, há um equilíbrio: reduza os erros, exceto quando você os está aumentando intencionalmente por um fator conhecido.
Combinando métodos
A ZNE depende do seguinte:
-
Um parâmetro de escala de ruído bem definido
-
Escala suficientemente suave e previsível dos valores esperados com
-
O mesmo canal de ruído efetivo, em intensidades diferentes
-
Nenhum viés introduzido que não escale com
A ZNE combina bem com técnicas que removem vieses que não escalam (como o M3) ou tornam o ruído mais regular (como o twirling), mas entra em conflito com técnicas que tentam cancelar o ruído por completo (PEC) ou remodelá-lo dinamicamente (DD).
Em particular, o M3 trata apenas do erro de medição/leitura, que na prática pode ser tratado separadamente dos erros de porta (que são o foco dos processos de escala de erro na ZNE). O M3 é em grande parte independente do gate folding; pode ser combinado com a ZNE sem problemas. O TREX é muito semelhante e pode ser combinado com a ZNE.
O Pauli twirling, diferentemente do M3 e do TREX, foca nas portas. No entanto, lembre-se de que o Pauli twirling não mitiga diretamente o erro/ruído; em vez disso, ele o transforma para torná-lo mais previsível. O Pauli twirling pode até ser benéfico para o processo da ZNE, ao fazer os erros de porta escalarem de forma mais linear e, assim, tornar a extrapolação mais precisa.
O desacoplamento dinâmico (DD) é mais sutil. O DD altera dinamicamente o comportamento do ruído ao cancelar parcialmente certos erros por meio da adição de sequências de portas. Se for possível construir circuitos de modo que o DD se comporte da mesma forma mesmo quando portas ou blocos são dobrados, então em princípio seria possível combinar ZNE e DD, mas na prática o DD às vezes interfere na escala. Se você quiser combiná-los, os pontos a considerar incluem os seguintes:
- O DD é aplicado de forma consistente em todos os níveis de ruído?
- A dobra preserva a estrutura do DD?
- A escala de ruído resultante ainda se comporta de forma monotônica?
O último método de mitigação de erros que discutiremos como abordagem independente não é compatível com a ZNE: o cancelamento probabilístico de erros.
Cancelamento probabilístico de erros (PEC)
Diferentemente da ZNE ou da mitigação de medição, o PEC tenta cancelar o ruído no nível das portas, reconstruindo em valor esperado o canal ideal. O cancelamento probabilístico de erros (PEC) é a técnica de mitigação de erros mais poderosa e mais cara abordada nesta lição. O PEC se baseia na inversão explícita do canal de ruído, realizada de forma estatística e não física. O PEC funciona assim:
-
Caracterizando o modelo de ruído em termos de uma base de "operações de erro".
-
Expressando o inverso do canal de ruído como uma distribuição de quase-probabilidade sobre operações físicas.
-
Amostrando dessa distribuição durante a execução do circuito para construir estatisticamente uma estimativa não enviesada da computação ideal.
Conceitualmente, o PEC é como uma correção de erros virtual — ele "desfaz" o ruído combinando operações ruidosas em padrões aleatórios cuidadosamente ponderados. Do ponto de vista procedimental, porém, o PEC não tem relação próxima com códigos de correção ou detecção de erros. A estimativa não enviesada do valor esperado ideal, sem ruído, feita pelo PEC vem ao custo de um overhead de amostragem muito grande e de uma forte dependência de uma caracterização precisa do ruído.
Nos computadores quânticos da IBM, o PEC é visto da melhor forma como uma ferramenta de precisão, e não como uma camada de mitigação de uso geral: é mais apropriado para circuitos pequenos ou pequenas partes de circuitos maiores, tarefas de benchmarking e estudos de alta precisão em que um alto overhead quântico é aceitável.
Caracterizando o canal de ruído
No PEC, cada porta ideal de um circuito quântico é modelada como um canal unitário ideal seguido por um processo de ruído. Seja a matriz densidade do estado quântico. A porta ideal é representada por uma matriz unitária , que induz um canal quântico:
Em hardware real, essa evolução ideal é corrompida pelo ruído. Modelamos a implementação física da porta como um canal ruidoso efetivo:
onde é um canal de ruído que captura os erros estocásticos associados à porta. Ao longo desta discussão, , e são mapas lineares que agem sobre operadores densidade. O canal ideal é unitário e reversível, enquanto o canal de ruído (e, portanto, ) é um mapa completamente positivo que preserva o traço (CPTP).
O PEC assume que o canal de ruído é conhecido ou aproximadamente conhecido. No hardware da IBM Quantum, essa informação normalmente é obtida a partir de dados de calibração do dispositivo, taxas de erro inferidas de experimentos de benchmarking e modelos de ruído simplificados, como aproximações de Pauli ou despolarizantes para pequenos conjuntos de portas. Embora o PEC não exija um modelo de ruído perfeitamente preciso, seu desempenho se degrada rapidamente à medida que o canal de ruído assumido diverge do comportamento real do hardware.
Decomposição em quase-probabilidades do canal de ruído inverso
A ideia central do PEC é cancelar o efeito do ruído em valor esperado construindo uma aproximação estocástica do inverso do canal de ruído. Formalmente, o objetivo é aplicar um mapa linear que desfaça aproximadamente , de modo que:
em valor esperado ao longo de muitas execuções do circuito.
O inverso é definido aqui como o inverso algébrico de tratado como um superoperador linear que age sobre operadores. Esse inverso só existe se tiver posto completo; processos de ruído não invertíveis não podem ser mitigados exatamente com o PEC.
Quando a inversão é possível, o PEC expressa o canal de ruído inverso como uma combinação linear de operações fisicamente implementáveis:
Aqui, cada é uma operação ruidosa que pode ser executada no hardware (tipicamente portas nativas ou sequências curtas de portas), e os coeficientes reais formam uma distribuição de quase-probabilidade. Diferentemente das probabilidades comuns, os coeficientes podem ser negativos ou exceder 1.
A norma de quase-probabilidade:
quantifica o custo da inversão do ruído. Para qualquer canal de ruído não trivial, . No hardware da IBM Quantum, essa decomposição normalmente é realizada:
- por porta ou por pequeno conjunto de portas,
- assumindo modelos de ruído restritos (frequentemente aproximações diagonais de Pauli),
- usando operações nativas específicas do backend e restrições de agendamento.
Reconstrução de Monte Carlo do circuito ideal
Para estimar o valor esperado de um observável , o PEC usa amostragem de Monte Carlo com base na decomposição acima. Para cada ocorrência de uma porta ruidosa no circuito, aplica-se o seguinte procedimento:
-
Selecione aleatoriamente uma operação com probabilidade:
-
Atribua um peso clássico:
-
Execute o circuito ruidoso randomizado resultante no backend quântico.
-
Multiplique o resultado medido pelo produto de todos os pesos acumulados.
-
Calcule a média dos resultados ponderados ao longo de muitas execuções do circuito.
O estimador resultante satisfaz
desde que o modelo de ruído descreva com precisão o hardware. O PEC, portanto, não introduz nenhum viés sistemático em valor esperado, mas troca o viés por grande variância estatística. Cada execução produz uma estimativa ruidosa, porém ponderada; somente após calcular a média de muitas execuções o valor esperado ideal emerge.
Interpretação conceitual
O PEC às vezes é descrito como correção de erros virtual. Embora essa formulação não seja totalmente incorreta, ela não deve ser confundida com a verdadeira correção quântica de erros. O PEC não envolve codificação lógica, extração de síndrome nem feedback em tempo real. Os erros não são evitados nem corrigidos durante a execução do circuito.
Em vez disso, o PEC cancela o ruído estatisticamente, combinando muitas realizações ruidosas do circuito com pesos clássicos com sinal, de modo que os erros só se cancelam após o pós-processamento clássico. A informação não é protegida durante a execução; os resultados ideais são reconstruídos depois.
Escala de recursos e custo
O custo dominante do PEC vem da amplificação da variância. A variância do estimador do PEC escala como:
o que implica:
Essa escala é fundamental e não pode ser melhorada por pós-processamento clássico.
Para circuitos com muitas portas ruidosas, cada porta contribui com um fator , fazendo a norma de quase-probabilidade total crescer aproximadamente de forma multiplicativa:
onde é a profundidade do circuito. No hardware da IBM Quantum, isso normalmente leva a um crescimento exponencial do custo de amostragem com a profundidade do circuito, com sensibilidade particularmente forte aos erros de portas de dois qubits. Essa escala impõe limites práticos à aplicabilidade do PEC.
Atualmente, o PEC só é prático quando uma ou todas as seguintes condições são atendidas:
-
Os circuitos são muito pequenos ou rasos (frequentemente portas),
-
Os modelos de ruído são simples e bem validados (por exemplo, ruído de Pauli),
-
Um alto custo estatístico é aceitável,
-
O objetivo é precisão, e não vazão.
Por esse motivo, o PEC costuma ser aplicado a:
-
Subcircuitos isolados dentro de fluxos de trabalho maiores,
-
Passos de evolução de curta duração,
-
Rotinas de preparação de estado ou de medição,
-
Experimentos de benchmarking e validação.
A pilha de software da IBM (IBM Quantum Compute e ferramentas de mitigação de erros) reflete isso ao tratar o PEC como uma opção especializada, e não como uma camada de mitigação padrão.
Casos de uso típicos do PEC incluem:
-
Benchmarking de precisão de hardware quântico,
-
Verificação de pequenos algoritmos quânticos,
-
Química quântica de alta precisão em sistemas reduzidos,
-
Verificação cruzada da ZNE ou de outros métodos de mitigação.
Relação do PEC com outros métodos de mitigação
Muitas outras técnicas de mitigação trocam precisão por escalabilidade; o PEC faz exatamente o oposto, focando na precisão acima de tudo.
Como o PEC pode ser usado apenas em um subcircuito, é especialmente importante perguntar aqui quais outros métodos de mitigação podem ser combinados com ele. Para raciocinar com clareza sobre a compatibilidade com o PEC, ajuda categorizar as técnicas pelo que elas fazem com o ruído. Considere estas categorias gerais:
-
Cancelamento de ruído - tentam inverter os canais de erro
-
Escalonamento de ruído - aumentam o ruído deliberadamente para extrapolar
-
Remodelagem de ruído - mudam a estrutura ou o espectro do ruído
-
Remoção de viés - corrigem erros que não escalam com o ruído das portas
O PEC se encaixa perfeitamente na categoria (1). Qualquer método que altere ou reescale o canal de ruído deve ser examinado com cuidado.
Tabela-resumo (visão geral)
| Técnica | Compatível com PEC | Observações |
|---|---|---|
| ZNE | Não | Desfazer versus escalar e, às vezes, moldar o erro |
| Pauli twirling | Sim (com cuidado) | Afeta o comportamento do erro, mas pode facilitar seu aprendizado |
| TREX | Sim | Sem sobreposição no fluxo de trabalho. Totalmente compatível. |
| Dynamical decoupling | Geralmente não | Altera o canal de erro |
PEC e ZNE tratam das mesmas fontes de erro (erros de porta) com suposições ou fluxos de trabalho mutuamente incompatíveis, ou ambos. Por exemplo, na ZNE, supomos que o erro pode ser expandido em um parâmetro :
e que o erro pode ser escalado de forma eficaz para modelar essa expansão. O PEC desfaria justamente o erro no qual nos apoiamos para o escalonamento. O parâmetro perderia o sentido. Outra forma de pensar sobre isso é:
-
Aplicar a ZNE antes do PEC muda o canal de ruído que você está tentando inverter.
-
Aplicar o PEC antes da ZNE remove justamente o ruído no qual a ZNE se apoia para extrapolar.
PEC e ZNE devem ser considerados paradigmas alternativos de mitigação de erros, não camadas combináveis. Compará-los lado a lado é instrutivo, enquanto combiná-los não é.
PEC e Pauli twirling são geralmente compatíveis e muitas vezes benéficos. O twirling pode ajudar o PEC porque converte erros coerentes em erros de Pauli estocásticos. Isso simplifica o canal de ruído, facilitando sua representação e inversão. Para o PEC, isso é extremamente valioso, pelos seguintes motivos:
-
As decomposições em quase-probabilidades são muito mais simples para canais de Pauli
-
A norma de quase-probabilidade costuma ser significativamente menor
-
A variância de amostragem é reduzida
Muitas demonstrações de PEC supõem ou incorporam ruído com Pauli twirling. É importante esclarecer que o Pauli twirling não mitiga erros por si só; ele remodela o ruído em uma forma que o cancelamento probabilístico de erros consegue tratar com mais eficiência.
O PEC pode e deve ser combinado com o TREX. Essas abordagens são totalmente compatíveis e têm papéis ortogonais. O TREX atua apenas na medição, remove o viés de leitura por meio de twirls aleatórios do canal de medição e não afeta o ruído das portas nem a dinâmica do circuito. O PEC atua sobre o ruído das portas. Como o erro de medição é aditivo, e não composicional, ele é independente das sequências de portas. É seguro, e muitas vezes desejável, aplicar o TREX junto com o PEC.
A ordem desses métodos é a que você esperaria:
- Execute o circuito randomizado do PEC
- Aplique o TREX para mitigar o erro de leitura
- Aplique a ponderação e a média do PEC
PEC e DD geralmente são incompatíveis, a menos que a caracterização de ruído usada no PEC seja feita com o DD ativo. O PEC supõe que é estacionário, repetível e caracterizável com precisão. O DD remodela explicitamente o canal de ruído no tempo, modulando as interações sistema-ambiente e introduzindo efeitos não triviais de temporização de pulsos. Como resultado, o ruído efetivo com DD não é o mesmo canal que sem DD. Isso se complica ainda mais pelo fato de o canal de ruído poder depender fortemente do escalonamento do circuito. O resultado final é que a inversão do ruído se torna mal definida ou inválida.
Teoricamente é possível caracterizar o ruído com o DD ativo e construir um modelo de PEC de acordo, mas isso é muito avançado e atualmente não é um fluxo de trabalho recomendado.
Aplicando o PEC manualmente
O PEC é complexo e não é recomendado implementá-lo manualmente. Ainda assim, queremos percorrer a matemática de uma aplicação básica em um único qubit para entender quais etapas o processo envolve. Escolhemos um estado misto, mas não trivial, para que possamos ver claramente os efeitos numéricos.
Considere um qubit que deveria estar no estado puro
A matriz de densidade ideal é:
Escolhemos essa matriz de densidade porque ela não é diagonal e é de um único qubit, de modo que é tratável examiná-la "manualmente".
Agora aplicamos um modelo de ruído muito simples, mas realista: um canal despolarizante de um qubit, com pequena intensidade .
Para facilitar a aritmética, tome . Este canal é completamente positivo e preserva o traço (CPTP), como deve ser. É um canal de ruído realista para hardware real, ou pelo menos realista para descrever parte do ruído. Além disso, esse canal de ruído é analiticamente inversível, como mapa linear. Em outras palavras, existe uma matriz inversa, mas isso não significa que ela corresponda a um canal físico CPTP, e certamente não corresponde a um unitário que possa ser implementado no hardware.
Agora aplicamos nosso canal de ruído despolarizante à matriz de densidade de um qubit e obtemos:
Com : e .
So:
Aplicando isso ao nosso estado:
Calculando explicitamente:
Esta continua sendo uma matriz de densidade física, e ainda tem traço um — mas agora é mais misturada.
Agora calculamos o canal inverso ideal, mas estando bem preparados para a possibilidade de que ele não seja físico. Vamos verificar se é. Matematicamente, o mapa linear inverso é:
Se essa ação inversa fosse ela mesma um canal físico válido, ficaríamos tentados a implementá-la exatamente. Claro, ainda precisaríamos descobrir como implementá-la usando operações unitárias e etapas clássicas, mas esse seria o objetivo. No entanto, acontece que ela não é CPTP, e em geral não há garantia de que tais mapeamentos inversos sejam CPTP. Isso é crítico para a nossa discussão atual, porque é a razão pela qual o PEC existe.
Talvez você consiga ver que ela não é CPTP só de olhar. Uma verificação infalível é aplicá-la a uma matriz de densidade e ver se ela retorna resultados físicos. Isso fica como exercício para verificar sua compreensão.
Verifique sua compreensão
Verifique se o mapeamento inverso acima é CPTP aplicando-o a uma nova matriz de densidade:
Interprete os resultados como físicos ou não físicos.
Resposta
Como matriz de densidade física, isso corresponde a uma probabilidade clássica maior que 1 de o sistema estar no estado e a uma probabilidade negativa de estar no estado . Claramente esse mapeamento pode produzir matrizes de densidade sem sentido. Além disso, por inspeção podemos ver que os autovalores da matriz de densidade resultante são 1.0625 e -0.0625, o que significa que nem todos os autovalores são positivos. Assim, o mapeamento não é "completamente positivo", o "CP" de CPTP.
Verifique sua compreensão
Verifique por cálculo explícito que a operação inversa acima desfaz o canal de ruído e devolve o estado sem ruído.
Resposta
Aplique-a ao estado ruidoso:
Este é exatamente o estado original (a menos de arredondamento).
Reforçamos para ficar absolutamente claro: não podemos inverter o canal de ruído exatamente; o inverso não é CPTP, nem é um canal físico válido. No entanto, podemos inverter efetivamente o canal como uma combinação linear de canais físicos.
Para o canal despolarizante:
onde: etc.
O inverso pode ser escrito como:
with:
-
= canais de Clifford fisicamente implementáveis
-
= quase-probabilidades
-
Some
Esta é a ideia central do PEC:
-
Amostre canais de acordo com ∣
-
Atribua sinais aos resultados de medição
-
Os valores esperados convergem para o valor sem ruído
Aplicamos o PEC "manualmente" à estimativa de usando a matriz de densidade e vemos se conseguimos recuperar os resultados de . Para esperamos:
Observe também que, para a matriz de densidade ruidosa, obtemos:
É a ordem de grandeza correta, mas significativamente distante do caso ideal.
Agora vamos ver como, com o processo do PEC, podemos reconstruir o valor esperado sem viés a partir da matriz de densidade ruidosa. Em fluxos de trabalho reais, isso é probabilístico e será automatizado. Neste fluxo "manual", escolheremos valores probabilísticos realistas, mas talvez convenientes para a nossa apresentação. Isso não deve ser interpretado como uma afirmação de que o PEC é perfeito. É apenas para mostrar um cenário plausível que poderia acontecer dentro dos pacotes de PEC.
Lembre-se de que nosso canal de ruído tem a forma:
O inverso pode ser escrito (exatamente) como:
based on symmetry of the transformation and the completeness of the Pauli operators. Inverting the noise channel somehow in the estimation process should yield an estimator that is unbiased and normalized. To do this, we must at least determine the coefficents and and then think about how to implement the inverse transformation. When done by a noise learner, the inversion of this noise channel would be done at the channel level, independent of a specific case like our density matrix. The coefficients and would come from this inversion.
Para esta introdução, é mais simples focar no efeito do canal sobre a nossa matriz de densidade. Isso nos permite trabalhar com objetos familiares, como matrizes de densidade e valores esperados. Para isso, considere o que deve ser verdade sobre os efeitos dessa operação inversa em nosso processo de estimativa: o estimador produzido pelo PEC deve ser normalizado e sem viés. Isso corresponde a duas condições:
-
Normalização: para garantir que essa operação não altere a escala do observável, exigimos que . Para ver por que isso acontece, poderíamos considerar a ação do inverso sobre uma matriz de densidade, ou sua ação sobre o valor esperado de algo trivial como o próprio .
-
Calibração: em um fluxo de trabalho real, usamos circuitos de calibração para aprender o comportamento do ruído no nível das portas. Em seguida, usamos esse conhecimento do ruído no nível das portas, e a linearidade dos valores esperados, para aplicar o modelo de ruído aprendido ao circuito maior. No nosso caso, partimos do conhecimento artificial de que o valor esperado ideal é . Mas seria muito fácil criar um estado para o qual sabemos teoricamente que esse seria o valor ideal e depois usar medições reais para a calibração. Um ponto-chave é que, no PEC, normalmente não se aprende um modelo de ruído completo de todo o circuito. Em vez disso, aprendem-se modelos de ruído locais para portas individuais ou camadas do circuito e usam-se esses modelos para construir a decomposição em quase-probabilidades.
Usamos essas condições para determinar e . Consideramos o ansatz
and apply it to an arbitrary single-qubit density matrix .
Lembre-se de que os canais de Pauli atuam por conjugação:
Aplicar a resulta em:
Tomando o traço, obtemos:
Cada operador de Pauli é unitário, de modo que a conjugação preserva o traço:
Therefore,
Para que o estimador do PEC seja normalizado, o mapa inverso efetivo deve preservar o traço de todas as matrizes de densidade. Ou seja, exigimos:
Isso implica a restrição de normalização:
Mas, no nosso caso, isso gera a condição:
Agora usamos as informações de calibração para relacionar o valor esperado observado ao valor ideal conhecido.
Or equivalently,
Resolvendo nossas duas condições para e , obtemos:
Esses coeficientes somam 1, mas um deles é negativo.
Podemos recuperar o valor esperado ideal modificando o circuito aleatoriamente, medindo, multiplicando o resultado por um peso com sinal e calculando a média. Em particular, nenhuma matriz de densidade é reconstruída e nenhum canal inverso é implementado fisicamente.
A etapa-chave: isto é o PEC
Para a nossa intensidade de ruído , o canal inverso pode ser escrito como:
Fatos importantes:
-
Os coeficientes somam 1
-
Um coeficiente é negativo
-
Cada termo é fisicamente implementável
-
A negatividade é transferida para o pós-processamento clássico
Formamos uma distribuição de amostragem a partir dos valores absolutos dos pesos:
(para cada um de X, Y, Z)
Peso total:
Para obter as probabilidades de amostragem, divida por W.
| Operação | Probabilidade | Sinal |
|---|---|---|
| Não fazer nada () | 1.1875 / 1.375 ≈ 0.864 | + |
| Aplicar X | 0.0625 / 1.375 ≈ 0.045 | - |
| Aplicar Y | 0.0625 / 1.375 ≈ 0.045 | - |
| Aplicar Z | 0.0625 / 1.375 ≈ 0.045 | - |
O sinal vem do coeficiente original, não da probabilidade.
Cada shot consiste nestas etapas:
-
Preparar o estado
-
Deixar o hardware aplicar o circuito ruidoso
-
Escolher aleatoriamente uma operação da tabela acima usando as probabilidades associadas
-
Apply it
-
Medir , obtendo
-
Multiplicar o resultado por
-
Registrar esse número
Agora vamos ver exemplos de vários shots.
Shot 1 (caso da identidade)
Suponha que a operação escolhida aleatoriamente seja a identidade (ou, de forma equivalente: não fazer nada). Com base nos argumentos e na tabela acima, isso acontecerá em 86,4% das vezes. Como o coeficiente de no inverso do canal de ruído é positivo, selecionamos o sinal . Nossa medição de Z poderia facilmente resultar em . Vamos supor que resulte em .
A contribuição corrigida pelo PEC deste shot seria:
Shot 2 (identidade novamente)
Suponha que obtenhamos novamente como operação aleatória (portanto o sinal do termo ainda é inicialmente ), mas desta vez nossa medição de Z resulta em . Desta vez a contribuição é:
Shot 3 (X escolhido)
Desta vez nossa operação aleatória é X. Este termo no inverso é negativo, então mantemos o sinal . Aplicamos X e depois medimos Z. Novamente, poderíamos obter qualquer um dos autovalores; digamos que obtemos . A contribuição deste termo é:
Shot 4 (Z escolhido)
A operação aleatória é Z. Isso nos dá o sinal da tabela. Suponha que medimos Z e obtemos . A contribuição é:
Shot 5 (Y escolhido)
A operação aleatória é Y. Isso nos dá o sinal da tabela. Suponha que medimos Z e obtemos . A contribuição é:
Calculando a média dos resultados
Imagine que coletamos muitos desses resultados ponderados pelo PEC:
Por construção, aplicamos a identidade em 86,4% das vezes. Aplicamos cada uma das outras portas em 4,5% das vezes. Em um fluxo de trabalho real, não conhecemos os estados subjacentes precisos, nem todo o canal de ruído. Mas conhecemos o fator de ponderação acima e a probabilidade relativa com que aplicamos cada operação. Em um fluxo de trabalho real, contamos com a matriz de densidade desconhecida para nos fornecer os resultados das medições. Verificaremos aqui que esse procedimento produziria os resultados corretos.
Queremos calcular a média de todas as medições ponderadas e com sinal, incluindo as aplicações de operadores de Pauli antes da medição. Chame o número total de shots de . Chame o conjunto de todos os shots para os quais o Pauli foi aplicado de e use para indexar esses shots. Chame o resultado da medição do shot sob a aplicação do Pauli de . Podemos escrever essa média como:
O operador de Pauli é aplicado probabilisticamente com probabilidade . No limite de um grande número de shots,
Podemos usar isso para escrever:
onde é o valor esperado de Z apenas sobre o conjunto de shots em que foi aplicado. Isso é útil porque sabemos qual deve ser cada um desses valores esperados a partir da matriz de densidade. Novamente, em um fluxo de trabalho real, isso surgiria da medição, não de uma matriz de densidade conhecida.
Verifique sua compreensão
Verifique os valores esperados acima por meio de cálculo ou raciocínio lógico.
Resposta
Y e Z seguem exatamente como acima.
Agora podemos reescrever nosso valor esperado total como:
Se conhecemos os parâmetros e do ruído das nossas portas (ou mais parâmetros, para canais de ruído mais complexos), isso é suficiente para determinar (1) o fator de peso total e (2) as probabilidades com que devemos aplicar os operadores de Pauli. O que o resultado acima mostra é que, ao fazer isso, mitigamos o ruído e recuperamos valores esperados sem viés. A média de todos esses shots convergiu para , mesmo que:
-
Shots individuais dão contribuições maiores que ±1
-
Alguns shots têm peso estatístico negativo
-
Toda operação quântica foi física
Visão geral do fluxo de trabalho do PEC
No PEC, todas as etapas no computador quântico são:
-
Aprendizado de ruído
-
Preparação de estado para o seu circuito alvo
-
Aplicar portas de Pauli probabilisticamente, como descrito acima
-
Measurement
O mapa de ruído inverso efetivo é realizado estatisticamente no pós-processamento clássico. Isso permite uma inversão mais geral de canais de ruído que, de outra forma, exigiriam etapas não físicas, como probabilidades negativas.
O preço que pagamos por isso é a variância. Cada shot tinha antes uma "magnitude" igual às magnitudes possíveis dos resultados de medição . Após o escalonamento pelo fator de peso , ele passa a ter magnitude (1,375 em nosso exemplo acima).
Essa é a origem do overhead de amostragem do PEC.
PEC integrado
Agora vamos usar o PEC como ele é integrado às primitives do IBM Quantum. É fundamental distinguir aqui entre o PEC completo em nível de porta e um modelo local de aprendizado de ruído para um PEC mais escalável, que é o usado pelas primitives do IBM Quantum. O overhead do PEC completo restringiria sua aplicação a circuitos pequenos. Isso é aceitável, mas é mais útil ter uma ferramenta que escale até um tamanho em que a computação quântica se torne valiosa para problemas do mundo real. Por esse motivo, as primitives do IBM Quantum usam um PEC por camadas, com um modelo de ruído de Pauli-Lindblad aprendido e salvaguardas agressivas de escalabilidade. Nessa implementação do PEC, o ruído é aprendido por camada de circuito repetida, e não por instância de porta, e o modelo de ruído é com Pauli twirling, local e markoviano. As portas de Clifford são absorvidas pelo modelo de ruído, enquanto as portas não Clifford dominam o custo de mitigação. O overhead de amostragem tem um limite máximo para evitar explosões exponenciais.
Vamos aplicar o PEC integrado às primitives do IBM Quantum em duas escalas: pequena (seis qubits) e média (30 qubits), para ver como o custo é mantido sob controle nesta versão do PEC. Em cada experimento de tamanho, também vamos comparar explicitamente os resultados do PEC com os sem mitigação, com o ZNE e com o valor ideal.
Começamos importando alguns pacotes necessários.
import numpy as np

from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp, Statevector

# from qiskit_aer import AerSimulator
from qiskit.transpiler import generate_preset_pass_manager

from qiskit_ibm_runtime import (
    # QiskitRuntimeService,
    Estimator,
    EstimatorOptions,
)
Escolhemos um observável para estimar. O observável abaixo é o Hamiltoniano de uma cadeia de spins do tipo Ising, com acoplamento apenas entre vizinhos mais próximos na componente da interação e um termo de um único qubit em , como se devido a um campo externo em .
Não há nenhum motivo especial para a escolha desse Hamiltoniano. Simplesmente precisamos de uma combinação de observável e circuito que seja não trivial, para que a mitigação de erros possa fazer seu trabalho. Escalonamos explicitamente o Hamiltoniano (usando os coeficientes), dividindo pelo número de qubits para que a energia permaneça na mesma ordem de grandeza à medida que aumentamos o número de qubits. Começamos com apenas seis.
# This cell builds the observable

num_qubits = 6

terms = []
coeffs = []

# XX interactions
for i in range(num_qubits - 1):
    pauli = ["I"] * num_qubits
    pauli[i] = "X"
    pauli[i + 1] = "X"
    terms.append("".join(pauli))
    coeffs.append(1.0 / (num_qubits - 1))

# Z fields
for i in range(num_qubits):
    pauli = ["I"] * num_qubits
    pauli[i] = "Z"
    terms.append("".join(pauli))
    coeffs.append(0.5 / num_qubits)

observable = SparsePauliOp(terms, coeffs)
Assim como na escolha do Hamiltoniano, o circuito de preparação de estado abaixo não foi escolhido por razões físicas. Ele foi escolhido para ter profundidade de portas de dois qubits suficiente e portas não Clifford em quantidade suficiente para que o PEC possa ser útil. Não há razão para achar que esse circuito seja uma boa aproximação do estado fundamental dessa cadeia de spins, por exemplo.
qc = QuantumCircuit(num_qubits)

# Clifford preparation
for i in range(num_qubits):
    #    qc.h(i)
    qc.ry(0.5, i)

# Clifford entanglement
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

# --- Non-Clifford "probe" ---
# Small-angle rotation (RZ(pi/8) ~= T gate)
qc.rz(3.141592653589793 / 8, 2)

# More Clifford mixing
for i in reversed(range(num_qubits - 1)):
    qc.cx(i, i + 1)

qc.barrier()

qc.draw("mpl")
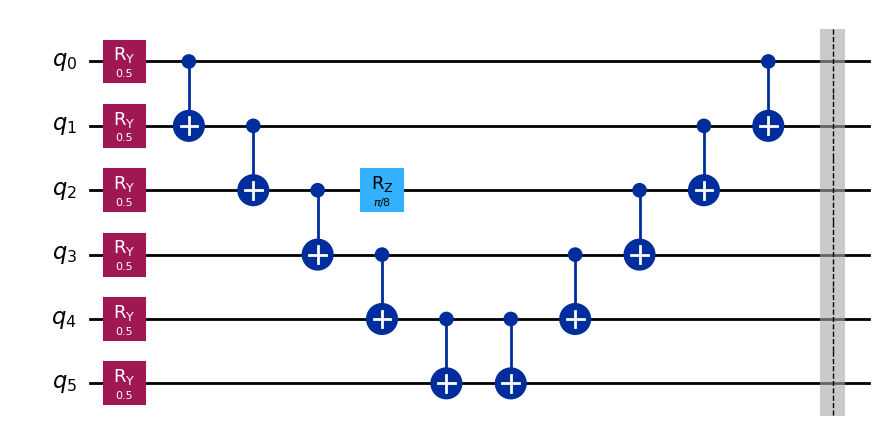
Fazemos o transpile do nosso circuito e aplicamos o layout resultante aos nossos observáveis.
# service = QiskitRuntimeService()

# backend = service.least_busy(
##    operational=True,
#   simulator=False,
#   min_num_qubits=num_qubits,
# )

pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)

qc_transpiled = pm.run(qc)

layout = qc_transpiled.layout
obs_transpiled = observable.apply_layout(layout)
Obtemos o valor esperado ideal usando o simulador Statevector.
# Compute the ideal final state
state = Statevector.from_instruction(qc)

# Compute expectation value
ideal_value = np.real(state.expectation_value(observable))

print("Ideal (noiseless) expectation value:")
print(ideal_value)
Ideal (noiseless) expectation value:
0.6651408876730361
Esperamos que outros valores ideais tenham tamanho semelhante. Agora executamos isso em um computador quântico IBM real, sem mitigação de erros.
# This took 3 sec on ibm_fez. Your actual runtime might vary.

options_none = EstimatorOptions(resilience_level=0)

estimator_none = Estimator(
    mode=backend_real,
    options=options_none,
)

job_none = estimator_none.run([(qc_transpiled, obs_transpiled)])

value_none = job_none.result()[0].data.evs
print("No mitigation:", value_none)
No mitigation: 0.569677734375
Agora aplicamos o ZNE ao mesmo problema.
# This took 17 sec on ibm_fez. Your actual runtime might vary.

options_zne = EstimatorOptions(resilience_level=2)

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
print("ZNE:", value_zne)
ZNE: 0.6573718927156127
Por fim, aplicamos o PEC.
# This took 17 sec on ibm_fez. Your actual runtime might vary.

from qiskit_ibm_runtime.options import EstimatorOptions

options = EstimatorOptions()

# One does not use ZNE with PEC
options.resilience.zne_mitigation = False
options.resilience.pec_mitigation = True
options.resilience.pec.max_overhead = 100

estimator_pec = Estimator(
    mode=backend_real,
    options=options,
)

job_pec = estimator_pec.run([(qc_transpiled, obs_transpiled)])

result = job_pec.result()
value_pec = result[0].data.evs

print("PEC:", value_pec)
PEC: 0.6666196849843695
Abaixo, plotamos nossos resultados e os comparamos.
import matplotlib.pyplot as plt

methods = ["No mitigation", "ZNE", "PEC"]
values = [value_none, value_zne, value_pec]

ideal = ideal_value  # from Aer statevector

plt.figure(figsize=(6, 4))

plt.plot(methods, values, "o", label="Measured", markersize=8)
plt.axhline(ideal, color="black", linestyle="--", label="Ideal (Aer)")

plt.ylabel("Expectation value")
plt.title("Error mitigation comparison")
plt.legend()
plt.grid(axis="y", alpha=0.3)

plt.tight_layout()
plt.show()
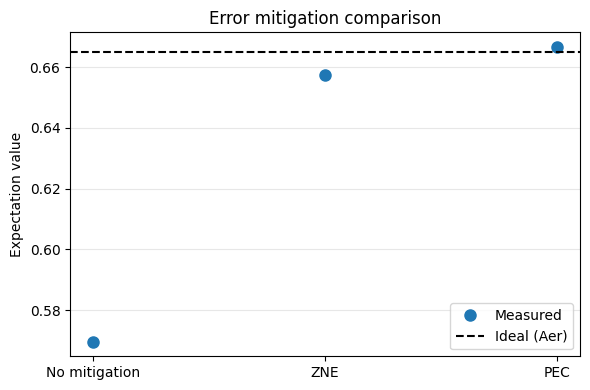
Funcionou muito bem. Nossa estimativa usando o PEC fica a apenas 0,2% do valor ideal.
Mas lembre-se de como o overhead quântico cresce exponencialmente. Impusemos um overhead máximo de max_overhead = 100. Pelo tempo e pela qualidade dos resultados, parece que talvez não tenhamos atingido esse máximo. No entanto, se aumentarmos a escala do nosso cálculo e mantivermos esse máximo, vamos atingi-lo, e nossos resultados vão sofrer.
Podemos ver o que acontece quando aumentamos nosso circuito para 30 qubits. Curiosamente, em muitos laptops o simulador Statevector começa a estourar o tempo limite por volta de 24-28 qubits. Poderíamos encontrar formas computacionais de contornar isso. Mas, em vez disso, vamos abraçar o fato de que os computadores quânticos poderão resolver alguns problemas em uma escala que os computadores clássicos não conseguem acompanhar. Esse é o ponto. O que podemos fazer, então, para validar nossos resultados de computação quântica nesses casos? Há várias respostas possíveis:
- Alguns problemas são difíceis de resolver, mas fáceis de verificar (como a fatoração em primos do algoritmo de Shor).
- Alguns problemas têm regimes de parâmetros ou variantes que reduzem a complexidade e podem ser resolvidos classicamente, ou até analiticamente, para comparar alguns pontos. Neste caso, escolhemos um Hamiltoniano intrínseco (dividimos pelo número de qubits). O valor esperado ideal deve ser bastante estável. Vamos ver como o valor esperado ideal varia com o número de qubits e se conseguimos fazer previsões clássicas sobre o valor com 30 qubits.
import numpy as np
import matplotlib.pyplot as plt

from qiskit import QuantumCircuit
from qiskit.quantum_info import Statevector, SparsePauliOp

num_qubits_max = 24

qubits = [4, 8, 12, 16, 20, 24]
exp_vals = []
for num_qubits in qubits:
    qc = QuantumCircuit(num_qubits)

    for i in range(num_qubits):
        qc.ry(0.7, i)
    for i in range(num_qubits - 1):
        qc.cx(i, i + 1)
    for i in range(num_qubits):
        qc.rz(np.pi / 5, i)
    for i in reversed(range(num_qubits - 1)):
        qc.cx(i, i + 1)
    qc.barrier()

    terms = []
    coeffs = []

    # XX interactions
    for i in range(num_qubits - 1):
        pauli = ["I"] * num_qubits
        pauli[i] = "X"
        pauli[i + 1] = "X"
        terms.append("".join(pauli))
        coeffs.append(1.0 / (num_qubits - 1))

    # Z fields
    for i in range(num_qubits):
        pauli = ["I"] * num_qubits
        pauli[i] = "Z"
        terms.append("".join(pauli))
        coeffs.append(0.5 / num_qubits)

    observable = SparsePauliOp(terms, coeffs)

    # Compute the ideal final state
    state = Statevector.from_instruction(qc)

    # Compute expectation value
    ideal_value = np.real(state.expectation_value(observable))
    exp_vals.append(ideal_value)

print(exp_vals)

plt.figure()
plt.plot(qubits, exp_vals, "o", label="Statevector")
plt.xlabel("Number of qubits")
plt.ylabel(r"$\langle O^{\otimes N} \rangle$")
plt.legend()
plt.show()
[np.float64(0.7181764372838925), np.float64(0.7181764372838922), np.float64(0.7181764372838931), np.float64(0.7181764372838906), np.float64(0.7181764372838907), np.float64(0.7181764372838709)]
De fato, vemos que selecionamos um Hamiltoniano e um estado que não mudam com o número de qubits. Isso é um uso muito fraco para uma aplicação de pesquisa da computação quântica, mas excelente para fazer benchmarking de técnicas de mitigação de erros. Podemos usar com confiança esse valor esperado fixo como resultado ideal, mesmo ao aumentar o número de qubits para testar a mitigação de erros.
num_qubits = 30

qc = QuantumCircuit(num_qubits)

# Clifford preparation
for i in range(num_qubits):
    #    qc.h(i)
    qc.ry(0.7, i)

# Clifford entanglement
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

# --- Non-Clifford "probe" ---
# Small-angle rotation (RZ(pi/8) ~= T gate)

for i in range(num_qubits):
    qc.rz(np.pi / 5, i)

# More Clifford mixing
for i in reversed(range(num_qubits - 1)):
    qc.cx(i, i + 1)

qc.barrier()

qc.draw("mpl")

# This cell builds the observable

terms = []
coeffs = []

# XX interactions
for i in range(num_qubits - 1):
    pauli = ["I"] * num_qubits
    pauli[i] = "X"
    pauli[i + 1] = "X"
    terms.append("".join(pauli))
    coeffs.append(1.0 / (num_qubits - 1))

# Z fields
for i in range(num_qubits):
    pauli = ["I"] * num_qubits
    pauli[i] = "Z"
    terms.append("".join(pauli))
    coeffs.append(0.5 / num_qubits)

observable = SparsePauliOp(terms, coeffs)

# service = QiskitRuntimeService()

# backend = service.least_busy(
##    operational=True,
#   simulator=False,
#   min_num_qubits=num_qubits,
# )

pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)

qc_transpiled = pm.run(qc)

layout = qc_transpiled.layout
obs_transpiled = observable.apply_layout(layout)

# Compute the ideal final state
# This might time out above about 26 qubits. The Hamiltonian has been "normalized".
# The same expectation value calculated on the smaller example above is still valid.
# state = Statevector.from_instruction(qc)

# Compute expectation value
# ideal_value = np.real(state.expectation_value(observable))

print("Ideal (noiseless) expectation value:")
print(ideal_value)
Ideal (noiseless) expectation value:
0.7181764372838709
# This took 5 sec on ibm_fez. Your actual runtime might vary.

options_none = EstimatorOptions(resilience_level=0)

estimator_none = Estimator(
    mode=backend_real,
    options=options_none,
)

job_none = estimator_none.run([(qc_transpiled, obs_transpiled)])

value_none = job_none.result()[0].data.evs
print("No mitigation:", value_none)
No mitigation: 0.5869884271731322
Agora executamos esse circuito maior com o ZNE.
# This took 17 sec on ibm_fez. Your actual runtime might vary.

options_zne = EstimatorOptions(resilience_level=2)

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
print("ZNE:", value_zne)
ZNE: 0.7096089981595511
Por fim, executamos o exemplo de 30 qubits com o PEC.
# This took 4 min 57 sec on ibm_fez. Your actual runtime might vary.

options = EstimatorOptions()

# One does not use ZNE with PEC
options.resilience.zne_mitigation = False
options.resilience.pec_mitigation = True
options.resilience.pec.max_overhead = 100

estimator_pec = Estimator(
    mode=backend_real,
    options=options,
)

job_pec = estimator_pec.run([(qc_transpiled, obs_transpiled)])

value_pec = job_pec.result()[0].data.evs
print("PEC:", value_pec)
PEC: 0.3481257778627795
job_id_none = job_none.job_id()
job_id_zne = job_zne.job_id()
job_id_pec = job_pec.job_id()
print("job number with no mitigation:  ", job_id_none)
print("job number with ZNE  ", job_id_zne)
print("job number with PEC  ", job_id_pec)
job number with no mitigation:   d7uc79back5s73be1cv0
job number with ZNE   d7uc7c3ack5s73be1d40
job number with PEC   d7uc9k4inasc738smhu0
import matplotlib.pyplot as plt

methods = ["No mitigation", "ZNE", "PEC"]
values = [value_none, value_zne, value_pec]

ideal = ideal_value  # from Aer statevector

plt.figure(figsize=(6, 4))

plt.plot(methods, values, "o", label="Measured", markersize=8)
plt.axhline(ideal, color="black", linestyle="--", label="Ideal (Aer)")

plt.ylabel("Expectation value")
plt.title("Error mitigation comparison")
plt.legend()
plt.grid(axis="y", alpha=0.3)

plt.tight_layout()
plt.show()
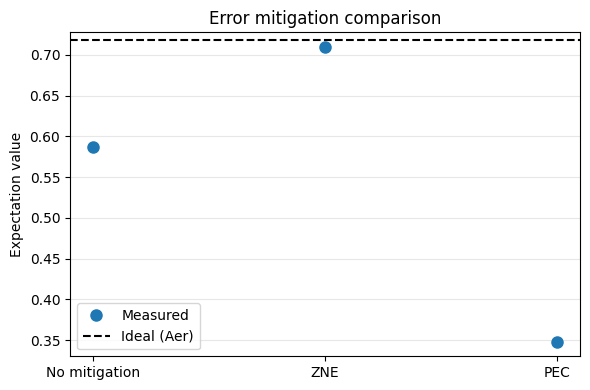
Não apenas o PEC levou muito mais tempo que as outras opções, como claramente atingimos o limite máximo de overhead. Os resultados do PEC pagaram o preço do overhead, mas o limite de overhead impediu um cancelamento suficientemente preciso do modelo de ruído aprendido. Isso é crítico. Com seis qubits, conseguimos aproveitar o PEC e obter resultados melhores com apenas um aumento modesto no overhead quântico (cerca de um fator de 5). Com 30 qubits, pagamos um preço muito maior (cerca de 60 vezes maior) e os resultados foram até piores que a estimativa sem mitigação. Isso não quer dizer que o PEC nunca possa funcionar com 30 qubits; isso pode depender do circuito. A mensagem é simplesmente que o crescimento exponencial do overhead quântico dificulta a execução em circuitos grandes.
Principais conclusões:
-
A mitigação de medição frequentemente ajuda e geralmente tem baixo overhead: ela remove um viés que não escala com a profundidade do circuito e se combina bem com quase tudo.
-
Algumas técnicas não podem ser combinadas. Mesmo quando podem, certifique-se de combiná-las de forma consistente, para que uma não desfaça a outra. Um bom exemplo é garantir que o twirling esteja ativado durante a calibração do M3, caso esses métodos sejam combinados.
-
PEC e ZNE devem ser vistos como alternativas um ao outro. Eles resolvem o mesmo problema com compromissos opostos:
-
PEC: fornece valores esperados sem viés ao custo de variância exponencial.
-
O ZNE geralmente deixa um viés residual que depende do modelo de extrapolação, mas com custo moderado.
-
-
O DD pode ajudar com longos períodos ociosos, mas remodela o modelo de ruído e pode invalidar as hipóteses de extrapolação ou inversão.
-
O Pauli twirling não reduz o ruído. Ele o remodela e frequentemente permite que outras técnicas funcionem melhor (ZNE e PEC).