Detecção de erros de baixo overhead com códigos espaço-temporais
Estimativa de uso: 4 minutos em um processador Heron (ibm_kingston ou equivalente) (NOTA: Esta é apenas uma estimativa. O seu tempo de execução pode variar.)
Resultados de aprendizagem
-
Como checagens de Pauli espaço-temporais detectam erros lógicos em circuitos Clifford, e como a pós-seleção em suas síndromes aumenta a fidelidade de uma distribuição amostrada.
-
Como usar o pacote
qiskit-paulicepara encontrar e inserir automaticamente checagens eficientes para o hardware comget_check_qubits,NoiseModeleadd_pauli_checks. -
Como estimar a fidelidade de um estado estabilizador amostrando seus estabilizadores e fazendo pós-seleção em síndromes de checagem.
-
Como executar o fluxo de trabalho completo de detecção de erros em hardware IBM Quantum® e comparar fidelidades com ruído e pós-selecionadas.
Pré-requisitos
-
Fundamentos de hardware para computação quântica em escala utilitária.
-
O formalismo de Clifford e estabilizadores, incluindo como um grupo estabilizador descreve um estado estabilizador puro.
Histórico
Low-overhead error detection with spacetime codes [1] de Simon Martiel e Ali Javadi-Abhari apresenta um método para detectar erros lógicos em circuitos dominados por Clifford que fica entre a correção de erros completa e a mitigação de erros mais leve. A ideia se baseia nas coherent Pauli checks (CPC) de Single-shot error mitigation by coherent Pauli checks [2] de van den Berg e outros. Em ambas as abordagens, um circuito "payload" Clifford é emaranhado com qubits ancilla para verificar determinados invariantes. Medir as ancillas produz uma síndrome que informa se um erro foi detectado durante a execução. Manter apenas as amostras sem erro detectado melhora a fidelidade da distribuição amostrada, ao custo de uma taxa de pós-seleção reduzida.
A principal diferença entre coherent Pauli checks e spacetime checks são os operadores que medem. As coherent Pauli checks medem operadores de alto peso e localizados no tempo. Em topologias de Qubit com conectividade limitada, como a heavy hex, essas verificações precisam de muitas portas SWAP e frequentemente tornam o circuito profundo demais para ser executado na prática. Implementar as verificações como spacetime codes, em vez disso, distribui cada verificação pelo circuito payload no espaço e no tempo. Isso gera uma codificação eficiente em hardware que continua eficaz na detecção de erros lógicos, mantendo baixo o overhead de qubits e profundidade.
O que o pacote qiskit-paulice faz
O pacote qiskit-paulice automatiza a construção dessas verificações para que você não precise construí-las manualmente. Seu papel principal é encontrar e inserir spacetime Pauli checks válidas nos locais de um circuito que maximizam a detecção de erros e minimizam o overhead de qubits. Uma verificação é válida quando seus operadores mantêm inalterada a ação lógica do circuito payload, de baixo peso quando usa poucas portas de emaranhamento, e eficaz quando detecta uma grande parte dos erros, em relação ao ruído que a própria verificação introduz. O pacote pontua as verificações candidatas em relação a um modelo de ruído e confirma as melhores no circuito. Este tutorial usa três métodos de API:
-
get_check_qubitsinspeciona um coupling map de um backend e retorna pares de qubits alvo e ancilla. Uma verificação emtarget_qubits[i]usaancilla_qubits[i]. -
NoiseModel.from_backendconstrói um modelo de ruído aproximado a partir de dados de benchmark do backend. O modelo pontua as verificações candidatas, portanto não é necessário um modelo de ruído exato e aprendido. Para um modelo Pauli-Lindblad aprendido, vejaNoiseModel.from_pauli_lindblad_maps. -
add_pauli_checksencontra e insere verificações em um circuito. Ele retorna uma sequência de objetosCheckedCircuitcom um número crescente de verificações, e cada objeto fornece umget_postselection_methodque mapeia uma bitstring medida para um vetor de síndrome. O argumentocostseleciona a função que pontua uma verificação (gamma, o overhead de amostragem do canal de ruído inverso pós-selecionado, ouLER, a taxa de erro lógico). O argumentomethodseleciona a estratégia de busca (windowed,genetic, ouwindowed_genetic). Este tutorial usacost="gamma"emethod="windowed", que juntos oferecem uma seleção de verificações determinística e reproduzível.
Estimar a fidelidade a partir de amostragem de estabilizadores
Para medir o quão bem a detecção de erros funciona, você pode estimar a fidelidade do estado estabilizador que o circuito idealmente prepara em relação ao estado ruidoso que o hardware realmente produz. O projetor sobre um estado estabilizador puro é igual à média uniforme sobre os elementos do seu grupo estabilizador :
Substituindo isso na fidelidade, obtém-se a fidelidade de como o valor esperado médio de todo estabilizador em relação a :
Para problemas maiores, enumerar todos os estabilizadores é inviável, então você pode estimar a fidelidade a partir de uma amostra aleatória. Extrair estabilizadores uniformemente ao acaso de fornece uma estimativa não enviesada:
Como um circuito Clifford prepara um estado estabilizador, você pode estimar sua fidelidade diretamente a partir de valores esperados amostrados de seus estabilizadores. Este tutorial primeiro percorre o fluxo de trabalho em um simulador com um circuito pequeno, depois executa o mesmo fluxo de trabalho em hardware com um circuito maior e mais profundo. À medida que os circuitos incluem mais operações não Clifford, o número de verificações válidas diminui rapidamente, então o método funciona melhor para circuitos dominados por Clifford.
Requisitos
Antes de iniciar este tutorial, certifique-se de ter instalado o seguinte:
-
Qiskit SDK v2.0 ou posterior, com suporte a visualização
-
Qiskit Runtime v0.40 ou posterior (
pip install qiskit-ibm-runtime) -
Qiskit Aer v0.17 ou posterior (
pip install qiskit-aer) -
Qiskit Paulice (
pip install qiskit-paulice) -
tqdm (
pip install tqdm)
Configuração
Importe as bibliotecas necessárias e defina as funções auxiliares que não estão disponíveis como importações. A função random_clifford_circuit constrói um payload Clifford aleatório em brickwork, find_check_layout busca no coupling map de um backend um caminho de qubits com baixo erro e muitas ancillas disponíveis, learned_noise_model transforma a saída do NoiseLearner em um modelo de ruído do qiskit-paulice, append_basis_rotation rotaciona um circuito para que um estabilizador seja medido na base computacional, expectation calcula um valor esperado de estabilizador a partir de contagens amostradas, e cum_mean_sem acompanha a estimativa de fidelidade em execução.
# Added by doQumentation — required packages for this notebook
!pip install -q matplotlib numpy qiskit qiskit-aer qiskit-ibm-runtime qiskit-paulice tqdm
# Standard library imports
import random
import time

# External libraries
import matplotlib.pyplot as plt
import numpy as np
from tqdm import tqdm

# Qiskit
from qiskit import QuantumCircuit
from qiskit.quantum_info import Clifford, Pauli, PauliLindbladMap, PauliList
from qiskit.result import sampled_expectation_value
from qiskit.transpiler import generate_preset_pass_manager
from qiskit.visualization import plot_coupling_map

# Qiskit Aer
from qiskit_aer import AerSimulator
from qiskit_aer.noise import NoiseModel as AerNoiseModel
from qiskit_aer.noise import ReadoutError, depolarizing_error

# Qiskit IBM Runtime
from qiskit_ibm_runtime import NoiseLearner, QiskitRuntimeService
from qiskit_ibm_runtime import SamplerV2 as Sampler

# Qiskit Paulice
from qiskit_paulice import add_pauli_checks
from qiskit_paulice.layout import get_check_qubits
from qiskit_paulice.noise_models import NoiseModel
def random_clifford_circuit(
    num_qubits: int, depth: int, rng: np.random.Generator
) -> QuantumCircuit:
    """Brickwork random Clifford on `num_qubits`, with `depth` CZ layers."""
    qc = QuantumCircuit(num_qubits)
    qc.h(range(num_qubits))
    for d in range(depth):
        for i in range(d % 2, num_qubits - 1, 2):
            qc.cz(i, i + 1)
        for q in range(num_qubits):
            if rng.integers(0, 2):
                qc.sx(q)
            if rng.integers(0, 2):
                qc.s(q)
            if rng.integers(0, 2):
                qc.sx(q)
    return qc

def find_check_layout(
    backend,
    num_qubits: int,
    rng: np.random.Generator,
    num_trials: int = 200,
    max_gate_error: float = 0.03,
    max_readout_error: float = 0.2,
) -> list[int]:
    """Find a low-error path of `num_qubits` qubits with many available ancillas.

    Builds random self-avoiding walks on the coupling map, excluding the qubits
    and two-qubit gates whose reported errors exceed the thresholds, and keeps
    the path that offers the most target and ancilla pairs. Ties are broken by
    the lower average two-qubit gate error along the path.
    """
    target = backend.target
    gate_2q = next(
        name for name in ("cz", "ecr", "cx") if name in target.operation_names
    )

    # Collect per-edge gate errors and per-qubit readout errors
    edge_error = {}
    for qubits, props in target[gate_2q].items():
        edge = tuple(sorted(qubits))
        if props is not None and props.error is not None:
            edge_error[edge] = min(edge_error.get(edge, 1.0), props.error)
    readout_error = {
        qubit: target["measure"][(qubit,)].error
        for (qubit,) in target["measure"]
    }

    # Keep only the edges whose gate and readout errors are acceptable
    adjacency = {}
    for (q1, q2), error in edge_error.items():
        if (
            error <= max_gate_error
            and readout_error.get(q1, 1.0) <= max_readout_error
            and readout_error.get(q2, 1.0) <= max_readout_error
        ):
            adjacency.setdefault(q1, set()).add(q2)
            adjacency.setdefault(q2, set()).add(q1)

    # Random self-avoiding walks; keep the path with the most check pairs
    starts = sorted(adjacency)
    best_path = None
    best_score = (-1, float("inf"))
    for _ in range(num_trials):
        path = [starts[rng.integers(len(starts))]]
        while len(path) < num_qubits:
            options = sorted(adjacency[path[-1]] - set(path))
            if not options:
                break
            path.append(options[rng.integers(len(options))])
        if len(path) < num_qubits:
            continue
        num_pairs = len(get_check_qubits(backend.coupling_map, path)[0])
        mean_error = float(
            np.mean(
                [edge_error[tuple(sorted(e))] for e in zip(path, path[1:])]
            )
        )
        if num_pairs > best_score[0] or (
            num_pairs == best_score[0] and mean_error < best_score[1]
        ):
            best_path, best_score = path, (num_pairs, mean_error)

    if best_path is None:
        raise RuntimeError(
            "No connected low-error path found. Relax the error thresholds."
        )
    return best_path

def learned_noise_model(layer_errors, layout: list[int]) -> NoiseModel:
    """Build a `NoiseModel` from `NoiseLearner` results.

    `NoiseLearner` reports one `PauliLindbladError` per entangling layer, whose
    generators are indexed against that layer's own physical qubits, while
    `NoiseModel.from_pauli_lindblad_maps` expects `PauliLindbladMap`s indexed the
    way `NoiseModel.from_backend` indexes them: by position in `layout`. This
    translates between the two and drops generators that fall outside `layout`.
    """
    phys_to_virt = {phys: virt for virt, phys in enumerate(layout)}
    maps = []
    for layer in layer_errors:
        if layer.error is None:
            continue
        terms = []
        for pauli, rate in zip(
            layer.error.generators, layer.error.rates, strict=True
        ):
            label, indices = [], []
            for local, phys in enumerate(layer.qubits):
                x, z = bool(pauli.x[local]), bool(pauli.z[local])
                if not (x or z):
                    continue
                if phys not in phys_to_virt:
                    break  # generator reaches outside the layout, so skip it
                label.append("Y" if x and z else "X" if x else "Z")
                indices.append(phys_to_virt[phys])
            else:
                if label:
                    terms.append(
                        ("".join(label), tuple(indices), float(rate))
                    )
        # Each map needs a 2-qubit generator to define an entangling layer
        if any(len(t[1]) == 2 for t in terms):
            maps.append(
                PauliLindbladMap.from_sparse_list(
                    terms, num_qubits=len(layout)
                )
            )
    if not maps:
        raise RuntimeError(
            "No usable layer errors. Check that the learner ran on this layout."
        )
    return NoiseModel.from_pauli_lindblad_maps(maps)

def append_basis_rotation(
    circuit: QuantumCircuit, pauli: Pauli
) -> QuantumCircuit:
    """Strip measurements, append basis rotations for `pauli`, and re-measure."""
    out = circuit.remove_final_measurements(inplace=False)
    for q in range(pauli.num_qubits):
        if pauli.x[q]:
            if pauli.z[q]:
                out.sdg(q)
            out.h(q)
    out.measure_all()
    return out

def expectation(counts: dict, pauli: Pauli) -> float:
    """Expectation value of `pauli` from counts measured in the Z basis.

    Pads with identity on any qubits beyond the support of `pauli`, such as the
    check ancillas that appear in the postselected counts.
    """
    if not counts:
        return float("nan")
    n = pauli.num_qubits
    sign = -1 if int(pauli.phase) % 4 == 2 else 1
    total = len(next(iter(counts)))
    label = "".join(
        "Z" if q < n and (pauli.x[q] or pauli.z[q]) else "I"
        for q in range(total - 1, -1, -1)
    )
    return sign * sampled_expectation_value(counts, label)

def cum_mean_sem(values: np.ndarray):
    """Cumulative mean and standard error of the mean, ignoring NaNs."""
    valid = ~np.isnan(values)
    total = np.cumsum(np.where(valid, values, 0.0))
    total_sq = np.cumsum(np.where(valid, values**2, 0.0))
    count = np.maximum(np.cumsum(valid).astype(float), 1)
    mean = total / count
    sem = np.sqrt(np.maximum(total_sq / count - mean**2, 0) / count)
    return np.where(np.cumsum(valid) > 0, mean, np.nan), sem
Exemplo de simulador em pequena escala
Esta seção percorre o fluxo de trabalho completo em um simulador ruidoso. Ela usa dados de benchmark do backend para escolher um layout de qubits e um modelo de ruído, encontra verificações automaticamente e usa pós-seleção na distribuição amostrada para mostrar a melhoria de fidelidade.
Passo 1: Mapear entradas clássicas para um problema quântico
O circuito payload é um circuito Clifford aleatório em brickwork unidimensional e raso. Como o circuito é Clifford, ele prepara um estado estabilizador cuja fidelidade você pode estimar diretamente a partir de valores esperados amostrados dos estabilizadores. Comece com um circuito raso para que as verificações sejam fáceis de visualizar no próximo passo.
num_qubits = 12
depth = 4
seed = 1764
rng = np.random.default_rng(seed)
np.random.seed(seed)

circuit = random_clifford_circuit(num_qubits, depth, rng)
circuit.measure_all()
circuit.draw("mpl", fold=-1, scale=0.6)

Passo 2: Otimizar para a execução em hardware quântico
Mapear o circuito para o hardware define o layout físico de qubits, o modelo de ruído que pontua as verificações candidatas e as próprias verificações.
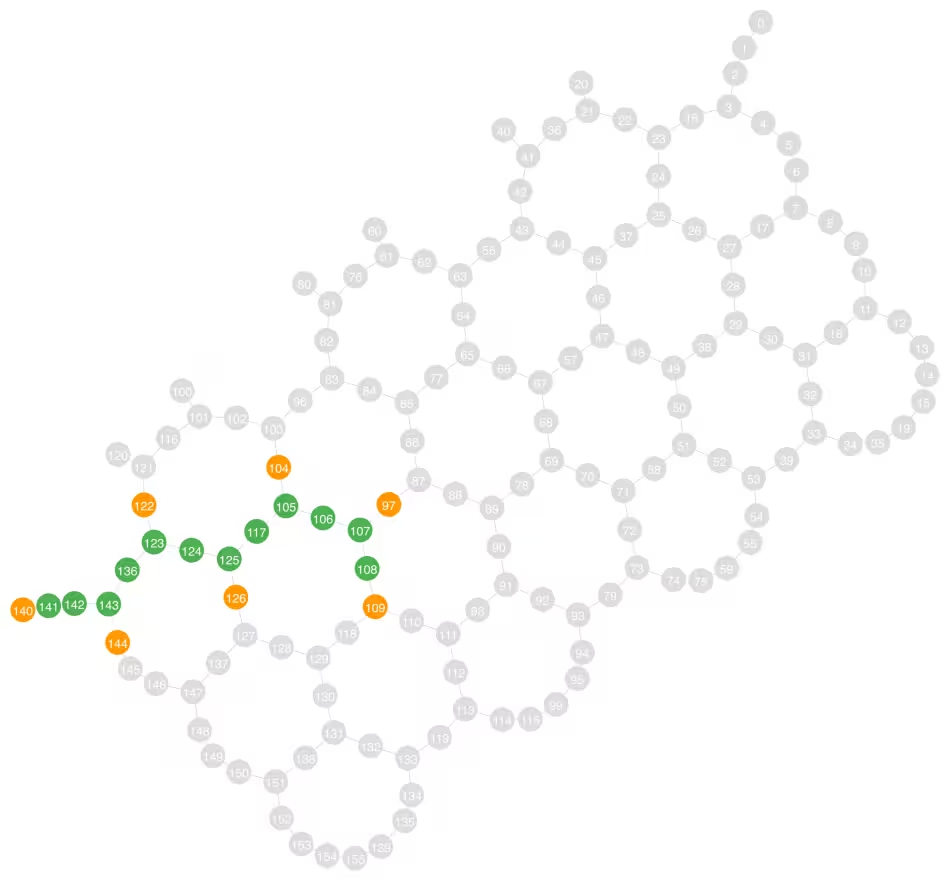
Primeiro, selecione um backend e busque em seu coupling map um layout de qubits unidimensional com o auxiliar find_check_layout definido na seção Configuração. O auxiliar constrói caminhos aleatórios autoevitantes que evitam as portas e leituras com maior erro, e mantém o caminho que oferece o maior número de pares de alvo e ancilla. Como a busca lê a conectividade e os dados de erro do próprio backend, o mesmo código é executado em qualquer QPU da IBM Quantum. A função get_check_qubits então retorna os pares de alvo e ancilla, onde uma verificação em target_qubits[i] usa ancilla_qubits[i].
No grafo de conectividade a seguir, os qubits verdes são qubits payload e os qubits laranja são as ancillas que implementam as verificações. Qubits com uma ancilla adjacente são usados como qubits alvo para verificações.
service = QiskitRuntimeService()
backend = service.least_busy(operational=True, simulator=False)

print(f"Backend: {backend.name}")

# Search for a low-error path, then pair each target qubit with a neighboring ancilla
layout = find_check_layout(backend, num_qubits, rng)
target_qubits, ancilla_qubits = get_check_qubits(backend, layout)
num_checks = len(target_qubits)

print(f"Target qubits:  {target_qubits}")
print(f"Ancilla qubits: {ancilla_qubits}")
plot_coupling_map(
    num_qubits=backend.num_qubits,
    qubit_coordinates=getattr(
        backend.configuration(), "qubit_coordinates", None
    ),
    coupling_map=backend.configuration().coupling_map,
    figsize=(12, 12),
    qubit_color=[
        "#4CAF50"
        if i in set(layout)
        else "#FF9800"
        if i in set(ancilla_qubits)
        else "#DDDDDD"
        for i in backend.coupling_map.graph.node_indices()
    ],
    qubit_size=220,
    line_width=2,
    font_size=90,
)
Backend: ibm_boston
Target qubits:  [105, 107, 108, 123, 125, 141, 143]
Ancilla qubits: [104, 97, 109, 122, 126, 140, 144]
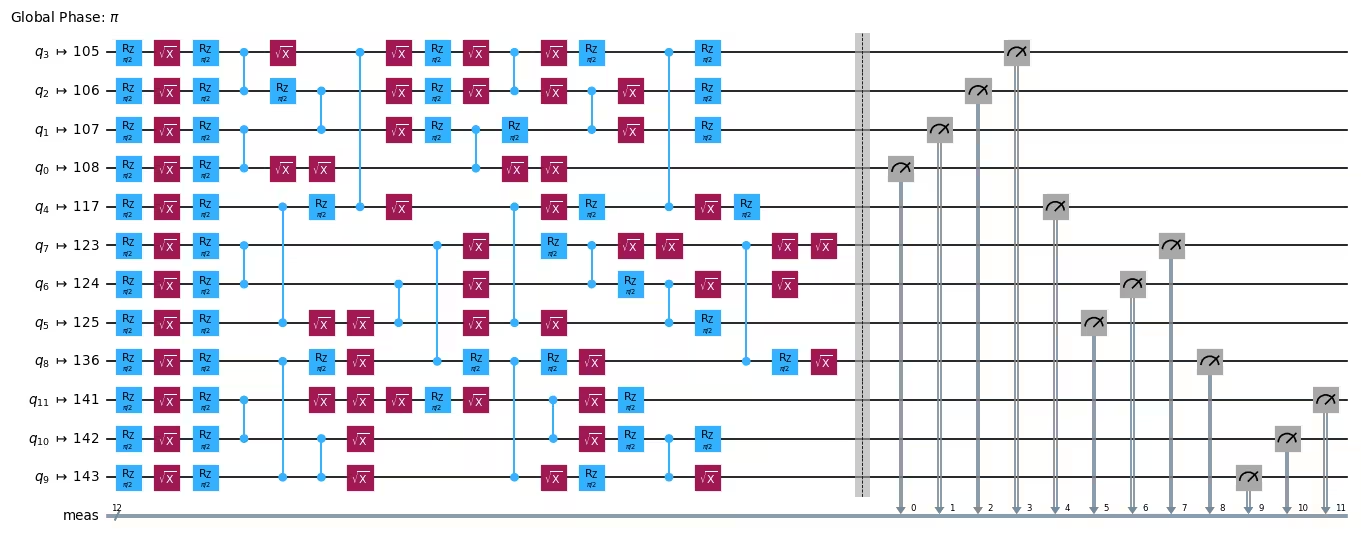
Com o backend e o layout escolhidos, transpile o payload em um circuito de arquitetura de conjunto de instruções (ISA). Só é necessário definir o layout e traduzir as portas para o conjunto de portas nativo do backend.
pm = generate_preset_pass_manager(
    optimization_level=0, backend=backend, initial_layout=layout
)
circuit_isa = pm.run(circuit)
circuit_isa.draw("mpl", fold=-1, scale=0.6)
Em seguida, modele como o ruído de portas e leitura no backend afeta a execução. O modelo de ruído determina onde no circuito uma verificação captura mais erro. Um modelo mais preciso melhora a detecção, mas normalmente não é necessário aprendê-lo amostrando a QPU. O modelo a seguir infere um canal de despolarização uniforme para ruído de portas e leitura a partir de dados de benchmark do qiskit-ibm-runtime.
noise_model = NoiseModel.from_backend(
    backend, layout, uniform_gate_noise=True
)
print(noise_model)
NoiseModel(gate_noise=0.001079865281450939, readout_noise=0.006001790364583333, idling_noise=None)
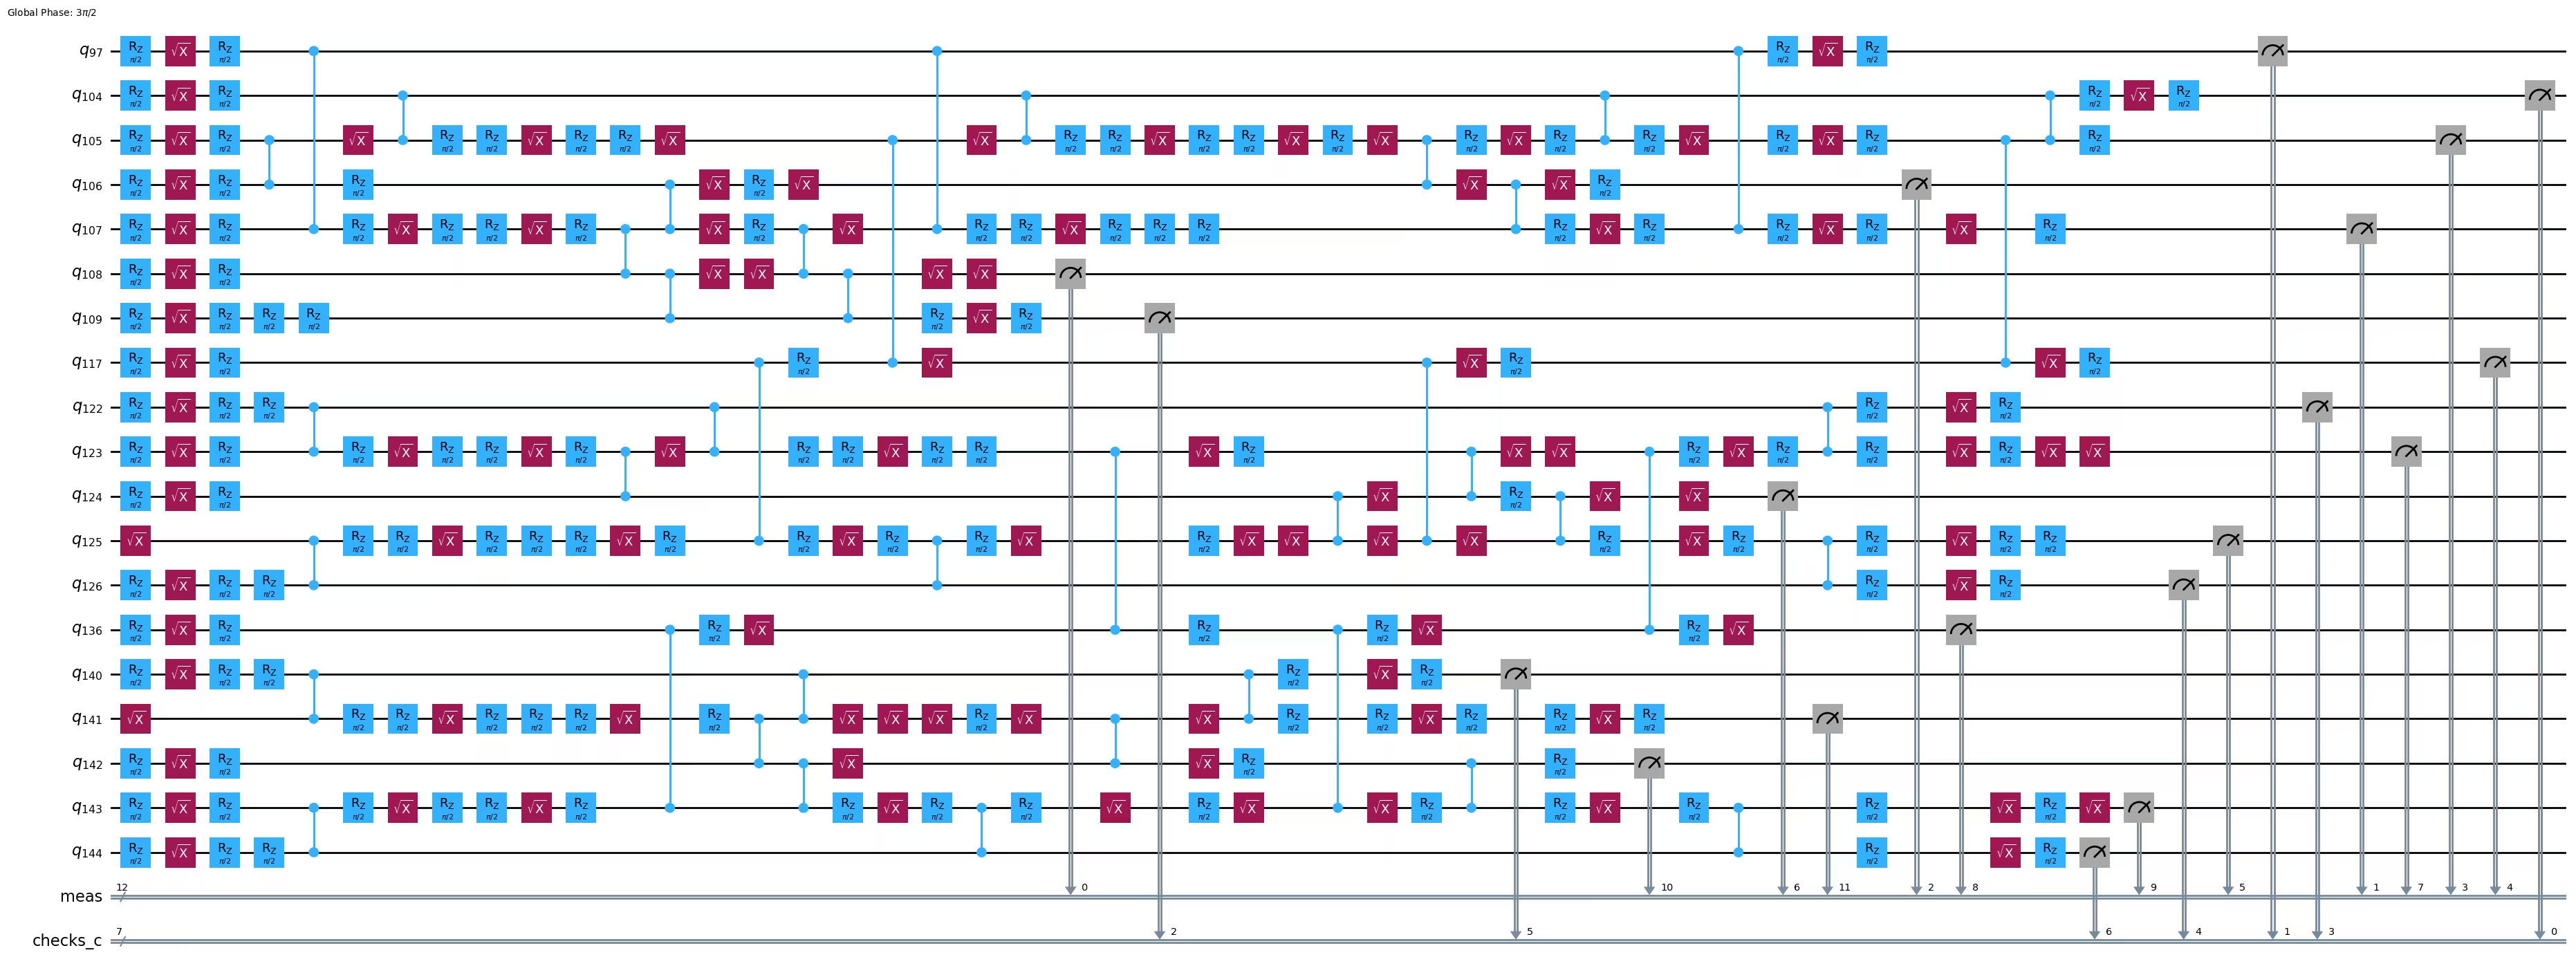
Agora adicione verificações ao circuito. A função add_pauli_checks recebe o payload Clifford, a lista de qubits alvo e o modelo de ruído. O argumento ancilla_qubits informa à função qual ancilla física combinar com cada alvo. As verificações são adicionadas na ordem em que os qubits alvo aparecem, então o layout final do circuito verificado é layout + ancilla_qubits. Para executar um circuito de saída com menos (i) verificações, o layout final é layout + ancilla_qubits[:i].
A saída de add_pauli_checks é uma sequência de circuitos com um número crescente de verificações, desde nenhuma verificação até uma verificação em cada qubit alvo. A visualização confirma que as verificações usam os pares de alvo e ancilla especificados. Para detalhes sobre como encontrar boas verificações, veja as Seções II a IV das informações complementares na referência [1].
checked = add_pauli_checks(
    circuit_isa,
    target_qubits,
    noise_model,
    ancilla_qubits=ancilla_qubits,
    cost="gamma",
    method="windowed",
    seed=seed,
)

print(f"Physical layout of payload and ancillas: {layout + ancilla_qubits}")
print("Checked circuit:")
checked[-1].circuit.draw("mpl", fold=-1, idle_wires=False)
Physical layout of payload and ancillas: [108, 107, 106, 105, 117, 125, 124, 123, 136, 143, 142, 141, 104, 97, 109, 122, 126, 140, 144]
Checked circuit:
Passo 3: Executar usando os primitivos do Qiskit
Para tornar visível o efeito do ruído de portas, aumente a profundidade do payload e amostre um subconjunto de seus estabilizadores. Cada estabilizador geralmente não comuta qubit a qubit com os outros, então um único conjunto de verificações não é válido para dois estabilizadores diferentes. Em vez de agrupar estabilizadores em conjuntos que comutam, encontre um bom conjunto de verificações para cada estabilizador de forma independente. Amostrar estabilizadores uniformemente ao acaso fornece uma estimativa de fidelidade não enviesada.
Construa o circuito mais profundo e extraia uma amostra aleatória de seus estabilizadores.
depth = 24
num_stabilizers = 20
num_shots = 1_000

circuit = random_clifford_circuit(num_qubits, depth, rng)

# Build the full stabilizer group, then sample from it uniformly at random
circ_no_meas = circuit.remove_final_measurements(inplace=False)
stabilizer_group = PauliList([Pauli("I" * num_qubits)])
for generator in (
    Pauli(label) for label in Clifford(circ_no_meas).to_labels(mode="S")
):
    stabilizer_group = stabilizer_group + stabilizer_group.compose(generator)

keep = np.where(
    stabilizer_group.x.any(axis=1) | stabilizer_group.z.any(axis=1)
)[0]
chosen = np.random.default_rng(seed).choice(
    keep, size=min(num_stabilizers, len(keep)), replace=False
)
stabilizers = [stabilizer_group[int(i)] for i in chosen]

two_qubit_depth = circuit.depth(lambda x: x.operation.num_qubits == 2)
print(
    f"Sampled {len(stabilizers)} stabilizers of a {circuit.num_qubits}-qubit "
    f"circuit with two-qubit depth {two_qubit_depth}: "
    f"{{{stabilizers[0]}, {stabilizers[1]}, ...}}"
)
Sampled 20 stabilizers of a 12-qubit circuit with two-qubit depth 24: {ZXIIXZYYXIZZ, XXXYIIZYXIII, ...}
Para cada estabilizador amostrado, rotacione o circuito para que o estabilizador seja medido na base computacional, transpile-o para o backend e encontre um bom conjunto de verificações. Os pares de alvo e ancilla são embaralhados juntos para cada estabilizador, de modo que cada alvo mantenha sua ancilla. Lembre-se de que as verificações são confirmadas sequencialmente na ordem em que os qubits alvo são fornecidos, e uma verificação confirmada não é alterada à medida que mais verificações são adicionadas.
noisy_circuits = []
checked_circuits = []
depths_2q = []
t0 = time.time()
for i, pauli in enumerate(tqdm(stabilizers)):
    noisy_circuits.append(pm.run(append_basis_rotation(circuit, pauli)))
    # Shuffle target and ancilla pairs together so each target keeps its ancilla
    targets, ancillas = zip(
        *random.sample(
            list(zip(target_qubits, ancilla_qubits, strict=True)),
            k=len(target_qubits),
        ),
        strict=True,
    )
    checked_circuits.append(
        add_pauli_checks(
            noisy_circuits[-1],
            list(targets),
            noise_model,
            ancilla_qubits=list(ancillas),
            cost="gamma",
            method="windowed",
            seed=seed + 1 + i,
        )
    )
    depths_2q.append(
        checked_circuits[-1][-1].circuit.depth(lambda x: len(x.qubits) == 2)
    )

print(
    f"Added {num_checks} checks to {len(stabilizers)} circuits "
    f"in {(time.time() - t0):.0f}s."
)
print(
    f"On average, two-qubit depth increased from "
    f"{circuit.depth(lambda x: len(x.qubits) == 2)} to {int(np.mean(depths_2q))} "
    f"when adding {num_checks} checks."
)
100%|██████████| 20/20 [00:15<00:00, 1.29it/s]
Added 7 checks to 20 circuits in 15s.
On average, two-qubit depth increased from 24 to 33 when adding 7 checks.
Amostre o payload puro e os circuitos verificados com o Qiskit Aer. O simulador usa o mesmo modelo de despolarização que pontuou as verificações, de modo que o ruído que as verificações visam é o ruído que o simulador aplica.
aer_nm = AerNoiseModel()
aer_nm.add_all_qubit_quantum_error(
    depolarizing_error(noise_model.gate_noise, 2), ["cz"]
)
p = noise_model.readout_noise
aer_nm.add_all_qubit_readout_error(ReadoutError([[1 - p, p], [p, 1 - p]]))
noisy_sim = AerSimulator(method="stabilizer", noise_model=aer_nm)

counts = []
for i, checked_circ_result in enumerate(tqdm(checked_circuits)):
    noisy_counts = (
        noisy_sim.run(
            noisy_circuits[i], shots=num_shots, seed_simulator=seed * i + 1
        )
        .result()
        .get_counts()
    )
    checked_counts_per_variant = []
    for k, ck in enumerate(checked_circ_result):
        variant_counts = (
            noisy_sim.run(
                ck.circuit, shots=num_shots, seed_simulator=seed * i + 2 + k
            )
            .result()
            .get_counts()
        )
        checked_counts_per_variant.append(variant_counts)
    counts.append((noisy_counts, checked_counts_per_variant))
100%|██████████| 20/20 [00:17<00:00, 1.13it/s]
Passo 4: Pós-processar e retornar o resultado no formato clássico desejado
Cada verificação usa portas de emaranhamento entre uma ancilla e um alvo. A ancilla começa em , então estabiliza sua entrada. Propagar para frente pelo circuito verificado produz um operador de Pauli na saída cujos termos não identidade definem o suporte da verificação. Uma verificação passa quando os bits em seu suporte têm paridade par. Uma amostra é mantida apenas quando toda verificação passa.
O get_postselection_method de cada CheckedCircuit retorna uma função que mapeia uma bitstring medida para um vetor de síndrome. Mantenha as amostras cuja síndrome é zero para toda verificação e descarte as demais. O gráfico a seguir mostra que adicionar mais verificações reduz a taxa de pós-seleção. Uma taxa de pós-seleção mais baixa exige mais shots para atingir uma precisão-alvo, então há uma compensação entre a capacidade de detecção e o custo de amostragem. A taxa parece convergir, o que indica que verificações adicionais contribuem com menos capacidade de detecção.
rate_per_variant = []
kept_per_stab = []
for i, (_, checked_counts_per_variant) in enumerate(counts):
    rates = []
    kept_at_num_checks = None
    for k, variant_counts in enumerate(checked_counts_per_variant):
        ps_fn = checked_circuits[i][k].get_postselection_method()
        kept = {
            bs: n for bs, n in variant_counts.items() if not ps_fn(bs).any()
        }
        rates.append(sum(kept.values()) / num_shots)
        if k == num_checks:
            kept_at_num_checks = kept
    rate_per_variant.append(rates)
    kept_per_stab.append(kept_at_num_checks)

max_len = max(len(s) for s in rate_per_variant)
rates_arr = np.full((len(rate_per_variant), max_len), np.nan)
for i, s in enumerate(rate_per_variant):
    rates_arr[i, : len(s)] = s
ks = np.arange(max_len)

fig, ax = plt.subplots(figsize=(8, 4))
ax.plot(ks, rates_arr.T, color="#ff8c00", alpha=0.15, linewidth=1)
ax.plot(
    ks,
    np.nanmedian(rates_arr, axis=0),
    color="black",
    linewidth=1,
    linestyle="--",
    label="median",
)
ax.set_xlabel("Checks committed")
ax.set_ylabel("Postselection rate")
ax.set_ylim((0, 1.05))
ax.set_title(
    f"Per-stabilizer postselection rate ({len(rates_arr)} stabilizers)"
)
ax.legend()
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()

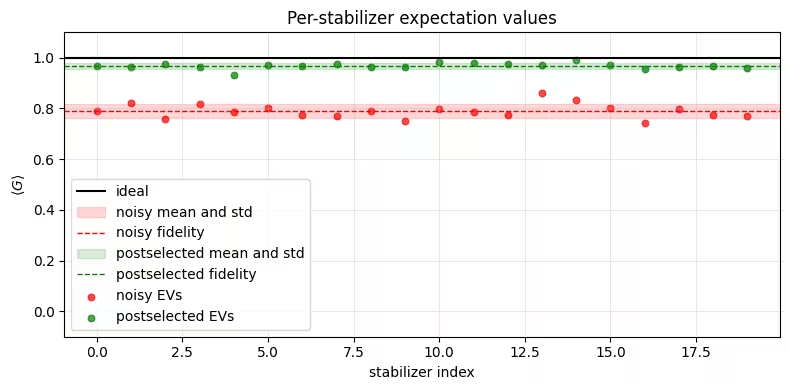
Agora compare a fidelidade do estado ruidoso puro com o estado pós-selecionado. Pós-selecionar apenas as amostras sem erro detectado eleva o valor esperado de todo estabilizador e, portanto, a fidelidade estimada. Os valores pós-selecionados usam menos amostras do que os valores brutos, mas os valores esperados são mais precisos e a variância amostrada é menor. Observe também que a taxa média de pós-seleção está próxima da fidelidade ruidosa. Isso é o que se espera quando as verificações detectam quase todas as amostras errôneas: a fração de amostras que passa em toda verificação se aproxima da fração de amostras sem erro, que é a fidelidade do estado ruidoso.
results = []
for i, ((noisy_counts, _), kept) in enumerate(
    zip(counts, kept_per_stab, strict=True)
):
    results.append(
        (
            expectation(noisy_counts, stabilizers[i]),
            expectation(kept, stabilizers[i]),
            sum(kept.values()) / num_shots,
        )
    )

fidelity_noisy = float(np.nanmean([r[0] for r in results]))
fidelity_postsel = float(np.nanmean([r[1] for r in results]))
psr = float(np.mean([r[2] for r in results]))
print(
    f"ideal fidelity:          1.0\n"
    f"noisy fidelity:          {fidelity_noisy:.4f}\n"
    f"postselected fidelity:   {fidelity_postsel:.4f}\n"
    f"mean postselection rate: {psr:.3f}"
)

evs_ideal = np.ones(len(results))
evs_noisy = np.array([r[0] for r in results])
evs_post = np.array([r[1] for r in results])
idx = np.arange(len(results))

def strip(ax, ys, color, label):
    m, s = np.nanmean(ys), np.nanstd(ys)
    ax.axhspan(
        m - s, m + s, color=color, alpha=0.15, label=f"{label} mean and std"
    )
    ax.axhline(
        m, color=color, linewidth=1, linestyle="--", label=f"{label} fidelity"
    )

fig, ax = plt.subplots(figsize=(8, 4))
ax.axhline(np.nanmean(evs_ideal), color="black", linewidth=1.5, label="ideal")
strip(ax, evs_noisy, "red", "noisy")
strip(ax, evs_post, "green", "postselected")
ax.scatter(idx, evs_noisy, color="red", s=22, alpha=0.7, label="noisy EVs")
ax.scatter(
    idx,
    evs_post,
    color="green",
    s=22,
    alpha=0.7,
    label="postselected EVs",
)
ax.set_xlabel("stabilizer index")
ax.set_ylabel(r"$\langle G \rangle$")
ax.set_ylim((-0.1, 1.1))
ax.set_title("Per-stabilizer expectation values")
ax.legend(loc="lower left")
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()

M = np.arange(1, len(results) + 1)
fig, ax = plt.subplots(figsize=(8, 4))
for ys, color, label in [
    (evs_ideal, "black", "ideal"),
    (evs_noisy, "red", "noisy"),
    (evs_post, "green", "postselected"),
]:
    cm, sem = cum_mean_sem(ys)
    ax.plot(M, cm, color=color, linewidth=1.5, label=label)
    ax.fill_between(M, cm - sem, cm + sem, color=color, alpha=0.15)
ax.set_xlabel("number of stabilizers averaged")
ax.set_ylabel("running fidelity estimate")
ax.set_title("Fidelity convergence versus number of stabilizers")
ax.legend()
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
ideal fidelity:          1.0
noisy fidelity:          0.7899
postselected fidelity:   0.9679
mean postselection rate: 0.780

A pontuação gamma informa quanto do canal de ruído modelado permanece não detectado pelas verificações. Plotar a pontuação gamma em função do número de verificações confirmadas mostra como a capacidade de detecção melhora à medida que cada verificação é adicionada. Um valor de 1.0 significa que as verificações capturam todo o ruído modelado. As curvas caem em direção a 1.0 à medida que mais verificações são confirmadas, o que mostra que cada verificação adicional captura parte do erro restante não detectado.
stab_scores = [
    [variant.cost for variant in checked_circ_result]
    for checked_circ_result in checked_circuits
]
max_len = max(len(s) for s in stab_scores)
scores = np.full((len(stab_scores), max_len), np.nan)
for i, s in enumerate(stab_scores):
    scores[i, : len(s)] = s
ks = np.arange(max_len)

fig, ax = plt.subplots(figsize=(8, 4))
ax.plot(ks, scores.T, color="#4682b4", alpha=0.15, linewidth=1)
ax.plot(
    ks,
    np.nanmedian(scores, axis=0),
    color="black",
    linewidth=1,
    linestyle="--",
    label="median",
)
ax.set_xlabel("Checks committed")
ax.set_ylabel("Gamma")
ax.set_yscale("log")
ax.set_title(f"Per-stabilizer gamma curves ({len(scores)} stabilizers)")
ax.legend()
ax.grid(True, alpha=0.3, which="both")
plt.tight_layout()
plt.show()

Exemplo de hardware em larga escala
O mesmo fluxo de trabalho é executado em hardware com um payload maior e mais profundo. Esta seção reutiliza o backend do exemplo do simulador, mas constrói um novo layout de 20 qubits com seus próprios pares de alvo e ancilla e pass manager, então submete os circuitos à QPU em um único job. Nesse tamanho, a maioria dos shots aciona pelo menos uma verificação, então a taxa de pós-seleção é baixa, e cada circuito precisa de um orçamento grande de shots para que amostras suficientes sobrevivam. O exemplo, portanto, concentra seu orçamento em alguns estabilizadores amostrados; isso ainda é uma estimativa de fidelidade não enviesada, mas é mais grosseira do que a média sobre muitos estabilizadores do exemplo do simulador.
Uma coisa muda em relação ao exemplo do simulador: em vez de inferir um canal de despolarização uniforme a partir de dados de calibração, esta seção aprende o modelo de ruído com NoiseLearner e constrói o modelo do qiskit-paulice a partir do resultado com NoiseModel.from_pauli_lindblad_maps. Um modelo Pauli-Lindblad aprendido captura a estrutura espacial do ruído nesse layout específico, em vez de assumir que toda aresta é igualmente ruidosa, de modo que o posicionamento das verificações é pontuado em relação a um ruído mais semelhante ao que afeta a QPU. Aprender o ruído requer amostrar a QPU e deve ser considerado em qualquer orçamento geral de amostragem da QPU.
Os parâmetros a seguir definem o número de qubits, a profundidade, o número de estabilizadores e o número de shots. Escale hw_num_shots com o inverso da taxa de pós-seleção: a uma taxa de 3%, 40.000 shots deixam aproximadamente 1.200 amostras pós-selecionadas por circuito. Aumente hw_num_stabilizers para uma estimativa de fidelidade mais precisa, ao custo de mais circuitos por job, cada um exigindo o mesmo orçamento de shots.
Passos 1-4 (compactados em um único bloco de código)
A célula a seguir executa os mesmos quatro passos do exemplo do simulador. Ela constrói o payload maior e amostra alguns estabilizadores (passo 1); escolhe um layout, aprende o modelo de ruído sobre ele e encontra o circuito totalmente verificado para cada estabilizador (passo 2); submete um job de Sampler que contém tanto os circuitos puros quanto os verificados (passo 3); e pós-seleciona as contagens verificadas para comparar as estimativas de fidelidade ruidosa e pós-selecionada, por estabilizador e em média (passo 4). Nesse tamanho, enumerar o grupo estabilizador completo como no exemplo do simulador é inviável, então a célula subamostra um subconjunto aleatório de estabilizadores para calcular uma estimativa da fidelidade.
Observe que o passo 2 faz mais aqui do que no exemplo do simulador: aprender o modelo de ruído submete seu próprio job de NoiseLearner antes do job de Sampler, então a célula executa dois jobs no total. Eles carregam as tags TUT_ASPC_LEARN e TUT_ASPC para que você possa encontrá-los depois. Veja Organizar e pesquisar por tags de job para mais informações sobre marcação de jobs.
# -------------------------Step 1: build a larger payload and sample stabilizers-------------------------
hw_num_qubits = 20
hw_depth = 36
hw_num_stabilizers = 10
hw_num_shots = 40_000

hw_circuit = random_clifford_circuit(hw_num_qubits, hw_depth, rng)
hw_no_meas = hw_circuit.remove_final_measurements(inplace=False)

# Enumerating all 2^n stabilizers is infeasible at this size, so draw each
# stabilizer by composing a random subset of the group generators
hw_generators = [
    Pauli(label) for label in Clifford(hw_no_meas).to_labels(mode="S")
]
sample_rng = np.random.default_rng(seed)
hw_stabilizers = []
while len(hw_stabilizers) < hw_num_stabilizers:
    mask = sample_rng.integers(0, 2, hw_num_qubits).astype(bool)
    if not mask.any():
        continue  # skip the identity
    stabilizer = Pauli("I" * hw_num_qubits)
    for generator, chosen in zip(hw_generators, mask, strict=True):
        if chosen:
            stabilizer = stabilizer.compose(generator)
    hw_stabilizers.append(stabilizer)

# -------------------------Step 2: find a 20-qubit layout, learn its noise, and add checks-------------------------
# A single bad coupler or bad-readout qubit on the path drags every
# stabilizer down, so search harder and with tighter error thresholds
hw_layout = find_check_layout(
    backend,
    hw_num_qubits,
    rng,
    num_trials=500,
    max_gate_error=0.015,
    max_readout_error=0.05,
)
hw_target_qubits, hw_ancilla_qubits = get_check_qubits(backend, hw_layout)
hw_pm = generate_preset_pass_manager(
    optimization_level=0, backend=backend, initial_layout=hw_layout
)
print(f"Layout with {len(hw_target_qubits)} check pairs: {hw_layout}")

# ----- learn a Pauli-Lindblad noise model on this layout -----
# The simulator example scored checks against a uniform depolarizing channel
# inferred from calibration data. Here, learn the noise instead: NoiseLearner
# runs its own job on the QPU and returns a Pauli-Lindblad channel per unique
# entangling layer, so the checks are placed against the noise this layout
# actually has, including its spatial structure. All the sampled stabilizers
# share the same entangling layers and differ only in their final basis
# rotation, so learning on the bare payload covers all of them.
learner = NoiseLearner(
    mode=backend,
    options={
        "max_layers_to_learn": 4,
        "num_randomizations": 32,
        "shots_per_randomization": 128,
        "environment": {"job_tags": ["TUT_ASPC_LEARN"]},
    },
)
learner_job = learner.run([hw_pm.run(hw_circuit)])
print(f"Submitted noise-learner job {learner_job.job_id()}")
hw_layer_errors = learner_job.result().data

# To see how much the learned model helps, swap the next line for the
# simulator example's uniform model - a one-line change:
# hw_noise_model = NoiseModel.from_backend(backend, hw_layout, uniform_gate_noise=True)
hw_noise_model = learned_noise_model(hw_layer_errors, hw_layout)
# NoiseLearner characterizes gate noise only, so keep the readout estimate
# from calibration data rather than leaving it unset
hw_noise_model.readout_noise = NoiseModel.from_backend(
    backend, hw_layout, uniform_gate_noise=True
).readout_noise
print(
    f"Learned {len(hw_layer_errors)} layers; "
    f"readout noise {hw_noise_model.readout_noise:.5f}"
)

# ----- add the fully checked circuit per stabilizer -----
hw_noisy_circuits = []
hw_checked_circuits = []
for i, pauli in enumerate(tqdm(hw_stabilizers)):
    bare = hw_pm.run(append_basis_rotation(hw_circuit, pauli))
    hw_noisy_circuits.append(bare)
    variants = add_pauli_checks(
        bare,
        hw_target_qubits,
        hw_noise_model,
        ancilla_qubits=hw_ancilla_qubits,
        cost="gamma",
        method="windowed",
        seed=seed + 1 + i,
    )
    hw_checked_circuits.append(variants[-1])  # keep the fully checked circuit

# -------------------------Step 3: submit one Sampler job with the bare and checked circuits-------------------------
sampler = Sampler(mode=backend)
sampler.options.default_shots = hw_num_shots
sampler.options.environment.job_tags = ["TUT_ASPC"]

pubs = hw_noisy_circuits + [cc.circuit for cc in hw_checked_circuits]
job = sampler.run(pubs)
print(f"Submitted job {job.job_id()} with {len(pubs)} circuits")

# -------------------------Step 4: postselect and compare fidelity-------------------------
result = job.result()
n_stab = len(hw_stabilizers)

hw_results = []
for i in range(n_stab):
    noisy_counts = result[i].join_data().get_counts()
    checked_counts = result[n_stab + i].join_data().get_counts()
    ps_fn = hw_checked_circuits[i].get_postselection_method()
    kept = {bs: c for bs, c in checked_counts.items() if not ps_fn(bs).any()}
    hw_results.append(
        (
            expectation(noisy_counts, hw_stabilizers[i]),
            expectation(kept, hw_stabilizers[i]),
            sum(kept.values()) / sum(checked_counts.values()),
        )
    )

hw_fidelity_noisy = float(np.nanmean([r[0] for r in hw_results]))
hw_fidelity_postsel = float(np.nanmean([r[1] for r in hw_results]))
hw_psr = float(np.mean([r[2] for r in hw_results]))
print(
    f"noisy fidelity estimate:        {hw_fidelity_noisy:.4f}\n"
    f"postselected fidelity estimate: {hw_fidelity_postsel:.4f}\n"
    f"mean postselection rate:        {hw_psr:.4f} "
    f"(~{int(round(hw_psr * hw_num_shots))} kept shots per circuit)"
)

# Per-stabilizer breakdown. The postselection rate varies from stabilizer to
# stabilizer, so a stabilizer whose postselected value barely moves is usually
# one whose checks rejected little; the kept-shot count says how much of the
# gap is statistics rather than signal.
print("\nper-stabilizer results:")
print(
    f"{'idx':>3}  {'noisy':>8}  {'postsel':>8}  {'psr':>7}  {'kept shots':>10}"
)
for i, (noisy, post, psr_i) in enumerate(hw_results):
    print(
        f"{i:>3}  {noisy:>8.4f}  {post:>8.4f}  {psr_i:>7.4f}  "
        f"{int(round(psr_i * hw_num_shots)):>10}"
    )

hw_noisy = np.array([r[0] for r in hw_results])
hw_post = np.array([r[1] for r in hw_results])
idx = np.arange(n_stab)

fig, ax = plt.subplots(figsize=(9, 4))
ax.axhline(1.0, color="black", linewidth=1.5, label="ideal")
strip(ax, hw_noisy, "red", "noisy")
strip(ax, hw_post, "green", "postselected")
ax.scatter(idx, hw_noisy, color="red", s=22, alpha=0.7, label="noisy EVs")
ax.scatter(
    idx,
    hw_post,
    color="green",
    s=22,
    alpha=0.7,
    label="postselected EVs",
)
ax.set_xlabel("stabilizer index")
ax.set_ylabel(r"$\langle G \rangle$")
ax.set_ylim((-0.1, 1.1))
ax.set_xticks(idx)
ax.set_title("Per-stabilizer expectation values on hardware")
# Outside the axes so it cannot hide a data point
ax.legend(loc="center left", bbox_to_anchor=(1.02, 0.5), frameon=False)
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
Layout with 11 check pairs: [153, 152, 151, 138, 131, 130, 129, 118, 109, 110, 111, 98, 91, 90, 89, 78, 69, 70, 71, 58]
Submitted noise-learner job d9f4mncjeosc73fjfmkg
Learned 4 layers; readout noise 0.00470
100%|██████████| 10/10 [01:01<00:00, 6.18s/it]
Submitted job d9f4s04jeosc73fjftkg with 20 circuits
noisy fidelity estimate:        0.3685
postselected fidelity estimate: 0.6869
mean postselection rate:        0.2851 (~11404 kept shots per circuit)

per-stabilizer results:
idx     noisy   postsel      psr  kept shots
  0    0.3769    0.6918   0.3247       12987
  1    0.3745    0.6760   0.2999       11995
  2    0.3659    0.6389   0.3549       14196
  3    0.3821    0.7060   0.2660       10641
  4    0.3653    0.7475   0.2531       10124
  5    0.3752    0.7022   0.2698       10791
  6    0.3508    0.7144   0.2711       10842
  7    0.3485    0.7087   0.2381        9523
  8    0.3825    0.6289   0.2928       11711
  9    0.3630    0.6549   0.2808       11232

Para circuitos desse tamanho, a maioria das amostras contém pelo menos um erro detectado, então a taxa de pós-seleção é pequena e a pós-seleção descarta a maioria dos shots. As amostras que passam em toda verificação fornecem um valor esperado muito melhor do que o circuito puro, e os valores por estabilizador se separam claramente da linha de base ruidosa. Para refinar a estimativa de fidelidade, amostre mais estabilizadores com o mesmo orçamento de shots por circuito. Para aumentar a taxa de pós-seleção, reduza a profundidade do circuito ou confirme menos verificações; para avançar para payloads maiores, escale o orçamento de shots com o inverso da taxa de pós-seleção.
Próximos passos
Se você achou este trabalho interessante, pode se interessar pelo seguinte material:
-
O tutorial sobre códigos de repetição para uma introdução à correção de erros quânticos.
-
A documentação do
qiskit-paulicepara a API completa de busca de verificações, e o repositório GitHub do pacote para o código-fonte. -
O artigo Low-overhead error detection with spacetime codes para a teoria por trás das verificações.
Referências
-
[1] Martiel, S., & Javadi-Abhari, A. (2025). Low-overhead error detection with spacetime codes. arXiv preprint arXiv:2504.15725.
-
[2] van den Berg, E., Bravyi, S., Gambetta, J. M., Jurcevic, P., Maslov, D., & Temme, K. (2023). Single-shot error mitigation by coherent Pauli checks. Physical Review Research, 5(3), 033193.