QESEM: Uma Qiskit Function da Qedma
Consulte a referência da API
Versões dos pacotes
O código nesta página foi desenvolvido usando os seguintes requisitos. Recomendamos usar essas versões ou mais recentes.
qiskit[all]~=2.5.0
qiskit-ibm-runtime~=0.47.0
As Qiskit Functions são um recurso experimental disponível apenas para usuários dos planos IBM Quantum® Premium, Flex e On-Prem (via IBM Quantum Platform API). Elas estão em status de lançamento em pré-visualização e sujeitas a alterações.
Visão geral
Embora as unidades de processamento quântico tenham melhorado enormemente nos últimos anos, os erros causados por ruído e imperfeições no hardware existente continuam sendo um desafio central para os desenvolvedores de algoritmos quânticos. À medida que a área se aproxima de computações quânticas em escala de utilidade que não podem ser verificadas classicamente, soluções para cancelar ruído com precisão garantida tornam-se cada vez mais importantes. Para superar esse desafio, a Qedma desenvolveu o Quantum Error Mitigation (QESEM), integrado de forma transparente na IBM Quantum Platform como uma Qiskit Function.
Com o QESEM, os usuários podem executar seus Circuits quânticos em QPUs ruidosas para obter resultados altamente precisos e livres de erros, com sobrecargas de tempo de QPU altamente eficientes, próximas dos limites fundamentais. Para isso, o QESEM utiliza um conjunto de métodos proprietários desenvolvidos pela Qedma para caracterização e redução de erros. As técnicas de redução de erros incluem otimização de Gates, transpilação ciente de ruído, supressão de erros (ES) e mitigação de erros imparcial (EM). Com essa combinação de métodos baseados em caracterização, os usuários podem obter resultados confiáveis e livres de erros para Circuits quânticos genéricos de grande volume, viabilizando aplicações que não poderiam ser realizadas de outra forma.
Para uma descrição completa dos componentes subjacentes, bem como uma demonstração em escala de utilidade, consulte o artigo Reliable high-accuracy error mitigation for utility-scale quantum circuits.
Descrição
Você pode usar a função QESEM da Qedma para estimar e executar facilmente seus circuitos com supressão e mitigação de erros, alcançando volumes maiores de circuitos e maiores precisões. Para usar o QESEM, você fornece um circuito quântico, um conjunto de observáveis a medir, uma precisão estatística alvo para cada observável e uma QPU escolhida. Antes de executar o circuito com a precisão alvo, você pode estimar o tempo de QPU necessário com base em um cálculo analítico que não requer a execução do circuito. Quando estiver satisfeito com a estimativa de tempo de QPU, você pode executar o circuito com o QESEM.
Quando você executa um circuito, o QESEM roda um protocolo de caracterização do dispositivo adaptado ao seu circuito, gerando um modelo de ruído confiável para os erros que ocorrem no circuito. Com base na caracterização, o QESEM primeiro implementa transpilação ciente de ruído para mapear o circuito de entrada em um conjunto de qubits físicos e gates, minimizando o ruído que afeta o observável alvo. Isso inclui os gates nativamente disponíveis (CX/CZ em dispositivos IBM®), bem como gates adicionais otimizados pelo QESEM, formando o conjunto estendido de gates do QESEM. O QESEM então executa um conjunto de circuitos ES e EM baseados em caracterização na QPU e coleta os resultados das medições. Esses resultados são então pós-processados classicamente para fornecer um valor esperado imparcial e uma barra de erro para cada observável, correspondendo à precisão solicitada.
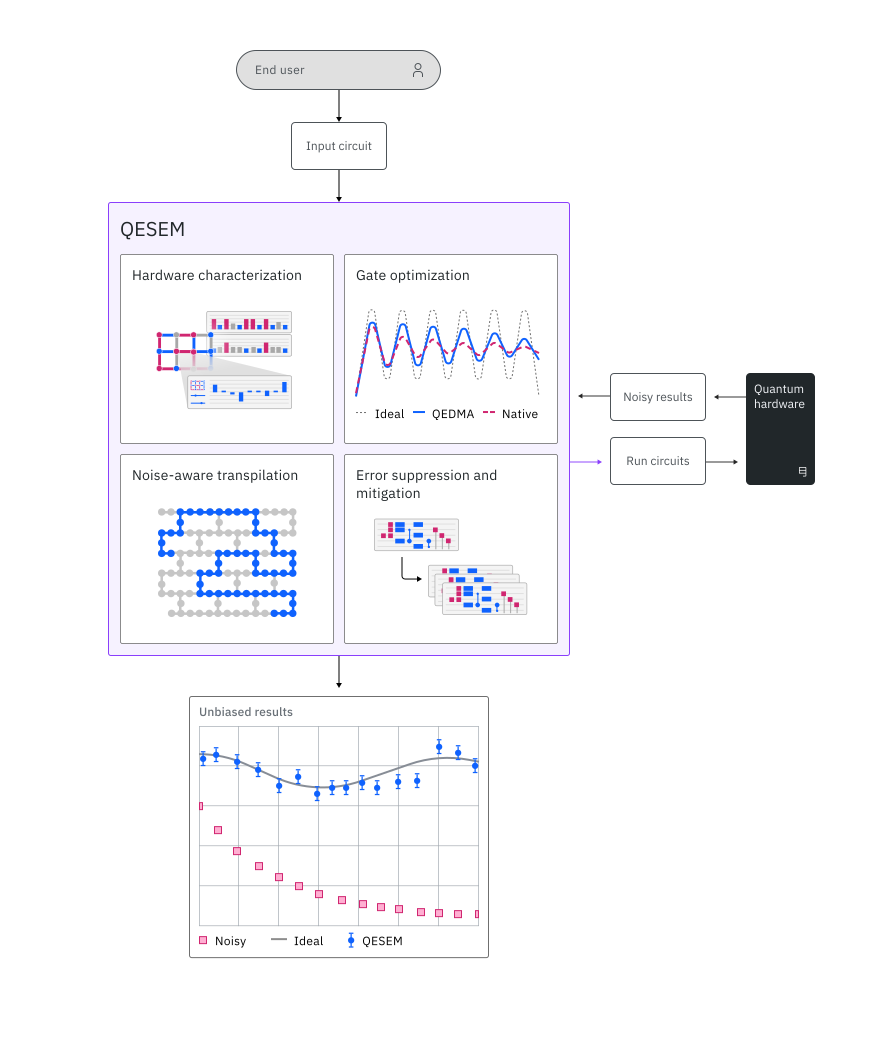 O QESEM demonstrou fornecer resultados de alta precisão para uma variedade de aplicações quânticas e nos maiores volumes de circuitos alcançáveis hoje. O QESEM oferece os seguintes recursos voltados ao usuário, demonstrados na seção de benchmarks abaixo:
- Precisão garantida: O QESEM gera estimativas imparciais para os valores esperados dos observáveis. Seu método EM é equipado com garantias teóricas que — em conjunto com a caracterização de ponta da Qedma — asseguram que a mitigação converge para a saída do circuito sem ruído, dentro da precisão especificada pelo usuário. Em contraste com muitos métodos heurísticos de EM propensos a erros sistemáticos ou vieses, a precisão garantida do QESEM é essencial para assegurar resultados confiáveis em circuitos quânticos e observáveis genéricos.
- Escalabilidade para grandes QPUs: O tempo de QPU do QESEM depende dos volumes de circuito, mas é independente do número de qubits. A Qedma demonstrou o QESEM nos maiores dispositivos quânticos disponíveis hoje, incluindo os dispositivos IBM Quantum Eagle de 127 qubits e Heron de 133 qubits.
- Independente de aplicação: O QESEM foi demonstrado em uma variedade de aplicações, incluindo simulação de Hamiltoniano, VQE, QAOA e estimativa de amplitude. Os usuários podem inserir qualquer circuito quântico e observável a ser medido, e obter resultados precisos e livres de erros. As únicas limitações são ditadas pelas especificações de hardware e pelo tempo de QPU alocado, que determinam os volumes de circuito acessíveis e as precisões de saída. Em contraste, muitas soluções de redução de erros são específicas para aplicações ou envolvem heurísticas não controladas, tornando-as inaplicáveis para circuitos e aplicações quânticas genéricas.
- Conjunto estendido de gates: O QESEM suporta gates de ângulo fracionário e fornece gates de ângulo fracionário otimizados pela Qedma nos dispositivos IBM Quantum Heron e Eagle. Esse conjunto estendido de gates permite uma compilação mais eficiente e viabiliza volumes de circuito maiores em até um fator de 2 em comparação com a compilação padrão CX/CZ.
- Observáveis multibase: O QESEM suporta observáveis de entrada compostos por muitas strings de Pauli não comutativas, como Hamiltonianos genéricos. A escolha das bases de medição e a otimização da alocação de recursos de QPU (shots e circuitos) são então realizadas automaticamente pelo QESEM para minimizar o tempo de QPU necessário para a precisão solicitada. Essa otimização, que leva em conta as fidelidades de hardware e as taxas de execução, permite que você execute circuitos mais profundos e obtenha maior precisão.
Benchmarks
O QESEM foi testado em uma ampla variedade de casos de uso e aplicações. Os exemplos a seguir podem ajudar você a avaliar quais tipos de cargas de trabalho podem ser executadas com o QESEM.
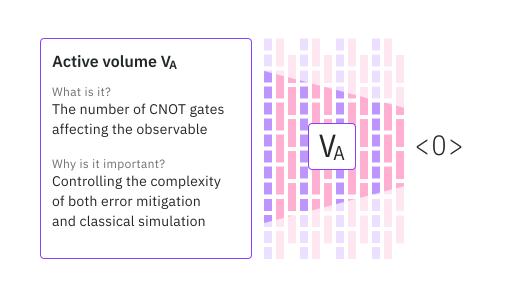
Uma figura de mérito fundamental para quantificar a dificuldade tanto da mitigação de erros quanto da simulação clássica para um dado circuito e observável é o volume ativo: o número de gates CNOT que afetam o observável no circuito. O volume ativo depende da profundidade e largura do circuito, do peso do observável e da estrutura do circuito, que determina o cone de luz do observável. Para mais detalhes, veja a palestra do IBM Quantum Summit 2024. O QESEM oferece valor particularmente alto no regime de alto volume, fornecendo resultados confiáveis para circuitos e observáveis genéricos.
| Aplicação | Número de qubits | Dispositivo | Descrição do circuito | Precisão | Tempo total | Uso de runtime |
|---|---|---|---|---|---|---|
| Circuito VQE | 8 | Eagle (r3) | 21 camadas no total, 9 bases de medição, cadeia 1D | 98% | 35 min | 14 min |
| Kicked Ising | 28 | Eagle (r3) | 3 camadas únicas x 3 passos, topologia heavy-hex 2D | 97% | 22 min | 4 min |
| Kicked Ising | 28 | Eagle (r3) | 3 camadas únicas x 8 passos, topologia heavy-hex 2D | 97% | 116 min | 23 min |
| Simulação de Hamiltoniano Trotterizado | 40 | Eagle (r3) | 2 camadas únicas x 10 passos de Trotter, cadeia 1D | 97% | 3 horas | 25 min |
| Simulação de Hamiltoniano Trotterizado | 119 | Eagle (r3) | 3 camadas únicas x 9 passos de Trotter, topologia heavy-hex 2D | 95% | 6,5 horas | 45 min |
| Kicked Ising | 136 | Heron (r2) | 3 camadas únicas x 15 passos, topologia heavy-hex 2D | 99% | 52 min | 9 min |
A precisão é medida aqui em relação ao valor ideal do observável: , onde '' é a precisão absoluta da mitigação (definida pelo usuário), e é o observável no circuito sem ruído. 'Uso de runtime' mede o uso do benchmark em batch mode (soma do uso de jobs individuais), enquanto 'tempo total' mede o uso em session mode (tempo de parede do experimento), que inclui tempos adicionais de computação clássica e comunicação. O QESEM está disponível para execução em ambos os modos, para que os usuários possam fazer o melhor uso dos seus recursos disponíveis.
Os circuitos Kicked Ising de 28 qubits simulam o Cristal de Quase-Tempo Discreto estudado por Shinjo et al. (veja arXiv 2403.16718 e Q2B24 Tokyo) em três loops conectados do ibm_kawasaki. Os parâmetros de circuito usados aqui são , com um estado inicial ferromagnético . O observável medido é o valor absoluto da magnetização . O experimento Kicked Ising em escala de utilidade foi executado nos 136 melhores qubits do ibm_fez; este benchmark específico foi executado no ângulo de Clifford , no qual o volume ativo cresce lentamente com a profundidade do circuito, o que — em conjunto com as altas fidelidades do dispositivo — permite alta precisão em um curto tempo de execução.
Os circuitos de simulação de Hamiltoniano Trotterizado são para um modelo de Ising de Campo Transverso em ângulos fracionários: e respectivamente (veja Q2B24 Tokyo). O circuito em escala de utilidade foi executado nos 119 melhores qubits do ibm_brisbane, enquanto o experimento de 40 qubits foi executado na melhor cadeia disponível. A precisão é reportada para a magnetização; resultados de alta precisão também foram obtidos para observáveis de maior peso.
O circuito VQE foi desenvolvido em conjunto com pesquisadores do Center for Quantum Technology and Applications do Deutsches Elektronen-Synchrotron (DESY). O observável alvo aqui era um Hamiltoniano composto por um grande número de strings de Pauli não comutativas, enfatizando o desempenho otimizado do QESEM para observáveis multibase. A mitigação foi aplicada a um ansatz otimizado classicamente; embora esses resultados ainda não tenham sido publicados, resultados da mesma qualidade serão obtidos para circuitos diferentes com propriedades estruturais semelhantes.
Primeiros passos
Autentique-se usando sua chave de API da IBM Quantum Platform e selecione a Qiskit Function QESEM como segue. (Este trecho assume que você já salvou sua conta no seu ambiente local.)
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"qiskit": "qiskit", "qiskit_ibm_catalog": "qiskit-ibm-catalog", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import qiskit
from qiskit_ibm_catalog import QiskitFunctionsCatalog

catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")

# verify that you have access to the function
catalog.list()
# load the function
qesem_function = catalog.load("qedma/qesem")
Exemplos
Exemplo de job de estimativa de tempo
O job de estimativa de tempo é útil para estimar o tempo de QPU necessário para um determinado pub e backend_name. backend_name também pode ser definido como qualquer backend simulador; por exemplo, fake_fez.
O QESEM usa um método de EM quase-probabilístico baseado em caracterização. Esse método tem uma sobrecarga de tempo de QPU que escala aproximadamente como:
Onde é o volume ativo do circuito, é a precisão alvo, e é a infidelidade das portas nativas.
Observe que "estimate_time_only": "empirical" usa alguns minutos de tempo de QPU para estimar o tempo necessário para o job (se o backend for um dispositivo real; se for um simulador, então nenhum tempo de QPU é usado). Isso geralmente leva cerca de 5 minutos, mas no máximo 10 minutos. Se a infidelidade mudar drasticamente entre o job de estimativa de tempo empírica e o job de mitigação, o tempo de QPU também mudará drasticamente.
Para começar, experimente este exemplo básico de estimativa do tempo de QPU necessário para executar o QESEM para um dado pub:
# This cell is hidden from users
from qiskit_ibm_runtime import QiskitRuntimeService

service = QiskitRuntimeService()
backend_name = service.least_busy().name
backend_name = "fake_fez"

circ = qiskit.QuantumCircuit(5)
circ.cx(0, 1)
circ.cx(2, 3)
circ.cx(1, 2)
circ.cx(3, 4)

avg_magnetization = qiskit.quantum_info.SparsePauliOp.from_sparse_list(
    [("Z", [q], 1 / 5) for q in range(5)], num_qubits=5
)
other_observable = qiskit.quantum_info.SparsePauliOp.from_sparse_list(
    [("ZZ", [0, 1], 1.0), ("XZ", [1, 4], 0.5)], num_qubits=5
)

time_estimation_job = qesem_function.run(
    pubs=[(circ, [avg_magnetization, other_observable])],
    options={
        "estimate_time_only": "empirical",
    },
    backend_name=backend_name,  # example: "fake_fez", "ibm_fez"
)
time_estimate_result = (
    time_estimation_job.result()
)  # a list of results per pub (circuit)
O trecho de código a seguir descreve como recuperar diferentes métricas de execução do job de estimativa de tempo (quando estimate_time_only está definido):
pub_result = time_estimate_result[0]

print(
    f"The estimated QPU time for mitigation for this PUB is: {pub_result.metadata['time_estimation_sec']}"
)
print(
    f"The QPU time that this time estimation job took is (here it is 0 because we used fake_fez): {pub_result.metadata['total_qpu_time']}"
)
print(
    f"Gates fidelity measured during the experiment: {pub_result.metadata['gate_fidelities']}"
)
print(f"Total shots: {pub_result.metadata['total_shots']}")
print(f"Resource usage breakdown: {pub_result.metadata['resource_usage']}")
The estimated QPU time for mitigation for this PUB is: 300
The QPU time that this time estimation job took is (here it is 0 because we used fake_fez): 0
Gates fidelity measured during the experiment: {'CZ': 0.9951354916722668, 'ID1Q': 0.9991246627329172}
Total shots: 220000
Resource usage breakdown: {'RUNNING: MAPPING': {'CPU_TIME': 33.6066133165732, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: OPTIMIZING_FOR_HARDWARE': {'CPU_TIME': 184.53575124032795, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: WAITING_FOR_QPU': {'CPU_TIME': 0.0, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: EXECUTING_QPU': {'CPU_TIME': 0.0, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: POST_PROCESSING': {'CPU_TIME': 0.0, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}}
Quando a estimativa de tempo empírica está habilitada, o QESEM executa um pequeno número de circuitos para fornecer uma estimativa de tempo de QPU mais precisa. Os resultados de mitigação desses circuitos estão disponíveis no campo empirical_estimation_mitigation_results do job.
Como esses resultados são derivados de uma amostra limitada de circuitos, eles são significativamente menos precisos do que os resultados finais obtidos do job completo de mitigação QESEM. No entanto, quando o circuito é pequeno ou a precisão alvo é baixa, a mitigação realizada durante a estimativa de tempo empírica pode ser suficiente para atingir a precisão desejada, e o job de mitigação completo pode não ser necessário.
O campo empirical_estimation_mitigation_results é uma lista de objetos PrimitiveResult por parâmetro de entrada. Se o circuito não for parametrizado, a lista terá comprimento 1.
empirical_estimation_mitigation_results = time_estimate_result[0].metadata[
    "empirical_estimation_mitigation_results"
][0]  # a list per parameter
print("Partial results for the observables:")

print(
    f"    Mitigated expectation values: {empirical_estimation_mitigation_results.data.evs}"
)
print(
    f"    Mitigated error bars: {empirical_estimation_mitigation_results.data.stds}"
)
print(
    f"    Number of shots used for mitigation: {empirical_estimation_mitigation_results.metadata['mitigation_shots']}"
)
transpiled_circ = empirical_estimation_mitigation_results.metadata[
    "transpiled_circ"
]
print(f"    Qubit mapping: {transpiled_circ['qubit_maps']}")
print(
    f"    Number of measurement bases: {transpiled_circ['num_measurement_bases']}\n"
)

# results per obs
emp_obs_results = empirical_estimation_mitigation_results.metadata["results"][
    0
]
# print(f"Results for each observable: {results}")
print("Results for each observable:")

for i, (obs_array, result_dict) in enumerate(emp_obs_results):
    # obs_array, result_dict = results
    print(f"Observable {i+1}: {obs_array}")
    print(
        f"    QESEM mitigated value: {result_dict['qesem']['value']} \u00b1 {result_dict['qesem']['error_bar']}"
    )
Partial results for the observables:
    Mitigated expectation values: [1.00347302 1.00693905]
    Mitigated error bars: [0.00304061 0.00714276]
    Number of shots used for mitigation: 180000
    Qubit mapping: [[[0, 136], [1, 143], [2, 142], [3, 141], [4, 140]]]
    Number of measurement bases: 2

Results for each observable:
Observable 1: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
    QESEM mitigated value: 1.003473015776871 ± 0.0030406128032204015
Observable 2: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
    QESEM mitigated value: 1.0069390542613554 ± 0.0071427606736885925
Exemplo de job de mitigação QESEM
O exemplo a seguir executa um job QESEM:
sample_job = qesem_function.run(
    pubs=[(circ, [avg_magnetization, other_observable])],
    backend_name=backend_name,  # example: "ibm_fez"
    # options = {
    #     "estimate_time_only": "empirical",
    #     "default_precision": 0.2,  # Default precision is applied to all pubs that don't have a precision specified, see API reference for more details
    #     "max_execution_time": 3600,  # You can specify a maximum QPU time in seconds, see API reference for more details
    #     "transpilation_level": "standard",  # "minimal_with_layout_opt" for minimal transpilation, see API reference for more details
    #     "parallel_execution": True,  # True for parallel execution, see API reference for more details
    # },
)
Para uma descrição detalhada de cada campo e opção de entrada, consulte a referência da API QESEM. Você pode usar as APIs familiares do Qiskit Serverless para verificar o status da sua carga de trabalho da Qiskit Function ou retornar resultados:
# Print the ID so you can use it later, if necessary
print(sample_job.job_id)
print(sample_job.status())
sample_result = sample_job.result()
3ac6b2df-15b0-4dc0-8f48-cf14bd20a1c8
DONE
O trecho de código a seguir demonstra como recuperar os resultados de mitigação e as métricas de execução. Eles contêm dados essenciais que permitem uma compreensão mais profunda de como diferentes parâmetros afetam a execução do QESEM. Também pode ser relevante ao escrever um artigo baseado em sua pesquisa.
for pub_idx, pub_result in enumerate(
    sample_result
):  # each element in the list is a result for a different pub, here we sent only one pub
    print(f"\nPUB {pub_idx}:")
    print(
        f"  The QPU time that this job took is (here it is 0 because we used fake_fez): {pub_result.metadata['total_qpu_time']}"
    )
    print(
        f"  Gates fidelity measured during the experiment: {pub_result.metadata['gate_fidelities']}"
    )
    print(f"  Total shots: {pub_result.metadata['total_shots']}")
    print(
        f"  Number of shots used for mitigation: {pub_result.metadata['mitigation_shots']}"
    )
    print(
        f"  Resource usage breakdown: {pub_result.metadata['resource_usage']}"
    )
PUB 0:
  The QPU time that this job took is (here it is 0 because we used fake_fez): 0.0
  Gates fidelity measured during the experiment: {'CZ': 0.9953704216147041, 'ID1Q': 0.9991834123567518}
  Total shots: 446000
  Number of shots used for mitigation: 194000
  Resource usage breakdown: {'RUNNING: MAPPING': {'CPU_TIME': 32.52745003718883, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: OPTIMIZING_FOR_HARDWARE': {'CPU_TIME': 257.850521848537, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: WAITING_FOR_QPU': {'CPU_TIME': 0.0, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: EXECUTING_QPU': {'CPU_TIME': 0.0, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: POST_PROCESSING': {'CPU_TIME': 0.0, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}}
Em metadata["results"], os resultados são agrupados primeiro por instância de circuito e depois por observável.
print("Full QESEM mitigation results:")

for pub_idx, pub_result in enumerate(sample_result):
    print(f"\nPUB {pub_idx}:")

    print(f"  Mitigated expectation values: {pub_result.data.evs}")
    print(f"  Mitigated error bars: {pub_result.data.stds}")
    noisy_results = pub_result.metadata.get("noisy_results")
    print(f"  Unmitigated expectation values: {noisy_results.evs}")
    print(f"  Unmitigated error bars: {noisy_results.stds}")

    print("  Transpiled circuits:")
    for circ_idx, transpiled_circ in enumerate(
        pub_result.metadata["transpiled_circs"]
    ):
        print(f"    Circuit {circ_idx}:")
        # print(f"      Circuit: \n {transpiled_circ['circuit']}") # not printing it because it's long but you can see the transpiled circuit itself
        print(f"      Qubit mapping: {transpiled_circ['qubit_maps']}")
        print(
            f"      Measurement bases: {transpiled_circ['num_measurement_bases']}"
        )

    print("  Results for each observable:")
    for circ_idx, circ_results in enumerate(pub_result.metadata["results"]):
        print(f"    Circuit {circ_idx}:")
        for obs_idx, (obs_array, result_dict) in enumerate(circ_results):
            print(f"      Observable {obs_idx}: {obs_array}")
            print(
                f"        QESEM mitigated value: {result_dict['qesem']['value']} ± {result_dict['qesem']['error_bar']}"
            )
            print(
                f"        Unmitigated value: {result_dict['unmitigated']['value']} ± {result_dict['unmitigated']['error_bar']}"
            )
Full QESEM mitigation results:

PUB 0:
  Mitigated expectation values: [1.00648343 1.00636289]
  Mitigated error bars: [0.00253812 0.00693586]
  Unmitigated expectation values: [0.98031429 0.96357143]
  Unmitigated error bars: [0.00124128 0.00578812]
  Transpiled circuits:
    Circuit 0:
      Qubit mapping: [[[0, 140], [1, 141], [2, 142], [3, 143], [4, 136]]]
      Measurement bases: 2
  Results for each observable:
    Circuit 0:
      Observable 0: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
        QESEM mitigated value: 1.0064834305181962 ± 0.002538119914534849
        Unmitigated value: 0.9803142857142859 ± 0.0012412835813609938
      Observable 1: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
        QESEM mitigated value: 1.0063628870614818 ± 0.006935859820870656
        Unmitigated value: 0.9635714285714285 ± 0.005788121870526659
Detalhamento dos principais resultados:
mitigated: o valor esperado do QESEM totalmente mitigado.unmitigated: o resultado bruto de ruído físico sem mitigação de erros.
Resultados de extrapolação heurística do QESEM
Em uma execução padrão do QESEM com um único float de precision, os resultados também incluem pontos de escala de ruído automaticamente disponíveis que são usados para a heurística do QESEM. Esses pontos são calculados sem recursos adicionais de QPU.
A escala 1.0 representa o nível de ruído do dispositivo físico com mitigação de leitura (REM), enquanto a escala 2.0 é o ponto complementar de ruído amplificado, também com REM. Esses pontos são usados para produzir o resultado qesem_heuristic.
-
qesem_heuristic: uma estimativa no estilo ZNE calculada a partir dos dados disponíveis com escala de ruído. Atualmente, isso usa extrapolação exponencial. -
noise_scaling.results_with_REM: valores esperados em diferentes escalas de ruído, todos com mitigação de leitura (REM).
Um detalhe sutil mas importante é que o resultado da escala 1.0 não é o mesmo que o resultado unmitigated. Ambos correspondem ao nível de ruído do dispositivo físico, mas o ponto de escala 1.0 inclui mitigação de leitura, enquanto unmitigated não.
print("QESEM heuristic results:")

for pub_idx, pub_result in enumerate(sample_result):
    print(f"\nPUB {pub_idx}:")
    for circ_idx, circ_results in enumerate(pub_result.metadata["results"]):
        print(f"  Circuit {circ_idx}:")
        for obs_idx, (obs_array, result_dict) in enumerate(circ_results):
            print(f"    Observable {obs_idx}: {obs_array}")
            qesem_heuristic = result_dict["qesem_heuristic"][0]
            print("      QESEM heuristic:")
            print(
                f"        Value: {qesem_heuristic['value']} ± {qesem_heuristic['error_bar']}"
            )
            print(
                f"        Extrapolation: {qesem_heuristic['extrapolation']}"
            )
            print(
                f"        Scale factors: {qesem_heuristic['scale_factors']}"
            )
            noise_scaling = result_dict["noise_scaling"]
            print("      Noise scaling results:")
            print(
                f"        Scaling method: {noise_scaling['scaling_method']}"
            )
            print("        Results with Readout mitigation (REM):")
            for rem_result in sorted(
                (
                    item
                    for item in noise_scaling["results_with_REM"]
                    if item["scale"] != 0.0
                ),
                key=lambda item: item["scale"],
            ):
                print(
                    f"          Scale factor {rem_result['scale']}: {rem_result['value']} ± {rem_result['error_bar']}"
                )
QESEM heuristic results:

PUB 0:
  Circuit 0:
    Observable 0: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
      QESEM heuristic:
        Value: 1.0008161638888535 ± 0.0038859458884403964
        Extrapolation: exponential
        Scale factors: [1.0, 2.0]
      Noise scaling results:
        Scaling method: QESEM
        Results with Readout mitigation (REM):
          Scale factor 1.0: 0.9918395459270772 ± 0.0012565417579355634
          Scale factor 2.0: 0.982943441922748 ± 0.0028919278067695018
    Observable 1: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
      QESEM heuristic:
        Value: 0.9960853148925298 ± 0.013811635038961175
        Extrapolation: exponential
        Scale factors: [1.0, 2.0]
      Noise scaling results:
        Scaling method: QESEM
        Results with Readout mitigation (REM):
          Scale factor 1.0: 0.9902860583785115 ± 0.005921236914723409
          Scale factor 2.0: 0.984520565414274 ± 0.006909522262347639
Os exemplos a seguir se concentram em entradas e resultados específicos do recurso, portanto não imprimem as métricas completas de execução a cada vez. Os metadados de nível superior mostrados anteriormente, como total_qpu_time, gate_fidelities, total_shots, mitigation_shots e resource_usage, também estão disponíveis para esses jobs.
Algumas variáveis dos exemplos anteriores, incluindo o backend, os observáveis e os parâmetros do circuito base, são reutilizadas abaixo por questão de concisão.
Todos os exemplos a seguir também podem ser executados com estimativa de tempo empírica. Para ativá-la, passe "estimate_time_only": "empirical" nas opções da função.
Exemplo de circuito parametrizado
Muitos algoritmos avaliam o mesmo circuito em vários valores de parâmetros. Enviar o circuito parametrizado como um único job QESEM permite que o QESEM compartilhe caracterização e calibração entre as instâncias do circuito, o que pode reduzir a sobrecarga de tempo de QPU em comparação com a execução de jobs separados.
Enviar um circuito parametrizado requer o uso do nível de transpilação "minimal_with_layout_opt".
Os circuitos enviados nesse nível já devem estar expressos usando as portas base do backend, dependendo do backend. Nesse nível, o QESEM mantém a estrutura enviada o mais próximo possível do circuito de entrada, respeita as barreiras durante a layerification (agrupamento de operações em camadas de portas paralelas de dois qubits) e ainda trata automaticamente o mapeamento de hardware para qubits de alta fidelidade e a conectividade do dispositivo.
Na prática, isso significa que você deve transpilar os circuitos para as portas base do backend alvo antes do envio. Um exemplo simples de transpilação de portas base é mostrado abaixo.
Atualmente, o QESEM suporta apenas um observável por conjunto de parâmetros. As duas linhas de parâmetros abaixo são combinadas (zipped) com os dois observáveis: a primeira linha é medida com avg_magnetization, e a segunda linha é medida com other_observable.
# Transpile to the backend basis gates only. With minimal_with_layout_opt, QESEM handles hardware mapping/connectivity and observable layout internally.
from qiskit_ibm_runtime.fake_provider import FakeFez

backend = FakeFez()
basis = backend.operation_names
print(basis)

param0 = qiskit.circuit.Parameter("param0")
param1 = qiskit.circuit.Parameter("param1")
parametrized_circ = qiskit.QuantumCircuit(5)
parametrized_circ.rx(param0, 0)
parametrized_circ.rx(param1, 1)
parametrized_circ.cx(0, 1)
parametrized_circ.cx(2, 3)
parametrized_circ.cx(1, 2)
parametrized_circ.cx(3, 4)

parametrized_circ = qiskit.transpile(
    parametrized_circ, basis_gates=basis, optimization_level=1
)
parametrized_parameter_values = [[0.5, 0.1], [0.0, 0.6]]
parametrized_observables = [avg_magnetization, other_observable]

parametrized_job = qesem_function.run(
    pubs=[
        (
            parametrized_circ,
            parametrized_observables,
            parametrized_parameter_values,
            0.1,
        )
    ],
    backend_name=backend_name,
    options={
        "max_execution_time": 300,
        "transpilation_level": "minimal_with_layout_opt",
    },
)
print(parametrized_job.job_id)
print(parametrized_job.status())
d1b0e29b-196c-4896-aec6-44a268ebd874
DONE
parametrized_result = parametrized_job.result()
print("Parameterized circuit QESEM results:")

for pub_idx, pub_result in enumerate(parametrized_result):
    print(f"\nPUB {pub_idx}:")
    print(f"  Mitigated expectation values: {pub_result.data.evs}")
    print(f"  Mitigated error bars: {pub_result.data.stds}")
    noisy_results = pub_result.metadata["noisy_results"]
    print(f"  Unmitigated expectation values: {noisy_results.evs}")
    print(f"  Unmitigated error bars: {noisy_results.stds}")
    print("  Results for each parameter value:")
    for param_idx, param_results in enumerate(pub_result.metadata["results"]):
        print(
            f"    Parameter set {param_idx}: {parametrized_parameter_values[param_idx]}"
        )
        for obs_idx, (obs_array, result_dict) in enumerate(param_results):
            print(f"      Observable {obs_idx}: {obs_array}")
            print(
                f"        QESEM mitigated value: {result_dict['qesem']['value']} ± {result_dict['qesem']['error_bar']}"
            )
            print(
                f"        Unmitigated value: {result_dict['unmitigated']['value']} ± {result_dict['unmitigated']['error_bar']}"
            )
Parameterized circuit QESEM results:

PUB 0:
  Mitigated expectation values: [0.92392021 0.82517653]
  Mitigated error bars: [0.00565281 0.00616016]
  Unmitigated expectation values: [0.9028     0.78771429]
  Unmitigated error bars: [0.00335142 0.00925413]
  Results for each parameter value:
    Parameter set 0: [0.5, 0.1]
      Observable 0: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
        QESEM mitigated value: 0.923920210615709 ± 0.005652811570890183
        Unmitigated value: 0.9028 ± 0.0033514176105045447
    Parameter set 1: [0.0, 0.6]
      Observable 0: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
        QESEM mitigated value: 0.8251765289285893 ± 0.006160161743353999
        Unmitigated value: 0.7877142857142858 ± 0.009254130564027902
Exemplo de multi-pub
A execução multi-pub é útil quando você deseja executar vários circuitos relacionados em um único job QESEM. Assim como a execução parametrizada, isso pode reduzir a sobrecarga porque o QESEM pode compartilhar caracterização e calibração entre instâncias de circuito, em vez de repeti-la em jobs separados.
Isso é especialmente útil para circuitos com uma estrutura de camadas compartilhada, como cargas de trabalho do tipo Trotter, onde diferentes circuitos reutilizam as mesmas camadas únicas. Nesse caso, executá-los juntos pode reduzir o custo de caracterização em comparação com jobs QESEM independentes.
Jobs multi-pub requerem "transpilation_level": "minimal_with_layout_opt". Como no exemplo parametrizado, os circuitos devem ser transpilados para as portas base do backend alvo antes do envio. O QESEM então trata internamente a conectividade do dispositivo, o layout e o mapeamento para qubits de alta fidelidade.
Cada PUB abaixo contém um circuito e os mesmos dois observáveis usados anteriormente no notebook, então o PrimitiveResult retornado contém um PubResult por circuito de entrada.
O exemplo abaixo usa dois circuitos Trotter simples com o mesmo padrão de camadas: circ_a tem uma camada Trotter, e circ_b repete o mesmo padrão de camada duas vezes. Isso torna a estrutura compartilhada explícita.
def make_trotter_circuit(num_qubits, num_layers, zz_angle=0.2, x_angle=0.1):
    trotter_circ = qiskit.QuantumCircuit(num_qubits)
    for _ in range(num_layers):
        for q in range(num_qubits):
            trotter_circ.rx(x_angle, q)
        trotter_circ.barrier()
        for q in range(0, num_qubits - 1, 2):
            trotter_circ.rzz(zz_angle, q, q + 1)
        trotter_circ.barrier()
        for q in range(1, num_qubits - 1, 2):
            trotter_circ.rzz(zz_angle, q, q + 1)
        trotter_circ.barrier()
    return trotter_circ

circ_a = make_trotter_circuit(num_qubits=5, num_layers=1)
circ_b = make_trotter_circuit(num_qubits=5, num_layers=2)
multi_pubs = [
    (
        qiskit.transpile(qci, basis_gates=basis, optimization_level=1),
        [avg_magnetization, other_observable],
    )
    for qci in [circ_a, circ_b]
]

multi_circ_job = qesem_function.run(
    pubs=multi_pubs,
    backend_name=backend_name,
    options={
        "max_execution_time": 300,
        "transpilation_level": "minimal_with_layout_opt",
        "default_precision": 0.1,
    },
)
print(multi_circ_job.job_id)
print(multi_circ_job.status())
e34565b8-7262-4133-a120-de42ce624a99
DONE
multi_circ_result = multi_circ_job.result()
print("Multi-pub QESEM results:")

for pub_idx, pub_result in enumerate(multi_circ_result):
    print(f"\nPUB {pub_idx}:")
    print(f"  Mitigated expectation values: {pub_result.data.evs}")
    print(f"  Mitigated error bars: {pub_result.data.stds}")
    noisy_results = pub_result.metadata["noisy_results"]
    print(f"  Unmitigated expectation values: {noisy_results.evs}")
    print(f"  Unmitigated error bars: {noisy_results.stds}")
    print("  Results for each observable:")
    for circ_idx, circ_results in enumerate(pub_result.metadata["results"]):
        print(f"    Circuit {circ_idx}:")
        for obs_idx, (obs_array, result_dict) in enumerate(circ_results):
            print(f"      Observable {obs_idx}: {obs_array}")
            print(
                f"        QESEM mitigated value: {result_dict['qesem']['value']} ± {result_dict['qesem']['error_bar']}"
            )
            print(
                f"        Unmitigated value: {result_dict['unmitigated']['value']} ± {result_dict['unmitigated']['error_bar']}"
            )
Multi-pub QESEM results:

PUB 0:
  Mitigated expectation values: [0.99502406 1.02209332]
  Mitigated error bars: [0.00483819 0.00707488]
  Unmitigated expectation values: [0.96934286 0.97271429]
  Unmitigated error bars: [0.00124855 0.00617294]
  Results for each observable:
    Circuit 0:
      Observable 0: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
        QESEM mitigated value: 0.9950240647925642 ± 0.004838188086259301
        Unmitigated value: 0.9693428571428573 ± 0.0012485470362492692
      Observable 1: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
        QESEM mitigated value: 1.0220933230604674 ± 0.007074884384355636
        Unmitigated value: 0.9727142857142859 ± 0.006172939375512439

PUB 1:
  Mitigated expectation values: [0.98850017 1.02555188]
  Mitigated error bars: [0.0077912  0.01672652]
  Unmitigated expectation values: [0.93682857 0.95371429]
  Unmitigated error bars: [0.00156245 0.00665735]
  Results for each observable:
    Circuit 0:
      Observable 0: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
        QESEM mitigated value: 0.988500171577252 ± 0.007791203181151346
        Unmitigated value: 0.9368285714285716 ± 0.001562451883089579
      Observable 1: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
        QESEM mitigated value: 1.02555188098689 ± 0.016726524388086233
        Unmitigated value: 0.9537142857142858 ± 0.006657345655544263
Exemplo de Ajuste de Erro Quase-Probabilístico (QET)
O Ajuste de Erro Quase-Probabilístico (QET) solicita valores esperados em fatores de escala de ruído selecionados. Isso é útil para estudos personalizados de escala de ruído e fluxos de trabalho de Extrapolação de Ruído Zero. A escala 1.0 é o nível de ruído físico, valores entre 0.0 e 1.0 reduzem parcialmente o ruído, e valores acima de 1.0 amplificam o ruído.
Para usar o QET com a Qiskit Function, passe um dicionário como a precisão do PUB. O dicionário mapeia cada escala de ruído solicitada para sua precisão alvo. Os resultados de fator de escala retornados são armazenados em noise_scaling.results_with_REM e incluem mitigação de leitura. O ponto de escala 1.0 não é, portanto, idêntico ao valor não mitigado, porque 1.0 inclui mitigação de leitura enquanto unmitigated não.
Quando uma escala é solicitada, o QESEM também retorna a escala complementar em torno de 1.0 sem uso adicional de QPU. Por exemplo, solicitar 0.5 também pode retornar 1.5, e solicitar 1.3 também pode retornar 0.7. A precisão na escala complementar não é garantida.
noise_scale_precision = {0.5: 0.15, 1.3: 0.2}

qet_job = qesem_function.run(
    pubs=[
        (
            circ,
            [avg_magnetization, other_observable],
            None,
            noise_scale_precision,
        )
    ],
    backend_name=backend_name,
    options={"max_execution_time": 300},
)
print(qet_job.job_id)
print(qet_job.status())
8195fa58-f037-4651-8715-36ce1cdc5521
DONE
qet_result = qet_job.result()
print("QET noise-scaling results:")

for pub_idx, pub_result in enumerate(qet_result):
    print(f"\nPUB {pub_idx}:")
    noisy_results = pub_result.metadata["noisy_results"]
    print(f"  Unmitigated expectation values: {noisy_results.evs}")
    print(f"  Unmitigated error bars: {noisy_results.stds}")
    print("  Results for each observable:")
    for circ_idx, circ_results in enumerate(pub_result.metadata["results"]):
        print(f"    Circuit {circ_idx}:")
        for obs_idx, (obs_array, result_dict) in enumerate(circ_results):
            print(f"      Observable {obs_idx}: {obs_array}")
            noise_scaling = result_dict["noise_scaling"]
            print(
                f"        Scaling method: {noise_scaling['scaling_method']}"
            )
            print("        Results with Readout mitigation (REM):")
            for rem_result in sorted(
                (
                    item
                    for item in noise_scaling["results_with_REM"]
                    if item["scale"] != 0.0
                ),
                key=lambda item: item["scale"],
            ):
                print(
                    f"          Scale factor {rem_result['scale']}: {rem_result['value']} ± {rem_result['error_bar']}"
                )
QET noise-scaling results:

PUB 0:
  Unmitigated expectation values: [0.97822857 0.96171429]
  Unmitigated error bars: [0.00123812 0.00672958]
  Results for each observable:
    Circuit 0:
      Observable 0: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
        Scaling method: QESEM
        Results with Readout mitigation (REM):
          Scale factor 0.5: 0.9938730340199383 ± 0.0032116907357568275
          Scale factor 0.7: 0.9963976191853445 ± 0.00036300258869586616
          Scale factor 1.0: 0.9898115079506586 ± 0.0012525947426560995
          Scale factor 1.3: 0.9864667065580341 ± 0.002633221613518526
          Scale factor 1.5: 0.9838755527197551 ± 0.002948417797996015
      Observable 1: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
        Scaling method: QESEM
        Results with Readout mitigation (REM):
          Scale factor 0.5: 1.0006538544450332 ± 0.002121742014777343
          Scale factor 0.7: 1.0004159801523036 ± 0.0021671375357823794
          Scale factor 1.0: 0.9898058846339917 ± 0.00690183710903159
          Scale factor 1.3: 0.9948946719997267 ± 0.002146532859610311
          Scale factor 1.5: 0.9927220368192772 ± 0.0020875057190323882
Buscar mensagens de erro
Se o status da sua carga de trabalho for ERROR, use job.result() para buscar a mensagem de erro da seguinte forma:
# Get the result and truncate for readability
result = sample_job.result()
result_str = str(result)
max_length = 500  # Adjust this value as necessary

if len(result_str) > max_length:
    truncated = (
        result_str[:max_length]
        + f"... (truncated {len(result_str) - max_length} characters)"
    )
else:
    truncated = result_str

print(truncated)
PrimitiveResult([PubResult(data=DataBin(evs=np.ndarray(<shape=(2,), dtype=float64>), stds=np.ndarray(<shape=(2,), dtype=float64>), shape=(2,)), metadata={'gate_fidelities': {'CZ': 0.9979444718552628, 'ID1Q': 0.9991994239814883}, 'total_shots': 498600, 'mitigation_shots': 223400, 'transpiled_circs': [{'circuit': 'OPENQASM 3.0;\ninclude "stdgates.inc";\nbit[76] c0;\nqubit[76] q0;\nrx(0) q0[54];\nrx(0) q0[59];\nrx(0) q0[75];\nrz(pi/2) q0[54];\nrz(pi/2) q0[59];\nrz(pi/2) q0[75];\nrx(pi/2) q0[54];\nr... (truncated 3771 characters)
Obter suporte
A equipe de suporte da Qedma está aqui para ajudar! Se você encontrar algum problema ou tiver dúvidas sobre o uso da Qiskit Function QESEM, não hesite em entrar em contato. Nossa equipe de suporte experiente e atenciosa está pronta para ajudá-lo com qualquer preocupação técnica ou dúvida que você possa ter.
Você pode nos enviar um e-mail para support@qedma.com para obter assistência. Por favor, inclua o máximo de detalhes possível sobre o problema que está enfrentando para nos ajudar a fornecer uma resposta rápida e precisa. Você também pode entrar em contato com seu representante dedicado da Qedma via e-mail ou telefone.
Para nos ajudar a atendê-lo de forma mais eficiente, por favor forneça as seguintes informações ao entrar em contato:
-
Uma descrição detalhada do problema
-
O ID do job
-
Quaisquer mensagens de erro ou códigos relevantes
Estamos comprometidos em fornecer suporte rápido e eficaz para garantir que você tenha a melhor experiência possível com nossa Qiskit Function.
Estamos sempre buscando melhorar nosso produto e agradecemos suas sugestões! Se você tiver ideias sobre como podemos aprimorar nossos serviços ou recursos que gostaria de ver, envie seus pensamentos para support@qedma.com.
Próximos passos
-
Visitar a referência da API para esta Qiskit Function.
-
Experimente o tutorial Simular Ising de campo inclinado 2D com a função QESEM.