Performance Management: Uma Função Qiskit pela Q-CTRL Fire Opal
Veja a referência de API
As Qiskit Functions são um recurso experimental disponível apenas para usuários dos planos IBM Quantum® Premium Plan, Flex Plan e On-Prem (via API da IBM Quantum Platform). Elas estão em status de versão prévia e sujeitas a mudanças.
Package versions
O código nesta página foi desenvolvido usando os seguintes requisitos. Recomendamos usar essas versões ou mais recentes.
qiskit[all]~=2.3.1
qiskit-ibm-runtime~=0.45.1
Visão geral
O Fire Opal Performance Management torna simples para qualquer pessoa obter resultados significativos de computadores quânticos em escala, sem precisar ser especialista em hardware quântico. Ao executar circuitos com o Fire Opal Performance Management, técnicas de supressão de erros baseadas em IA são aplicadas automaticamente, permitindo o escalonamento de problemas maiores com mais gates e qubits. Essa abordagem reduz o número de shots necessários para chegar à resposta correta, sem nenhuma sobrecarga adicional — resultando em economias significativas em tempo de computação e custo.
O Performance Management suprime erros e aumenta a probabilidade de obter a resposta correta em hardware com ruído. Em outras palavras, ele aumenta a relação sinal-ruído. A imagem a seguir mostra como a maior precisão proporcionada pelo Performance Management pode reduzir a necessidade de shots adicionais no caso de um algoritmo de Transformada de Fourier Quântica de 10 qubits. Com apenas 30 shots, a Q-CTRL atinge o limiar de confiança de 99%, enquanto o padrão (QiskitRuntime Sampler, optimization_level=3 e resilience_level=1, ibm_sherbrooke) requer 170.000 shots. Ao obter a resposta correta mais rapidamente, você economiza tempo de computação significativo.
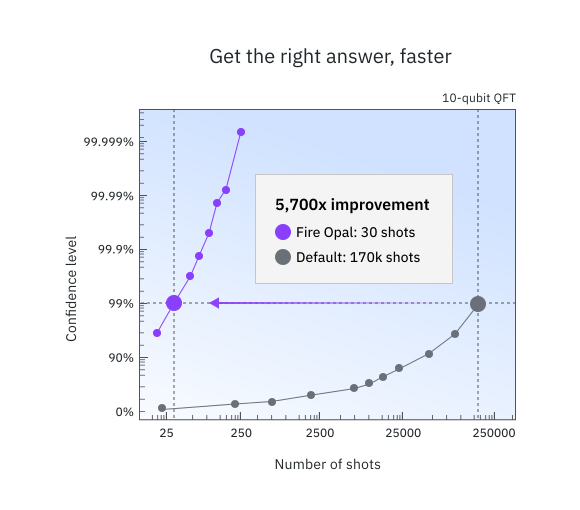
A função Performance Management pode ser usada com qualquer algoritmo, e você pode facilmente utilizá-la no lugar das primitivas padrão do IBM Quantum. Nos bastidores, múltiplas técnicas de supressão de erros trabalham em conjunto para evitar que erros ocorram em tempo de execução. Todos os métodos de pipeline do Fire Opal são pré-configurados e agnósticos ao algoritmo, o que significa que você sempre obtém o melhor desempenho logo de início.
Para obter acesso ao Performance Management, entre em contato com a Q-CTRL.
Descrição
O Fire Opal Performance Management possui duas opções de execução semelhantes às primitivas do IBM Quantum, para que você possa facilmente substituir pelo Sampler e Estimator da Q-CTRL. O fluxo de trabalho geral para usar a função Performance Management é:
- Defina seu Circuit (e operadores no caso do Estimator).
- Execute o Circuit.
- Recupere os resultados.
Para reduzir o ruído do hardware, o Fire Opal emprega uma série de técnicas de supressão de erros baseadas em IA, descritas na imagem a seguir. Com o Fire Opal, todo o pipeline é completamente automatizado, sem necessidade de configuração.
O pipeline do Fire Opal elimina a necessidade de sobrecarga adicional, como aumento do tempo de execução quântica ou qubits físicos extras. Observe que o tempo de processamento clássico continua sendo um fator (consulte a seção Benchmarks para estimativas, onde "Tempo total" reflete tanto o processamento clássico quanto o quântico). Ao contrário da mitigação de erros, que requer sobrecarga na forma de amostragem, a supressão de erros do Fire Opal funciona nos níveis de gate e pulso para lidar com várias fontes de ruído e prevenir a ocorrência de erros. Ao prevenir erros, a necessidade de pós-processamento custoso é eliminada.
A imagem a seguir mostra os métodos de supressão de erros automatizados pelo Fire Opal Performance Management.
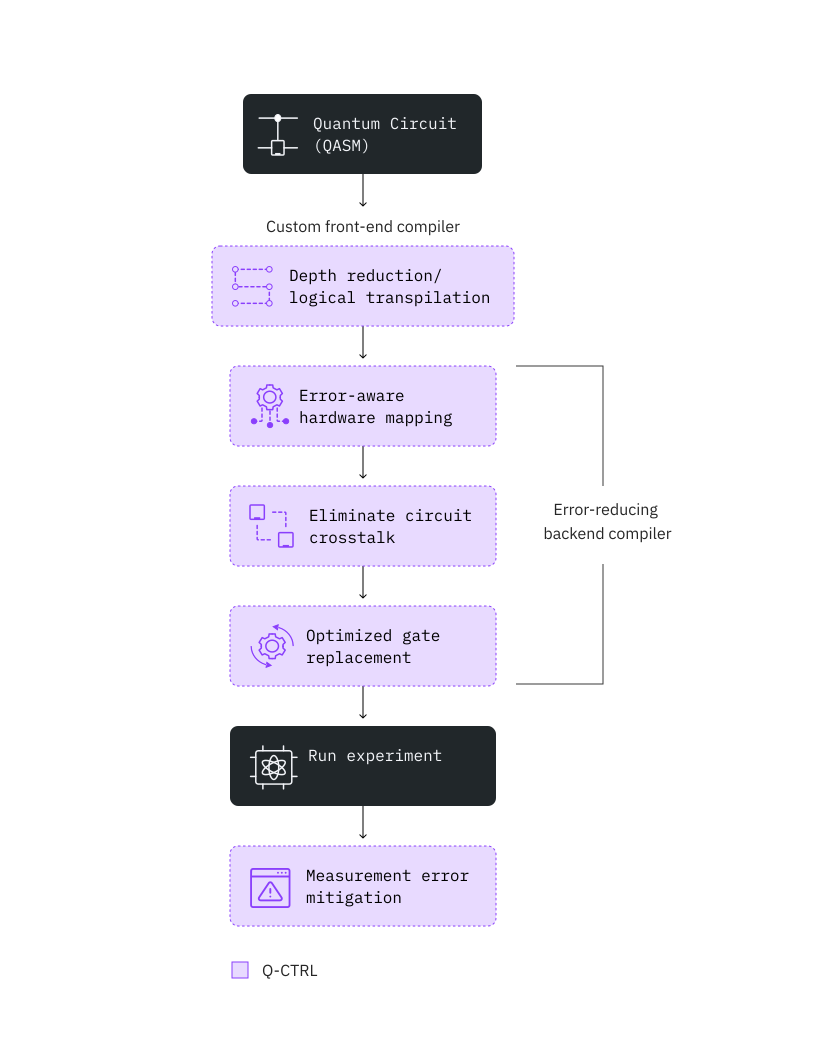
A função oferece duas primitivas, Sampler e Estimator, e as entradas e saídas de ambas estendem a especificação implementada para as primitivas IBM Quantum V2.
Benchmarks
Os resultados de benchmarking algorítmico publicados demonstram melhora significativa de desempenho em vários algoritmos, incluindo Bernstein-Vazirani, transformada de Fourier quântica, busca de Grover, algoritmo de otimização aproximada quântica e eigensolver variacional quântico. O restante desta seção fornece mais detalhes sobre os tipos de algoritmos que você pode executar, bem como o desempenho e os tempos de execução esperados.
Os seguintes estudos independentes demonstram como o Performance Management da Q-CTRL viabiliza pesquisa algorítmica em escala recorde:
- Parametrized Energy-Efficient Quantum Kernels for Network Service Fault Diagnosis - aprendizado de kernel quântico com até 50 qubits
- Tensor-based quantum phase difference estimation for large-scale demonstration - estimativa de fase quântica com até 33 qubits
- Hierarchical Learning for Quantum ML: Novel Training Technique for Large-Scale Variational Quantum Circuits - carregamento de dados quânticos com até 21 qubits
A tabela a seguir fornece um guia aproximado de precisão e tempos de execução de execuções de benchmarking anteriores no ibm_fez. O desempenho em outros dispositivos pode variar. O tempo de uso é baseado em uma suposição de 10.000 shots por circuito. O "Número de qubits" indicado não é uma limitação rígida, mas representa limiares aproximados onde você pode esperar precisão de solução extremamente consistente. Problemas maiores foram resolvidos com sucesso, e testes além desses limites são encorajados.
| Exemplo | Número de qubits | Precisão | Medida de precisão | Tempo total (s) | Uso de runtime (s) | Primitiva (Modo) |
|---|---|---|---|---|---|---|
| Bernstein–Vazirani | 50Q | 100% | Taxa de Sucesso (Porcentagem de execuções em que a resposta correta é a bitstring com maior contagem) | 10 | 8 | Sampler |
| Transformada de Fourier Quântica | 30Q | 100% | Taxa de Sucesso (Porcentagem de execuções em que a resposta correta é a bitstring com maior contagem) | 10 | 8 | Sampler |
| Estimativa de Fase Quântica | 30Q | 99,9998% | Precisão do ângulo encontrado: 1- abs(real_angle - angle_found)/pi | 10 | 8 | Sampler |
| Simulação quântica: Modelo de Ising (15 passos) | 20Q | 99,775% | (definido abaixo) | 60 (por passo) | 15 (por passo) | Estimator |
| Simulação quântica 2: dinâmica molecular (20 pontos de tempo) | 34Q | 96,78% | (definido abaixo) | 10 (por ponto de tempo) | 6 (por ponto de tempo) | Estimator |
Definindo a precisão da medição de um valor esperado - a métrica é definida como segue:
onde = valor esperado ideal, = valor esperado medido, = valor máximo ideal, e = valor mínimo ideal. é simplesmente a média do valor de ao longo de múltiplas medições.
Essa métrica é usada porque é invariante a deslocamentos globais e escalonamento no intervalo de valores atingíveis. Em outras palavras, independentemente de você deslocar o intervalo de possíveis valores esperados para cima ou para baixo, ou aumentar a dispersão, o valor de deve permanecer consistente.
Primeiros passos
O Fire Opal Performance Management usa Qiskit v2.0.0, que é a versão recomendada. As versões suportadas são Qiskit >=v2.0.0.
Autentique-se usando sua chave de API da IBM Quantum Platform e selecione a Função Qiskit conforme mostrado a seguir. (Este trecho assume que você já salvou sua conta no seu ambiente local.)
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "qiskit": "qiskit", "qiskit_ibm_catalog": "qiskit-ibm-catalog", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
# This cell is hidden from users. It hides the "...You have imported samplomatic..." warning.
import warnings

warnings.filterwarnings("ignore", message=".*You have imported samplomatic*")
from qiskit_ibm_catalog import QiskitFunctionsCatalog

catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")

# verify that you have access to the function
catalog.list()
[QiskitFunction(qunova/hivqe-chemistry),
 QiskitFunction(global-data-quantum/quantum-portfolio-optimizer),
 QiskitFunction(algorithmiq/tem),
 QiskitFunction(qedma/qesem),
 QiskitFunction(multiverse/singularity),
 QiskitFunction(ibm/circuit-function),
 QiskitFunction(q-ctrl/optimization-solver),
 QiskitFunction(colibritd/quick-pde),
 QiskitFunction(q-ctrl/performance-management),
 QiskitFunction(kipu-quantum/iskay-quantum-optimizer)]
# Access Function
perf_mgmt = catalog.load("q-ctrl/performance-management")
Se você quiser usar um backend que esta função não suporta atualmente, entre em contato com a Q-CTRL para adicionar suporte.
Primitiva Estimator
Exemplo com Estimator
Use a primitiva Estimator do Fire Opal Performance Management para determinar o valor esperado de um par circuito-observável.
Além dos pacotes qiskit-ibm-catalog e qiskit, você também usará o pacote numpy para executar este exemplo. Você pode instalar esse pacote descomentando a célula a seguir, se estiver executando este exemplo em um notebook usando o kernel IPython.
# %pip install numpy
1. Criar o circuito
Como exemplo, gere um operador Hermitiano aleatório e um observável para inserir na função Performance Management.
import numpy as np
from qiskit.circuit.library import iqp
from qiskit.quantum_info import random_hermitian, SparsePauliOp

n_qubits = 50

# Generate a random circuit
mat = np.real(random_hermitian(n_qubits, seed=1234))
circuit = iqp(mat)
circuit.measure_all()

# Define observables as a string
observable = SparsePauliOp("Z" * n_qubits)
# Create PUB tuple
estimator_pubs = [(circuit, observable)]
2. Executar o circuito
Execute o circuito e, opcionalmente, defina o backend e o número de shots.
# This cell is hidden from users
from qiskit_ibm_runtime import QiskitRuntimeService

service = QiskitRuntimeService()
backend_name = service.least_busy().name
# Run the circuit using Estimator
qctrl_estimator_job = perf_mgmt.run(
    primitive="estimator",
    pubs=estimator_pubs,
    backend_name=backend_name,
)
Você pode usar as APIs do Qiskit Serverless familiares para verificar o status da sua carga de trabalho da Função Qiskit:
qctrl_estimator_job.status()
'QUEUED'
3. Recuperar o resultado
# Retrieve the counts from the result list
result = qctrl_estimator_job.result()
Os resultados têm o mesmo formato de um resultado do Estimator:
import numpy

result_str = str(result)

with numpy.printoptions(threshold=200):
    print(
        f"The result of the submitted job had {len(result)} PUB "
        f"and has a value:\n {result[0]}\n"
    )

print("The associated PubResult of this job has the following DataBins:")
print(f"{result[0].data}\n")

print(f"And this DataBin has attributes: {result[0].data.keys()}")

print("The expectation values measured from this PUB are:")
print(f"{result[0].data.evs}")
The result of the submitted job had 1 PUB
The result of the submitted job had 1 PUB and has a value:
 PubResult(data=DataBin(evs=0.0195, stds=0.9998098569228051), metadata={'precision': None})

The associated PubResult of this job has the following DataBins:
DataBin(evs=0.0195, stds=0.9998098569228051)

And this DataBin has attributes: dict_keys(['evs', 'stds'])
The expectation values measured from this PUB are:
0.0195
Primitiva Sampler
Exemplo com Sampler
Use a primitiva Sampler do Fire Opal Performance Management para executar um circuito Bernstein–Vazirani. Esse algoritmo, usado para encontrar uma string oculta a partir das saídas de uma função de caixa-preta, é um algoritmo de benchmarking comum porque existe uma única resposta correta. 1. Criar o circuito
Defina a resposta correta para o algoritmo, a bitstring oculta, e o circuito Bernstein–Vazirani. Você pode ajustar a largura do circuito simplesmente alterando o circuit_width.
import qiskit

circuit_width = 35
hidden_bitstring = "1" * circuit_width

# Create circuit, reserving one qubit for BV oracle
bv_circuit = qiskit.QuantumCircuit(circuit_width + 1, circuit_width)
bv_circuit.x(circuit_width)
bv_circuit.h(range(circuit_width + 1))
for input_qubit, bit in enumerate(reversed(hidden_bitstring)):
    if bit == "1":
        bv_circuit.cx(input_qubit, circuit_width)
bv_circuit.barrier()
bv_circuit.h(range(circuit_width + 1))
bv_circuit.barrier()
for input_qubit in range(circuit_width):
    bv_circuit.measure(input_qubit, input_qubit)

# Create PUB tuple
sampler_pubs = [(bv_circuit,)]
2. Executar o circuito
Execute o circuito e, opcionalmente, defina o backend e o número de shots.
# Run the circuit using Sampler
qctrl_sampler_job = perf_mgmt.run(
    primitive="sampler",
    pubs=sampler_pubs,
    backend_name=backend_name,
)
Verifique o status da sua carga de trabalho da Função Qiskit ou recupere os resultados da seguinte forma:
# Print the ID so you can use it later, if necessary
print(qctrl_sampler_job.job_id)

qctrl_sampler_job.status()
60fe2fa1-a860-43e4-8615-c6ac4180f93b
'QUEUED'
3. Recuperar o resultado
# Retrieve the job results
sampler_result = qctrl_sampler_job.result()
# Get results for the first (and only) PUB
pub_result = sampler_result[0]
counts = pub_result.data.c.get_counts()

print("Counts for the meas output register (limited to 30 results):")
for i, (bitstring, count) in enumerate(counts.items()):
    if i >= 50:
        print(f"  ... ({len(counts) - 30} more items)")
        break
    print(f"  {bitstring}: {count}")
Counts for the meas output register (limited to 30 results):
  11111111111111111111111111111111111: 1661
  11111111111111111111111111110111111: 60
  11111111111111111111111111111101111: 54
  11111111111111111111111111111110111: 54
  11111111111111011111111111111111111: 46
  11111111111111111110111111111111111: 44
  11111111111111111111111101111111111: 42
  11111111111111111111111110111111111: 42
  11111111111111110111111111111111111: 41
  11111111111111111111111111111111101: 39
  11111111111111111111101111111111111: 38
  11111111111111111111110111111111111: 38
  11111111111111111111111111101111111: 37
  11111111111111111111111111111111110: 36
  11111111111110111111111111111111111: 35
  11111111111111111111111111111011111: 32
  11111111111111101111111111111111111: 32
  01111111111111111111111111111111111: 27
  11111111111111111011111111111111111: 23
  11111111101111111111111111111111111: 22
  11111111111111111111111111111111011: 21
  11111111011111111111111111111111111: 20
  00000000000000011111111111111111111: 18
  11111111111111111111110101111111111: 18
  00000001111111111111111111111111111: 17
  11111111001111111111111111111111111: 16
  11101111111111111111111111111111111: 16
  11111111111101111111111111111111111: 16
  00000101111111111111111111111111111: 13
  11111111111111111111111011111111111: 13
  11111111111111111111111110101111111: 13
  11111111111111111101111111111111111: 12
  10111111111111111111111111111111111: 12
  11111111111111111111111110001111111: 12
  00000000000000000011111111111111111: 11
  11111111111111111111111111111110110: 10
  00000000000000000000000001111111111: 10
  11111111111011111111111111111111111: 9
  11111111111111101011111111111111111: 9
  00000000011111111111111111111111111: 8
  10101111111111111111111111111111111: 8
  00000000000000000000000001011111111: 8
  11111111111111111111111111111111001: 8
  00000111111111111111111111111111111: 7
  11111111111111111111111111111101110: 7
  11111111110111111111111111111111111: 7
  00000000000001011111111111111111111: 6
  00000000000000001111111111111111111: 6
  00000000000000000001011111111111111: 6
  11111111111111111111111111011111111: 6
  ... (1050 more items)
3. Plotar as principais bitstrings
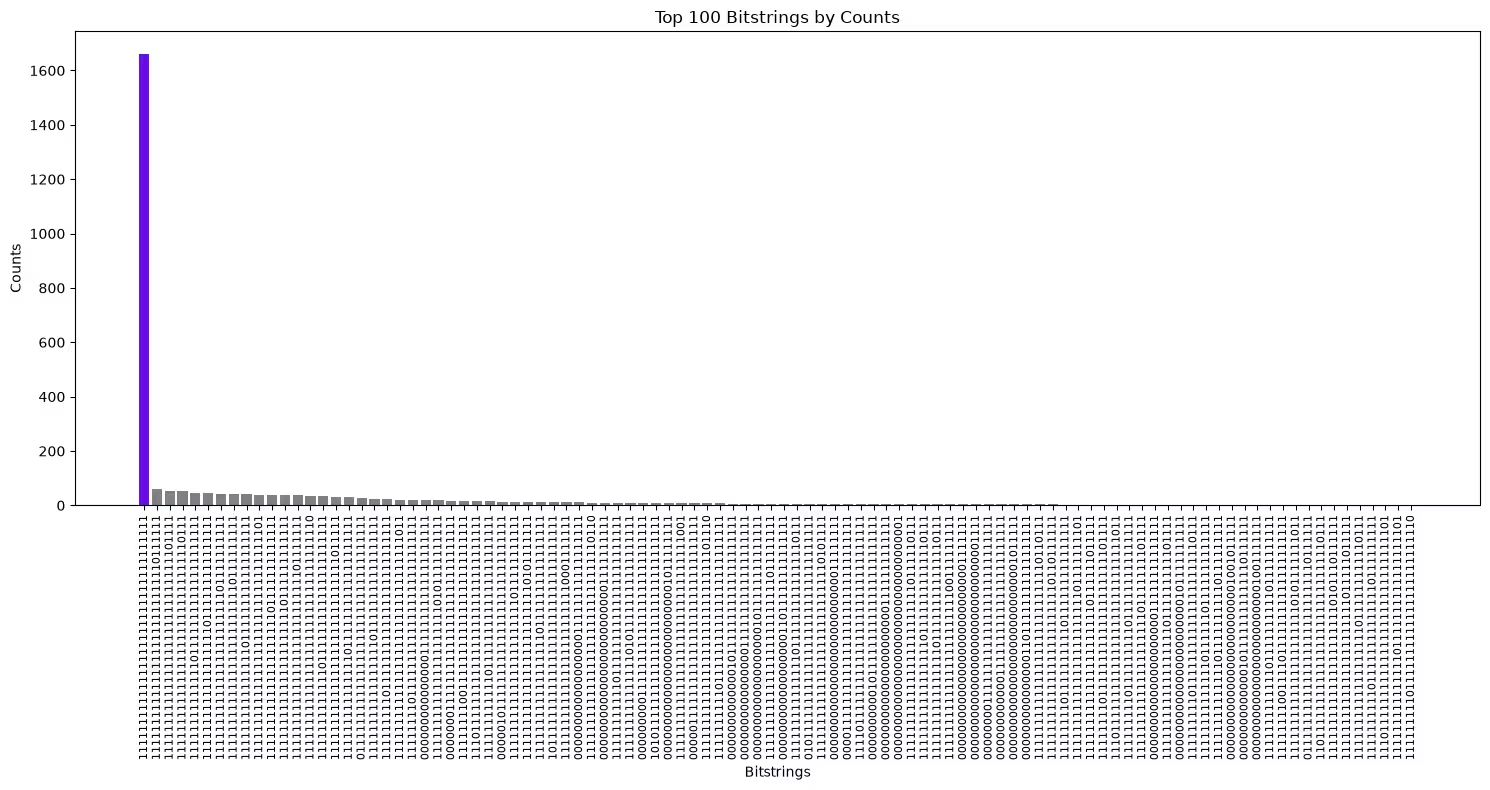
Plote a bitstring com o maior número de contagens para ver se a bitstring oculta foi a moda.
import matplotlib.pyplot as plt

def plot_top_bitstrings(counts_dict, hidden_bitstring=None):
    # Sort and take the top 100 bitstrings
    top_100 = sorted(counts_dict.items(), key=lambda x: x[1], reverse=True)[
        :100
    ]
    if not top_100:
        print("No bitstrings found in the input dictionary.")
        return

    # Unzip the bitstrings and their counts
    bitstrings, counts = zip(*top_100)

    # Assign colors: purple if the bitstring matches hidden_bitstring,
    # otherwise gray
    colors = [
        "#680CE9" if bit == hidden_bitstring else "gray" for bit in bitstrings
    ]

    # Create the bar plot
    plt.figure(figsize=(15, 8))
    plt.bar(
        range(len(bitstrings)), counts, tick_label=bitstrings, color=colors
    )

    # Rotate the bitstrings for better readability
    plt.xticks(rotation=90, fontsize=8)
    plt.xlabel("Bitstrings")
    plt.ylabel("Counts")
    plt.title("Top 100 Bitstrings by Counts")

    # Show the plot
    plt.tight_layout()
    plt.show()
A bitstring oculta é destacada em roxo, e deve ser a bitstring com o maior número de contagens.
plot_top_bitstrings(counts, hidden_bitstring)
Registro de alterações
-
2026-02-20: Aviso de descontinuação - o campo de metadados
provider_job_idsserá descontinuado em 30 dias na versão 0.13.0. Os usuários podem acessar o ID do job pelo métodojob_id()do serviço de runtime. -
2026-02-11: Adicionamos suporte para
ibm_miamie incluímos metadados de execução noPubResult.
Obter suporte
Para quaisquer dúvidas ou problemas, entre em contato com a Q-CTRL.
Próximos passos
-
Solicite acesso ao Q-CTRL Performance Management.
-
Visite a referência de API para esta Função Qiskit.
-
Experimente o tutorial Modelo de Ising de Campo Transverso com o Performance Management da Q-CTRL.
-
Experimente o tutorial Estimativa de Fase Quântica com as Qiskit Functions da Q-CTRL
-
Leia o estudo de caso da BlueQubit.