Simule a dinâmica de Fermi-Hubbard 1D com conjuntos de fluxo
As funções descritas neste guia estão atualmente disponíveis apenas na API Python. Uma funcionalidade equivalente será disponibilizada na API em C em uma versão futura.
Este guia constrói um circuito para a dinâmica temporal do modelo de Fermi-Hubbard unidimensional, desde escrever o hamiltoniano até verificar as densidades de sítio evoluídas. O que torna esse caminho interessante é uma única ideia, retirada do framework de conjuntos de fluxo de Gandon et al. [1], o trabalho que também motivou o TransferVertexOperator neste pacote:
Em vez de agrupar os termos do hamiltoniano depois do mapeamento férmion-para-qubit, agrupe-os antes dele, em conjuntos de fluxo, subconjuntos unidimensionais do grafo de interação fermiônico direcionado cujos operadores de transferência comutam entre si.
Essa escolha determina tudo o que vem a seguir. Ela exige o seguinte:
-
Uma codificação férmion-para-qubit personalizada feita sob medida para os conjuntos de fluxo, que aqui gasta um qubit ancilla para que o número de qubits associado à implementação de um dado termo do hamiltoniano deixe de crescer com o número de modos fermiônicos (como ocorre com Jordan-Wigner (JW)).
-
Uma síntese personalizada que explora a comutatividade dentro de cada conjunto. O ganho é um circuito cuja profundidade de dois qubits é constante em relação ao tamanho do sistema, contra o crescimento linear de uma trotterização termo a termo baseada em JW.
A maquinaria que coloca uma codificação própria no transpilador (CustomF2QLayout e MapperFnEvolutionSynthesis) vale para qualquer modelo.
O guia de transpilação para as etapas do transpilador citadas ao longo do texto, e o guia de mapeadores para a receita geral de escrita de um mapeador personalizado.
Operadores de transferência e conjuntos de fluxo
Um TransferVertexOperator é construído a partir de operadores de vértice e operadores de transferência . Em termos de operadores fermiônicos de criação e aniquilação,
então mede a ocupação do modo (vale quando vazio e quando preenchido), enquanto transfere um férmion ao longo da aresta direcionada . Observe que os dois índices de não são intercambiáveis. O primeiro índice carrega a combinação com sinal de menos e o segundo carrega a com sinal de mais, o que faz ser distinto de e dá à aresta sua orientação.
Eles satisfazem relações de comutação mistas. Dois operadores de transferência atuando em sítios disjuntos comutam trivialmente, já que cada um é um produto par de operadores fermiônicos. O caso interessante é um sítio compartilhado. Aí, os dois comutam se as setas fluem através desse sítio (uma chega, outra sai) e anticomutam se colidem (ambas chegam, ou ambas saem).
A regra é mais fácil de ver em uma imagem. Desenhar os vértices como nós e cada como uma seta de para dá o grafo de interação direcionado, aqui para a cadeia de quatro sítios usada ao longo deste guia, que traz as duas orientações de cada ligação:

Acompanhe a regra na figura. Veja e , por exemplo. Uma seta chega ao sítio 2 e a outra sai dele, então o férmion flui direto e os dois operadores comutam. Veja agora e . Ambas as setas apontam para o sítio 2. Elas colidem, e esses dois anticomutam.
É isso que torna os conjuntos de fluxo possíveis. Escolha um conjunto de setas formando um caminho direcionado e todo par ou se encontra cabeça com cauda ou não se encontra, de modo que o conjunto inteiro comuta, mesmo que os operadores individuais se sobreponham em sítios compartilhados. Evoluir sob um único conjunto de fluxo, portanto, não incorre em nenhum erro de Trotter e, como o passo 7 mostra, também pode ser feito com profundidade de circuito constante.
1. O hamiltoniano de Fermi-Hubbard
O modelo de Fermi-Hubbard 1D em sítios (sem spin, fronteiras abertas) é
Seguindo a Eq. (9) da Ref. [1], o termo de salto é . A interação é diagonal, então é expressa por meio de operadores de vértice usando :
Ambas as partes são construídas diretamente como um TransferVertexOperator. Observe que é armazenado como a entrada diagonal (j, j):
>>> from collections import defaultdict
>>> from qiskit_fermions.operators import TransferVertexOperator
>>>
>>> def fermi_hubbard_1d(num_sites, tunneling, interaction):
...     data: defaultdict[tuple[tuple[int, int], ...], complex] = defaultdict(complex)
...     for j in range(num_sites - 1):
...         k = j + 1
...         # hopping: -t (a^dag_j a_k + a^dag_k a_j) = t (T_jk + T_kj)
...         data[((j, k),)] += tunneling
...         data[((k, j),)] += tunneling
...         # interaction: U n_j n_k with n_j = (1 - V_j) / 2
...         data[()] += interaction / 4
...         data[((j, j),)] -= interaction / 4
...         data[((k, k),)] -= interaction / 4
...         data[((j, j), (k, k))] += interaction / 4
...     return TransferVertexOperator.from_dict(data)
>>>
>>> num_sites = 4
>>> hamiltonian = fermi_hubbard_1d(num_sites, tunneling=1.0, interaction=2.0)
>>> print(format(hamiltonian))
  1.500000e0 +0.000000e0j * ()
-5.000000e-1 +0.000000e0j * (V(0))
 5.000000e-1 +0.000000e0j * (V(0) V(1))
  1.000000e0 +0.000000e0j * (T(0,1))
  1.000000e0 +0.000000e0j * (T(1,0))
 -1.000000e0 +0.000000e0j * (V(1))
 5.000000e-1 +0.000000e0j * (V(1) V(2))
  1.000000e0 +0.000000e0j * (T(1,2))
  1.000000e0 +0.000000e0j * (T(2,1))
 -1.000000e0 +0.000000e0j * (V(2))
 5.000000e-1 +0.000000e0j * (V(2) V(3))
  1.000000e0 +0.000000e0j * (T(2,3))
  1.000000e0 +0.000000e0j * (T(3,2))
-5.000000e-1 +0.000000e0j * (V(3))
Os sítios interiores ganham um coeficiente de em porque aparecem em duas ligações, enquanto os sítios de borda aparecem em apenas uma. Cada termo listado aqui aparece no grafo desenhado acima. Os termos T(j,k) são suas setas, e os termos V(j) seus nós.
2. Particione em conjuntos de fluxo
Em seguida, rotule cada termo com o conjunto de fluxo ao qual ele pertence. O atributo groups existe para esse fim. Uma porta Evolution sobre um operador agrupado se decompõe em uma Evolution por grupo (o passo 6 coloca isso em prática), então o agrupamento decidido aqui no nível fermiônico sobrevive no circuito.
Para a cadeia 1D, os dois conjuntos de fluxo de salto são as setas orientadas a leste () e as setas orientadas a oeste (). Os termos de interação diagonais comutam com tudo que é diagonal e formam um terceiro grupo:
>>> def flow_set_groups(operator):
...     groups = []
...     for terms, _ in operator.iter_terms():
...         match terms:
...             case [(left, right)] if right == left + 1:
...                 groups.append(0)  # east-oriented: T_{j,j+1}
...             case [(left, right)] if right == left - 1:
...                 groups.append(1)  # west-oriented: T_{j+1,j}
...             case _:
...                 groups.append(2)  # diagonal interaction terms
...     return groups
>>>
>>> hamiltonian.groups = flow_set_groups(hamiltonian)
>>> hamiltonian.num_groups()
3
>>> for index, group in enumerate(hamiltonian.split_out_groups()):
...     print(index, sorted(terms for terms, _ in group.iter_terms()))
0 [[(0, 1)], [(1, 2)], [(2, 3)]]
1 [[(1, 0)], [(2, 1)], [(3, 2)]]
2 [[], [(0, 0)], [(0, 0), (1, 1)], [(1, 1)], [(1, 1), (2, 2)], [(2, 2)], [(2, 2), (3, 3)], [(3, 3)]]
Os grupos 0 e 1 são os dois conjuntos de fluxo. Cada conjunto é um caminho direcionado ao longo da cadeia, então, pela propriedade de fluxo, todos os termos dentro de um grupo comutam.
Cada grupo também precisa ser hermitiano por si só, já que uma fórmula de produto exponencia os grupos separadamente e apenas um fator hermitiano tem evolução unitária. groups_are_hermitian() confirma isso:
>>> from qiskit_fermions.operators.terms.grouping import groups_are_hermitian
>>>
>>> groups_are_hermitian(hamiltonian)
[True, True, True]
Vale a pena parar aqui, porque os dois grupos de salto são unidirecionais: o grupo 0 contém apenas termos orientados a leste e o grupo 1 apenas termos orientados a oeste. Dividir um hamiltoniano assim normalmente quebraria a hermiticidade, já que precisa de seu parceiro conjugado ao lado. Um TransferVertexOperator evita o problema porque já é hermitiano por si só. Ele é um produto de dois operadores de Majorana (veja sua definição no passo 1), não um puro, então sua imagem de Jordan-Wigner carrega um coeficiente real em vez de imaginário. Escolher essa representação de operador é, portanto, o que faz de um conjunto de fluxo unidirecional um fator de Trotter legítimo.
Os rótulos leste/oeste usados ao longo deste guia são geométricos, com a cadeia desenhada da esquerda para a direita e os índices de modo crescendo nessa direção; aponta para leste e aponta para oeste. A Ref. [1] é internamente inconsistente nessa nomenclatura (o texto e as figuras divergem), então este guia deliberadamente não segue o texto e mantém os rótulos da figura. Ao cruzar a leitura com o artigo, associe os conjuntos de fluxo pelos seus pesos de Pauli (1 e 3 abaixo), não pelas palavras da bússola.
3. Escreva a codificação personalizada
A Seção IV B da Ref. [1] classifica as formas que uma codificação férmion-para-qubit local pode assumir quando restrita a um conjunto de fluxo. O Jordan-Wigner simples usa qubits e mapeia cada termo de salto para um Pauli de peso 2. A classificação mostra que gastar qubits extras compra estrutura nos operadores codificados.
A codificação implementada aqui é a construção de paridade deslocalizada do Apêndice B 2 (equações B4 e B5), que usa um qubit ancilla, então . A paridade fermiônica é deslocalizada entre um par de qubits:
O índice na última expressão força o qubit extra. A última ligação da cadeia tem , então seu cai no qubit , um além do último modo fermiônico . Esse qubit final é o ancilla, e é por isso que e não . O mesmo alcance aparece em , cujo está no ancilla para .
O ganho é visível de imediato; um conjunto de fluxo inteiro é mapeado para uma soma de Paulis de peso 1.
Os prefatores são fixados pela normalização , e o sinal de menos relativo entre as duas orientações é fixado pela identidade de produto , que os Paulis acima satisfazem. Errar qualquer um dos dois gera um operador que obedece às relações de comutação mas não representa mais o mesmo hamiltoniano, então você deve verificar a codificação numericamente, como mostrado no passo 4.
Escrever a codificação significa escrever uma função que mapeia um único operador de transferência generalizado para uma string de Pauli; map_transfer_vertex_generators() cuida da iteração sobre os termos e de sua composição:
>>> from qiskit.quantum_info import SparseObservable
>>> from qiskit_fermions.mappers import map_transfer_vertex_generators
>>>
>>> def flow_set_action(action, num_qubits):
...     match action:
...         case (j, k) if j == k:
...             # vertex operator: V_j = Z_j Z_{j+1}
...             return SparseObservable.from_sparse_list(
...                 [("ZZ", [j, j + 1], 1.0)], num_qubits=num_qubits
...             )
...         case (j, k) if k == j + 1:
...             # east-oriented transfer operator: weight 1
...             return SparseObservable.from_sparse_list(
...                 [("X", [k], -0.5)], num_qubits=num_qubits
...             )
...         case (j, k) if k == j - 1:
...             # west-oriented transfer operator: weight 3
...             return SparseObservable.from_sparse_list(
...                 [("ZXZ", [k, k + 1, k + 2], 0.5)], num_qubits=num_qubits
...             )
...         case _:
...             raise ValueError(f"not a nearest-neighbor transfer operator: {action}")
>>>
>>> def flow_set_encoding(operator, num_qubits):
...     return map_transfer_vertex_generators(
...         operator,
...         lambda action: flow_set_action(action, num_qubits),
...         identity=lambda: SparseObservable.identity(num_qubits),
...         compose=SparseObservable.compose,
...     ).simplify()
MapperFnEvolutionSynthesis.mapper_fn espera a assinatura (operator, num_qubits), e o tipo de retorno deve ser um SparseObservable, o que torna a função diretamente utilizável como plugin do transpilador. Veja o passo 6.
Aplicá-la ao hamiltoniano do passo 1 dá o operador codificado em qubits:
>>> num_qubits = num_sites + 1
>>> encoded = flow_set_encoding(hamiltonian, num_qubits)
>>> for label, indices, coeff in sorted(encoded.to_sparse_list()):
...     print(f"{label:3s} {str(indices):12s} {coeff.real:+.2f}")
    []           +1.50
X   [1]          -0.50
X   [2]          -0.50
X   [3]          -0.50
ZXZ [0, 1, 2]    +0.50
ZXZ [1, 2, 3]    +0.50
ZXZ [2, 3, 4]    +0.50
ZZ  [0, 1]       -0.50
ZZ  [0, 2]       +0.50
ZZ  [1, 2]       -1.00
ZZ  [1, 3]       +0.50
ZZ  [2, 3]       -1.00
ZZ  [2, 4]       +0.50
ZZ  [3, 4]       -0.50
Há 14 termos, em três formas: o salto virou X e ZXZ, a interação ZZ, e o [] inicial é a identidade, que contribui apenas com uma fase global. Observe que os termos ZZ alcançam vizinhos próximos e segundos vizinhos; abrange os qubits a , que é o custo de deslocalizar a paridade.
Agrupar por conjunto de fluxo expõe a assimetria que a construção traz. Liste os pesos de Pauli presentes em cada grupo:
>>> for index, group in enumerate(hamiltonian.split_out_groups()):
...     weights = {len(indices) for _, indices, _ in flow_set_encoding(group, num_qubits).to_sparse_list()}
...     print(index, sorted(weights))
0 [1]
1 [3]
2 [0, 2]
O conjunto de fluxo orientado a leste (grupo 0) consiste inteiramente de Paulis de peso 1. Sua evolução temporal é, portanto, uma camada de rotações de um qubit e não precisa de nenhuma porta de emaranhamento, enquanto no Jordan-Wigner todo termo de salto tem peso 2 e as exige. Esse é o compromisso espaço-tempo da Ref. [1] em sua forma mais simples: um qubit extra converte metade do hamiltoniano de salto em rotações de um qubit.
O conjunto de fluxo orientado a oeste (grupo 1) paga por isso com peso três, e a interação (grupo 2) fica no peso dois, onde a entrada de peso zero é a identidade. Nada disso é ainda uma afirmação sobre circuitos; o que uma síntese faz com esses pesos é o assunto dos passos 6 e 7.
4. Verifique a codificação
Uma codificação personalizada só é útil se for fiel, e uma escrita à mão deve ser verificada. Como essa codificação usa qubits, o espaço de Hilbert dos qubits é duas vezes maior que o fermiônico, então o hamiltoniano codificado não pode ser igual ao de Jordan-Wigner termo a termo. Os dois se relacionam por uma isometria.
De onde vem a isometria: No Jordan-Wigner, um estado de base é a string de ocupação; o qubit guarda . Esta codificação, em vez disso, armazena paridades cumulativas. Defina
de modo que o bit registra a paridade de todas as ocupações até o sítio , inclusive. Há desses bits para ocupações, e é daí que vem o ancilla. A ocupação é recuperada como a diferença entre bits vizinhos, . Um sítio ocupado aparece, portanto, como uma parede de domínio entre dois bits adjacentes, e é por isso que esta é chamada de codificação de parede de domínio (ou Kramers-Wannier). Também é por isso que : o produto de dois s vizinhos lê essa diferença.
Escrever esse mapeamento para alguns estados deixa a estrutura concreta (note que é fixo, então apenas metade dos estados de Qubit de está na imagem, e por isso temos uma isometria e não uma unitária):
>>> def domain_wall_bits(occupations):
...     parity = 0
...     bits = [0]
...     for occupation in occupations:
...         parity ^= occupation
...         bits.append(parity)
...     return bits
>>>
>>> for occupations in ([0, 0, 0, 0], [1, 0, 0, 0], [1, 1, 0, 0], [1, 0, 1, 0]):
...     bits = domain_wall_bits(occupations)
...     # little-endian: reversed() prints qubit 0 on the right, as Qiskit labels do
...     print("".join(map(str, occupations)), "->", "".join(str(b) for b in reversed(bits)))
0000 -> 00000
1000 -> 11110
1100 -> 00010
1010 -> 00110
Um único férmion no sítio 0 inverte toda paridade cumulativa acima dele, que é a deslocalização em ação. Reunindo essas colunas em uma matriz, obtemos a isometria , e a codificação é fiel quando entrelaça os dois Hamiltonianos:
Ou seja, mapear um estado fermiônico para o espaço de Qubits e depois evoluí-lo ali deve dar o mesmo resultado que evoluí-lo primeiro no espaço fermiônico e mapear depois.
>>> import numpy as np
>>> from qiskit.quantum_info import SparsePauliOp
>>> from qiskit_fermions.mappers.library import transfer_vertex_jordan_wigner
>>>
>>> def to_matrix(observable):
...     # SparseObservable carries no dense-matrix method, so route through
...     # SparsePauliOp. This is only ever needed for the checks below --
...     # the encoding itself never leaves SparseObservable.
...     return SparsePauliOp.from_sparse_observable(observable).to_matrix()
>>>
>>> def domain_wall_isometry(num_sites):
...     isometry = np.zeros((2 ** (num_sites + 1), 2**num_sites), dtype=complex)
...     for index in range(2**num_sites):
...         occupations = [(index >> j) & 1 for j in range(num_sites)]
...         bits = domain_wall_bits(occupations)
...         isometry[sum(b << j for j, b in enumerate(bits)), index] = 1.0
...     return isometry
>>>
>>> isometry = domain_wall_isometry(num_sites)
>>> np.allclose(isometry.conj().T @ isometry, np.eye(2**num_sites))
True
>>>
>>> def intertwines(operator):
...     """Whether both mappings of `operator` agree through the isometry."""
...     flow = to_matrix(flow_set_encoding(operator, num_qubits))
...     reference = to_matrix(transfer_vertex_jordan_wigner(operator, num_sites).simplify())
...     return np.allclose(flow @ isometry, isometry @ reference)
>>>
>>> intertwines(hamiltonian)
True
>>> # and, more strongly, once per flow set: a product formula evolves the groups
>>> # separately, so each one has to be intertwined on its own
>>> all(intertwines(group) for group in hamiltonian.split_out_groups())
True
A relação de entrelaçamento vale exatamente, e separadamente para cada conjunto de fluxo. Essa segunda afirmação, mais forte, é a que as etapas seguintes usam: uma fórmula de produto evolui os grupos um de cada vez, e um produto de fatores entrelaçados também é entrelaçado, então qualquer aproximação construída a partir desses grupos concorda entre as duas codificações, mesmo que as codificações sejam diferentes. Como corolário, os espectros devem concordar, com cada autovalor de Jordan-Wigner aparecendo duas vezes no espaço maior, uma vez para cada valor da paridade global sem restrição:
>>> jw_matrix = to_matrix(transfer_vertex_jordan_wigner(hamiltonian, num_sites).simplify())
>>> flow_matrix = to_matrix(flow_set_encoding(hamiltonian, num_qubits))
>>>
>>> jw_spectrum = np.linalg.eigvalsh(jw_matrix)
>>> flow_spectrum = np.linalg.eigvalsh(flow_matrix)
>>> np.allclose(
...     np.sort(flow_spectrum),
...     np.sort(np.concatenate([jw_spectrum, jw_spectrum])),
... )
True
>>> print(f"{jw_spectrum[0]:.10f}  {flow_spectrum[0]:.10f}")
-1.8557725066  -1.8557725066
5. Construa o circuito fermiônico
Antes de envolver qualquer Qubit, a dinâmica é expressa no nível fermiônico. Um FermionicCircuit atua sobre modos fermiônicos em vez de Qubits, e uma porta Evolution sobre o Hamiltoniano é o circuito inteiro:
>>> from qiskit_fermions.circuit import FermionicCircuit
>>> from qiskit_fermions.circuit.library import Evolution
>>> from qiskit_fermions.circuit.library.synthesis import FermionicLieTrotter
>>>
>>> total_time = 1.0
>>> circuit = FermionicCircuit(num_sites)
>>> circuit.append(
...     Evolution(
...         num_sites, hamiltonian, time=total_time, synthesis=FermionicLieTrotter()
...     ),
...     circuit.modes,
... )
>>> circuit.draw("mpl")
<Figure size ... with 1 Axes>

Há uma caixa opaca sobre os quatro modos, e a parte interessante é no que ela se decompõe. O argumento synthesis diz como: FermionicLieTrotter é a fórmula de produto de primeira ordem, que divide o operador por seus groups e evolui cada grupo em sequência. Assim, a partição em conjuntos de fluxo da etapa 2 é a Trotterização, e um único decompose() a executa, gerando uma porta Evolution por conjunto de fluxo na ordem dos grupos: leste, oeste e depois a interação diagonal, com 3, 3 e 8 termos, respectivamente.
>>> flow_set_circuit = circuit.decompose()
>>> flow_set_circuit.draw("mpl")
<Figure size ... with 1 Axes>
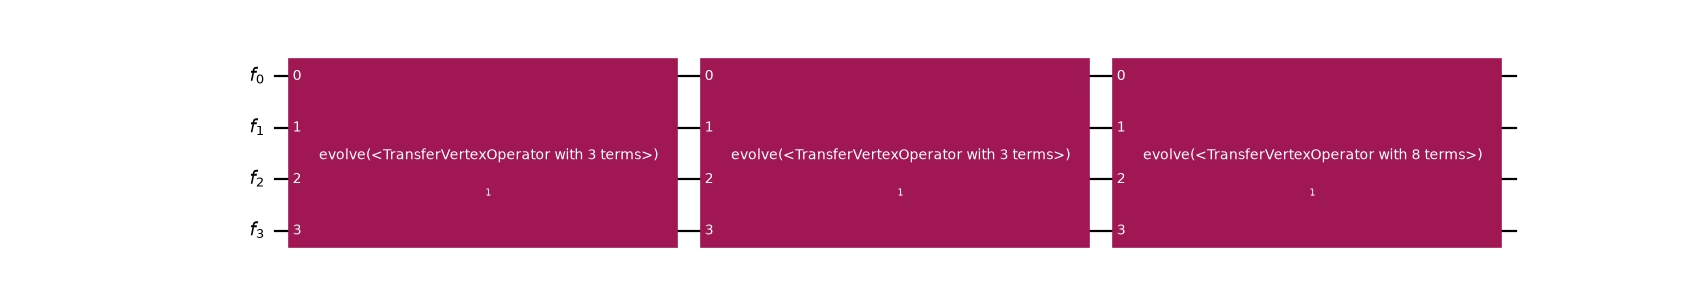
Note que isso acontece inteiramente no espaço fermiônico: nenhum Qubit foi mencionado ainda, e a aproximação já foi feita. O número de passos de Trotter pertence, portanto, a este ponto também, como reps, que divide o tempo e repete a varredura inteira:
>>> def trotter_steps(reps):
...     step = FermionicCircuit(num_sites)
...     step.append(
...         Evolution(
...             num_sites,
...             hamiltonian,
...             time=total_time,
...             synthesis=FermionicLieTrotter(reps=reps),
...         ),
...         step.modes,
...     )
...     return step.decompose()
>>>
>>> trotter_steps(3).count_ops()["Evolution"]
9
Nove portas: os três conjuntos de fluxo, percorridos três vezes, cada uma com um terço do tempo. Essa alternância é o que faz disso uma Trotterização e não uma simples fatiação de um grupo. Repetir um único grupo não conseguiria nada, já que exponenciais consecutivas do mesmo operador comutam, então A(t/3) A(t/3) A(t/3) é simplesmente A(t). Uma fórmula que lê os grupos pode intercalá-los; uma aplicada depois do mapeamento não pode, porque o agrupamento já se perdeu.
Esta é a etapa que faz o agrupamento importar. Cada porta emitida é mapeada e sintetizada de forma independente, então tudo o que vem depois atua sobre a partição decidida no nível fermiônico. Pular a decomposição entrega o operador inteiro à próxima etapa, e o agrupamento é ignorado.
6. Transpile com a codificação personalizada
A codificação agora está pronta para ser usada pelo transpilador. São necessárias mais duas peças:
-
Um layout. O
TrivialF2QLayoutpadrão assume um Qubit por modo, o que está errado nesta situação. OCustomF2QLayoutassocia o registrador fermiônico a umQuantumRegisterde tamanho diferente, que é a forma como os Qubits ancilla entram no pipeline. -
Um plugin de síntese. O
MapperFnEvolutionSynthesisrecebe diretamente a função de mapeamento, mapeia com ela o Hamiltoniano da portaEvolutione emite umaPauliEvolutionGate, preservando a convenção . Seuproduct_formuladecide como essa porta é convertida em rotações. Note que esta é uma segunda fórmula de produto, independente, que atua sobre Qubits depois do mapeamento: aqui é passado oLieTrotterdo Qiskit, e a etapa 7 o substitui por um que conhece os conjuntos de fluxo.
Como toda comparação abaixo reexecuta esse pipeline, vale encapsulá-lo uma vez:
>>> from qiskit.circuit import QuantumRegister
>>> from qiskit.passmanager import MultiStagePassManager
>>> from qiskit_fermions.transpiler import FermionicCircuitToDAG, QuantumDAGToCircuit
>>> from qiskit_fermions.transpiler.passes import (
...     CustomF2QLayout,
...     F2QSynthesis,
...     MapperFnEvolutionSynthesis,
... )
>>>
>>> def flow_set_pass_manager(mode_register, product_formula=None):
...     '''Build the pipeline mapping `mode_register` with the flow-set encoding.'''
...     synthesis = F2QSynthesis()
...     synthesis.methods["Evolution"] = MapperFnEvolutionSynthesis(
...         flow_set_encoding, product_formula=product_formula
...     )
...     # this encoding spends one ancilla on top of the fermionic modes
...     qubit_register = QuantumRegister(mode_register.size + 1, "q")
...     return MultiStagePassManager(
...         input=FermionicCircuitToDAG(),
...         layout=CustomF2QLayout({mode_register: qubit_register}),
...         synthesis=synthesis,
...         output=QuantumDAGToCircuit(),
...     )
>>>
>>> from qiskit.synthesis import LieTrotter
>>>
>>> pass_manager = flow_set_pass_manager(flow_set_circuit.register, LieTrotter())
>>> qubit_circuit = pass_manager.run(flow_set_circuit)
>>> qubit_circuit.num_qubits
5
Quatro modos fermiônicos se tornaram um circuito de cinco Qubits, com o ancilla fornecido pelo layout personalizado.
Agora veja o que o circuito resultante realmente contém. Decompor repetidamente reduz as portas de evolução até U e CX, de modo que o custo de dois Qubits das duas estratégias de síntese comparadas abaixo seja medido na mesma moeda: count_ops() então informa a contagem de CX, e depth() aceita uma função de filtro para medir a profundidade de dois Qubits. Note que este reps é uma profundidade de decomposição, sem relação com o número de passos de Trotter de uma fórmula de produto, que mais adiante neste guia também se chama reps:
>>> decomposed = qubit_circuit.decompose(reps=6)
>>> decomposed.count_ops()["cx"]
26
>>> decomposed.depth(lambda instruction: len(instruction.qubits) == 2)
23
Vinte e seis portas CX em vinte e três camadas, então quase nada roda em paralelo. Desenhar o circuito mostra o porquê:
>>> decomposed.draw("mpl", fold=-1)
<Figure size ... with 1 Axes>
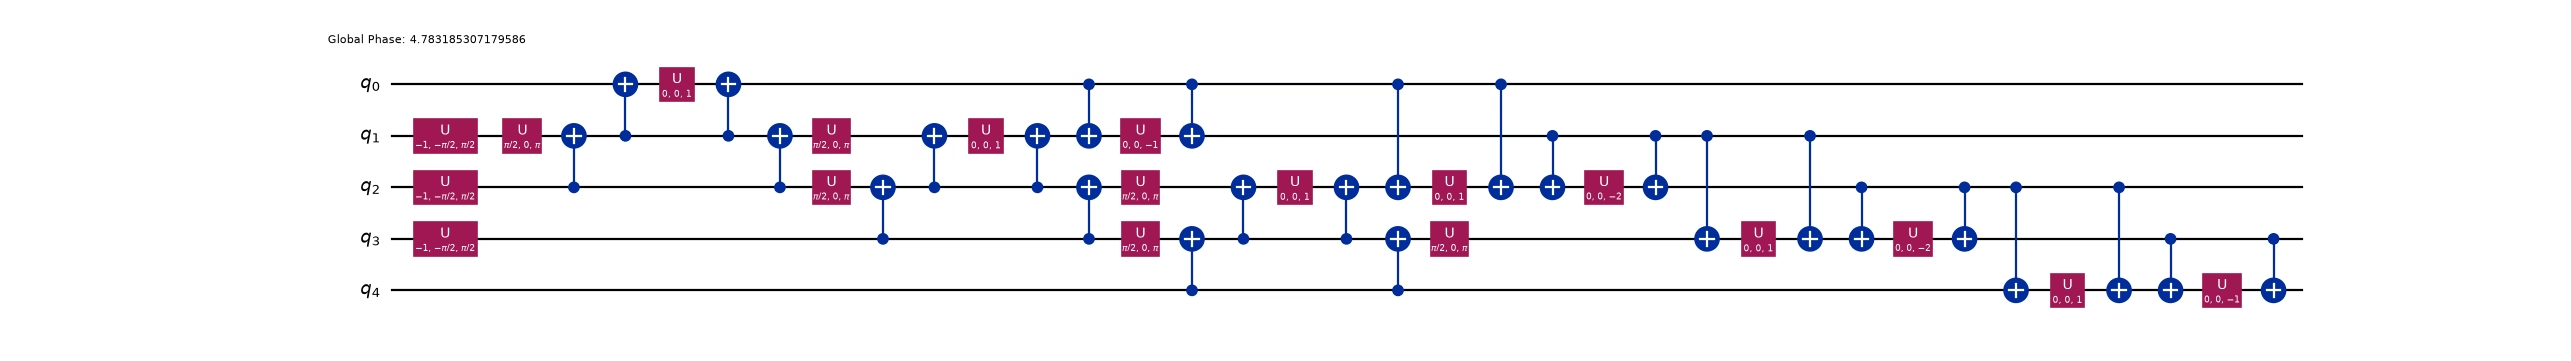
Cada termo foi compilado isoladamente: uma mudança de base, uma escada de CX até uma única rotação, e depois a escada é desfeita. O conjunto de fluxo de peso 1 é gratuito; seus termos são rotações isoladas, sem escada ao redor, mas cada termo de peso 3 custa quatro portas CX, e como as escadas são emitidas em sequência, nada se sobrepõe.
Assim, o agrupamento sobrevive ao pipeline inteiro (três conjuntos de fluxo, três PauliEvolutionGates mapeadas) e ainda assim rende quase nada. A Trotterização fermiônica da etapa 5 cumpriu seu papel; o que a desperdiça é a fórmula do lado dos Qubits. O LieTrotter recebe um conjunto de termos sobre o qual por acaso não sabe nada, e compila cada um isoladamente. Ele não tem como saber que eles comutam entre si, então serializa o que poderia compartilhar uma mudança de base.
Essa é a lacuna que esta codificação existe para fechar: duas fórmulas de produto estão em ação, e até agora só a fermiônica recebeu a estrutura. A próxima etapa fornece uma síntese do lado dos Qubits que também a aproveita.
7. Uma síntese que conhece os conjuntos de fluxo
Recuperar a vantagem significa informar a síntese do lado dos Qubits sobre a estrutura. Esta é a Seção IV C da Ref. [1]: como todos os termos de um conjunto de fluxo comutam, eles podem ser diagonalizados simultaneamente por um único circuito de Clifford, rotacionados em uma base compartilhada e rotacionados de volta, em vez de uma vez por termo.
Para esta codificação, o Clifford é simples. Conjugar por uma cadeia de portas CZ entre vizinhos mais próximos mapeia
simultaneamente para todo . Uma cadeia de CZ transforma todo o conjunto de fluxo de peso 3 (oeste) em uma camada de rotações independentes de um único Qubit. A interface EvolutionSynthesis exige apenas um método synthesize(), que é tudo o que esta classe implementa. Ela não carrega número de passos de Trotter, porque recebe um conjunto de fluxo por vez e, portanto, não pode subdividir a evolução entre os conjuntos. Essa subdivisão pertence a um nível acima, no espaço fermiônico, onde um F2FSynthesisPlugin vê todos eles de uma vez (veja a etapa 9):
>>> from qiskit.circuit import QuantumCircuit
>>> from qiskit.synthesis.evolution import EvolutionSynthesis
>>>
>>> def cz_brickwork(circuit):
...     # emit even and odd bonds as two layers, so the CZs are scheduled in
...     # parallel: a chain of overlapping CZs has depth 2, not num_qubits - 1
...     #
...     # NOTE: CZ gates are diagonal, so they all commute and each is its own inverse.
...     # This whole layer is therefore self-inverse, which is why the conjugation below
...     # calls it twice rather than calling it and then its inverse.
...     for offset in (0, 1):
...         for j in range(offset, circuit.num_qubits - 1, 2):
...             circuit.cz(j, j + 1)
>>>
>>> # The interaction reaches nearest (distance 1) and next-nearest (distance 2)
>>> # neighbors, so every interior qubit carries four Rzz gates and can only do one at
>>> # a time: four layers is the best any schedule can do. These offsets achieve it.
>>> def rzz_layers(circuit, angles):
...     """Emit the diagonal Rzz gates in four layers of disjoint qubit pairs."""
...     near = [(j, k) for j, k in angles if k - j == 1]
...     far = [(j, k) for j, k in angles if k - j == 2]
...     schedule = [
...         [(j, k) for j, k in near if j % 2 == 0],
...         [(j, k) for j, k in far if j % 4 in (0, 1)],
...         [(j, k) for j, k in near if j % 2 == 1],
...         [(j, k) for j, k in far if j % 4 in (2, 3)],
...     ]
...     # emit layer by layer, since Qiskit's depth follows the order gates were added
...     for layer in schedule:
...         for j, k in layer:
...             circuit.rzz(angles[j, k], j, k)
>>>
>>> class FlowSetSynthesis(EvolutionSynthesis):
...     '''Synthesize one flow set of the encoded Hamiltonian at a time.'''
...
...     preserve_order = True
...
...     def synthesize(self, evolution):
...         circuit = QuantumCircuit(evolution.operator.num_qubits)
...         east, west, diagonal = [], [], {}
...
...         for label, indices, coeff in evolution.operator.to_sparse_list():
...             angle = 2 * evolution.time * coeff.real
...             match label, indices:
...                 case "", _:  # the identity contributes only a global phase
...                     circuit.global_phase -= angle / 2
...                 case "X", [qubit]:  # east flow set: already weight-1
...                     east.append((qubit, angle))
...                 case "ZXZ", [j, k, l] if (k, l) == (j + 1, j + 2):
...                     west.append((k, angle))  # needs the CZ conjugation below
...                 case "ZZ", [j, k]:  # interaction: diagonal, see rzz_layers above
...                     diagonal[min(j, k), max(j, k)] = angle
...                 case _:
...                     raise ValueError(f"unexpected Pauli term: {label} on {indices}")
...
...         # east flow set: bare rotations, no entangling gates at all
...         for qubit, angle in east:
...             circuit.rx(angle, qubit)
...
...         # west flow set: one CZ chain diagonalizes the WHOLE set at once
...         if west:
...             cz_brickwork(circuit)
...             for qubit, angle in west:
...                 circuit.rx(angle, qubit)
...             cz_brickwork(circuit)
...
...         if diagonal:
...             rzz_layers(circuit, diagonal)
...
...         return circuit
Dois detalhes passam facilmente despercebidos. Uma EvolutionSynthesis personalizada deve expor um atributo preserve_order, que o passo de síntese de alto nível lê.
Ambos os auxiliares emitem suas portas em camadas explícitas, e não na ordem dos termos, porque depth() agenda as portas o mais cedo possível, na ordem em que foram adicionadas. Como todas as portas dentro de um desses conjuntos comutam, a ordem pode ser escolhida livremente. Uma síntese termo a termo escolhe mal a ordem. Emitir a cadeia de CZ sobreposta em sequência informa uma profundidade que cresce com o número de Qubits, em vez da constante 2 que o hardware poderia alcançar.
É por isso que a síntese acima não carrega número de passos de Trotter. Ela recebe um conjunto de fluxo por porta, então uma repetição dentro dela repetiria dentro de um conjunto, em vez de alternar entre eles:
repeating within one set:      A(t/2) A(t/2) B(t/2) B(t/2)
what a Trotterization needs:   A(t/2) B(t/2) A(t/2) B(t/2)
A primeira forma não rende nada: exponenciais consecutivas do mesmo operador comutam, então A(t/2) A(t/2) é simplesmente A(t) e o erro permanece no valor de um passo, não importa quantos passos sejam pedidos.
O número de passos pertence, portanto, ao FermionicLieTrotter fermiônico da etapa 5, que lê os groups e pode intercalá-los. Essa divisão de trabalho é o ponto central: a fórmula fermiônica decide quantos passos e em que ordem, e esta classe decide quão barato é realizar cada conjunto resultante.
Para selecionar a ordem, passe-a para MapperFnEvolutionSynthesis.product_formula, que é o argumento que flow_set_pass_manager recebe. Nada mais no pipeline (nem no circuito fermiônico que ele executa) muda:
>>> pass_manager = flow_set_pass_manager(flow_set_circuit.register, FlowSetSynthesis())
>>>
>>> flow_circuit = pass_manager.run(flow_set_circuit).decompose(reps=6)
>>> flow_circuit.count_ops()["cx"]
22
>>> flow_circuit.depth(lambda instruction: len(instruction.qubits) == 2)
12
>>> flow_circuit.draw("mpl", fold=-1)
<Figure size ... with 1 Axes>
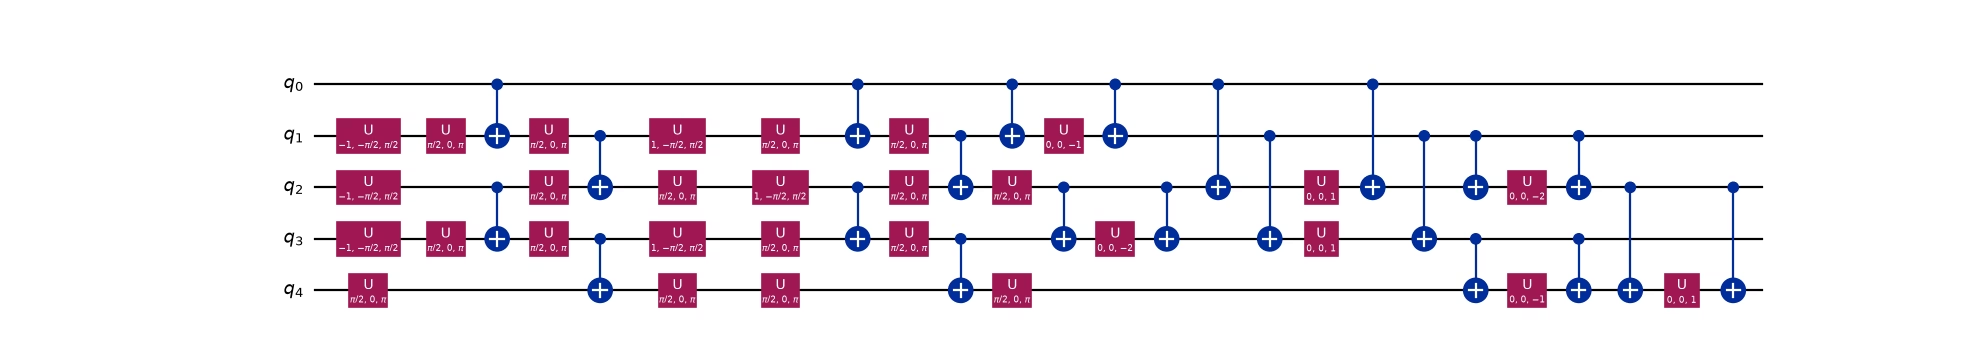
De profundidade 23 com 26 portas CX para profundidade 12 com 22 portas CX. Note que são menos portas de emaranhamento e quase metade da profundidade. Comparando as duas imagens, a diferença não é que as portas sejam mais baratas, mas que elas se empilham. As escadas seriais sumiram; as portas de emaranhamento agora ficam umas sobre as outras em camadas compartilhadas, porque todo o conjunto de fluxo oeste é rotacionado em uma única base compartilhada e a interação é emitida em camadas de pares disjuntos.
FlowSetSynthesis faz correspondência de padrões com índices de Qubit absolutos, o que aqui só é seguro porque todo conjunto de fluxo deste Hamiltoniano abrange o registrador inteiro. Uma fórmula de produto fermiônica restringe cada fator aos modos que ele realmente toca, então um agrupamento cujos conjuntos cobrissem apenas parte da cadeia chegaria renumerado e os padrões acima não corresponderiam.
Ambos os desenhos mostram o circuito após decompose(reps=6), que reescreve tudo na base U e CX, então as portas CZ, Rx e Rzz emitidas por FlowSetSynthesis não são visíveis como tais. Isso é deliberado: coloca os dois circuitos na mesma base, que é a única forma de as contagens e profundidades de dois Qubits acima serem comparáveis. O que importa nestas figuras é a estrutura de camadas, não os rótulos das portas.
8. Profundidade constante em escala
A pergunta interessante não é a contagem com quatro modos, mas como ela escala. As duas camadas de CZ em padrão de tijolos não crescem com o comprimento da cadeia, então a profundidade de dois Qubits de um passo de Trotter deve ser constante. Medindo isso diretamente no Hamiltoniano completo de Fermi-Hubbard, muito além do que poderia ser simulado por força bruta:
>>> def evolution_stats(num_sites, product_formula):
...     operator = fermi_hubbard_1d(num_sites, tunneling=1.0, interaction=2.0)
...     operator.groups = flow_set_groups(operator)
...
...     circuit = FermionicCircuit(num_sites)
...     circuit.append(
...         Evolution(
...             num_sites, operator, time=total_time, synthesis=FermionicLieTrotter()
...         ),
...         circuit.modes,
...     )
...     circuit = circuit.decompose()  # one Evolution per flow set, as in step 5
...
...     pass_manager = flow_set_pass_manager(circuit.register, product_formula)
...     decomposed = pass_manager.run(circuit).decompose(reps=6)
...     two_qubit = lambda instruction: len(instruction.qubits) == 2
...     return decomposed.count_ops()["cx"], decomposed.depth(two_qubit)
>>>
>>> sites = [4, 10, 20, 50, 100]
>>> flow = [evolution_stats(n, FlowSetSynthesis()) for n in sites]
>>> lie_trotter = [evolution_stats(n, LieTrotter()) for n in sites]
>>>
>>> [depth for _, depth in flow]
[12, 12, 12, 12, 12]
>>> [depth for _, depth in lie_trotter]
[23, 47, 87, 207, 407]
A profundidade de dois Qubits permanece em 12 de quatro modos até 100, enquanto o LieTrotter cresce linearmente até 407. Os conjuntos de fluxo permitem paralelizar um pouco dentro do pipeline, mas cada conjunto ainda é Trotterizado termo a termo, então o crescimento é apenas retardado, não eliminado:
>>> import matplotlib.pyplot as plt
>>>
>>> figure, axes = plt.subplots(1, 2, figsize=(9, 3.5), layout="constrained")
>>> for panel, index, title in zip(axes, (1, 0), ("two-qubit depth", "CX count")):
...     _ = panel.plot(sites, [stat[index] for stat in lie_trotter], "o-", label="qubit-level")
...     _ = panel.plot(sites, [stat[index] for stat in flow], "s-", label="flow set")
...     _ = panel.set(xlabel="modes", title=title)
...     _ = panel.legend()
>>> figure
<Figure size ... with 2 Axes>

A contagem de portas cresce linearmente nos dois casos (há termos a aplicar, e isso é inevitável), mas a síntese por conjuntos de fluxo as aplica em um número constante de camadas paralelas. Este é o resultado de profundidade constante da Ref. [1].
A profundidade 12 se divide entre os três conjuntos de fluxo como 0 + 4 + 8, em qualquer comprimento de cadeia. O conjunto de fluxo leste contribui com zero; são rotações Rx puras. O conjunto de fluxo oeste custa 4, das duas camadas de CZ em padrão de tijolos na entrada e das duas na saída; descartar a interação deixa uma profundidade de dois Qubits de quatro em qualquer comprimento de cadeia. Os oito restantes são a interação, cujos termos Rzz atuam sobre vizinhos próximos e também sobre os próximos vizinhos e, por isso, precisam de quatro camadas disjuntas, cada uma custando duas portas CX. Quatro é o ótimo aqui: todo Qubit interior carrega quatro portas Rzz (duas para cada vizinho e duas para cada próximo vizinho) e só pode participar de uma por vez, então nenhum agendamento consegue fazer melhor.
Dois terços da profundidade são a interação, o que mostra que esta codificação se destaca no salto (hopping) e, portanto, na dinâmica de uma cadeia de férmions livres. No entanto, note que a interação não comuta com o salto. Deixá-la de fora não é uma aproximação de Fermi-Hubbard, mas um modelo diferente. Vale explorar onde fica o equilíbrio para um dado problema.
9. Verifique a dinâmica
Sob o mapa de parede de domínio, um padrão de ocupação se torna uma string de paridade cumulativa, então o estado inicial é preparado de forma diferente do que em Jordan-Wigner. Essa é uma consequência prática, fácil de passar despercebida, da deslocalização da paridade. O auxiliar da etapa 4 fornece o rótulo correto:
>>> occupations = [1, 0, 1, 0]
>>> initial_label = "".join(str(b) for b in reversed(domain_wall_bits(occupations)))
>>> initial_label
'00110'
Com o estado preparado, restam duas perguntas, e é melhor fazê-las separadamente: a síntese por conjuntos de fluxo calcula a coisa certa, e a calcula de forma mais barata?
Primeiro, a correção. FlowSetSynthesis e o LieTrotter do Qiskit recebem os mesmos conjuntos de fluxo codificados, vindos da mesma Trotterização fermiônica, então devem realizar a mesma unitária a menos de uma fase global. Os Cliffords personalizados reorganizam o trabalho; eles não mudam o resultado. Vetores de estado aleatórios detectam qualquer discrepância de forma muito mais barata do que construir a unitária completa:
>>> from qiskit.quantum_info import Statevector
>>>
>>> rng = np.random.default_rng(1234)
>>>
>>> def agrees_up_to_one_phase(reps, samples=3):
...     """Compare both qubit-side syntheses of the same fermionic Trotterization."""
...     step = trotter_steps(reps)
...     trotter = flow_set_pass_manager(step.register, LieTrotter()).run(step)
...     flow = flow_set_pass_manager(step.register, FlowSetSynthesis()).run(step)
...     trotter, flow = trotter.decompose(reps=6), flow.decompose(reps=6)
...     dimension = 2**trotter.num_qubits
...     residuals, phases = [], []
...     for _ in range(samples):
...         vector = rng.normal(size=dimension) + 1j * rng.normal(size=dimension)
...         state = Statevector(vector / np.linalg.norm(vector))
...         a = state.evolve(trotter).data
...         b = state.evolve(flow).data
...         overlap = np.vdot(a, b)
...         phases.append(overlap / abs(overlap))
...         residuals.append(np.linalg.norm(b - a * overlap / abs(overlap)))
...     # the SAME global phase must work for every input state
...     spread = max(abs(phase - phases[0]) for phase in phases)
...     return bool(max(residuals) < 1e-9), bool(spread < 1e-9)
>>>
>>> [agrees_up_to_one_phase(reps) for reps in (1, 3)]
[(True, True), (True, True)]
Ambas as metades dessa verificação importam. Uma sobreposição de módulo unitário em um único estado é necessária, mas não suficiente: uma síntese que errasse uma fase dependente do estado ainda passaria. Exigir a mesma fase em vários estados aleatórios é o que fecha a lacuna. Verificar mais de um valor de reps também importa, pois confirma que a concordância sobrevive à intercalação dos conjuntos de fluxo, em vez de valer apenas para uma única varredura.
Assim, a escolha da síntese do lado dos Qubits não tem consequência para a precisão, o que torna significativa uma comparação de custo. A pergunta restante é o que a codificação como um todo ganha em relação à alternativa óbvia: Jordan-Wigner puro em num_sites Qubits, sem ancilla e sem Cliffords personalizados. Tanto a codificação quanto a síntese do lado dos Qubits diferem entre as duas colunas, mas a verificação acima mostrou que esta última não pode afetar o resultado, então o que as fidelidades testam é a codificação. Além disso, ambos os pipelines partem da mesma Trotterização fermiônica, então qualquer diferença de fidelidade indicaria um bug e não um compromisso. As duas colunas são as codificações, conjuntos de fluxo contra Jordan-Wigner:
>>> def jordan_wigner_pass_manager(mode_register, product_formula):
...     """The same pipeline under plain Jordan-Wigner: one qubit per mode."""
...     synthesis = F2QSynthesis()
...     synthesis.methods["Evolution"] = MapperFnEvolutionSynthesis(
...         transfer_vertex_jordan_wigner, product_formula=product_formula
...     )
...     qubit_register = QuantumRegister(mode_register.size, "q")
...     return MultiStagePassManager(
...         input=FermionicCircuitToDAG(),
...         layout=CustomF2QLayout({mode_register: qubit_register}),
...         synthesis=synthesis,
...         output=QuantumDAGToCircuit(),
...     )
>>>
>>> from scipy.linalg import expm
>>>
>>> jw_state = np.zeros(2**num_sites, dtype=complex)
>>> jw_state[sum(o << j for j, o in enumerate(occupations))] = 1.0
>>> reference_jw = expm(-1j * total_time * jw_matrix) @ jw_state
>>> reference_flow = expm(-1j * total_time * flow_matrix) @ (isometry @ jw_state)
>>>
>>> def cost_and_fidelity(reps):
...     step = trotter_steps(reps)
...     flow = flow_set_pass_manager(step.register, FlowSetSynthesis()).run(step)
...     jw = jordan_wigner_pass_manager(step.register, LieTrotter()).run(step)
...     flow, jw = flow.decompose(reps=6), jw.decompose(reps=6)
...     two_qubit = lambda instruction: len(instruction.qubits) == 2
...     evolved_flow = Statevector.from_label(initial_label).evolve(flow).data
...     evolved_jw = Statevector(jw_state).evolve(jw).data
...     return (
...         abs(np.vdot(evolved_flow, reference_flow)) ** 2,
...         flow.count_ops()["cx"],
...         flow.depth(two_qubit),
...         abs(np.vdot(evolved_jw, reference_jw)) ** 2,
...         jw.count_ops()["cx"],
...         jw.depth(two_qubit),
...     )
>>>
>>> for reps in (1, 2, 4, 8):
...     flow_f, flow_cx, flow_d, jw_f, jw_cx, jw_d = cost_and_fidelity(reps)
...     print(
...         f"{reps} step(s):  flow set {flow_f:.6f}"
...         f" ({flow_cx:3d} CX, depth {flow_d:3d})"
...         f"   JW {jw_f:.6f} ({jw_cx:3d} CX, depth {jw_d:3d})"
...     )
1 step(s):  flow set 0.590661 ( 22 CX, depth  12)   JW 0.590661 ( 18 CX, depth  14)
2 step(s):  flow set 0.926656 ( 44 CX, depth  24)   JW 0.926656 ( 36 CX, depth  26)
4 step(s):  flow set 0.982053 ( 88 CX, depth  48)   JW 0.982053 ( 72 CX, depth  50)
8 step(s):  flow set 0.995395 (176 CX, depth  96)   JW 0.995395 (144 CX, depth  98)
Leia primeiro a coluna de fidelidade: idêntica, em todos os dígitos impressos, em dois espaços de Hilbert diferentes sob duas codificações diferentes. Isso é a Trotterização fermiônica transparecendo. A aproximação foi fixada na etapa 5, antes de qualquer codificação ser escolhida, então ambos os circuitos carregam exatamente o erro de uma fórmula de primeira ordem sobre três conjuntos de fluxo, e ele cai por volta de quatro vezes a cada duplicação do número de passos.
O que as codificações de fato diferem é o custo, e vale dizer a troca com clareza. O conjunto de fluxo gasta mais portas de emaranhamento: 22 contra 18 com um passo. O ancilla não é o motivo, já que não carrega nenhuma porta de dois Qubits própria. O motivo é a interação, exatamente como a etapa 3 alertou: deslocalizar a paridade transforma três termos ZZ entre vizinhos próximos em sete, abrangendo vizinhos próximos e próximos vizinhos, e cada um custa duas portas CX. Esse é o preço pago para tornar o salto barato.
Ela também ganha apenas por pouco em profundidade nesse tamanho (12 contra 14), porque quatro modos é pequeno demais para a assintótica aparecer. O ponto é a escala medida na etapa 8: essa profundidade de 12 é constante, enquanto a profundidade de Jordan-Wigner cresce com a cadeia. Com 14 modos já é 12 contra 34.
As chamadas a decompose() acima são essenciais, por duas razões independentes.
evolve() e Operator usam a definição exata de uma PauliEvolutionGate, ignorando uma síntese personalizada do lado dos Qubits. Verificar contra um circuito não decomposto informa fidelidade perfeita mesmo para uma síntese deliberadamente errada.
O mesmo vale um nível acima, para a síntese fermiônica. Uma porta Evolution que nunca é decomposta vai inteira para a etapa de férmion para Qubit, que a mapeia sem consultar Evolution.synthesis, de modo que reps silenciosamente não teria efeito. trotter_steps da etapa 5 realiza essa decomposição; um pipeline que define o método com F2FSynthesis obtém a mesma expansão a partir do passo.
Como verificação cruzada final, as densidades de sítio calculadas no espaço codificado devem reproduzir o resultado de Jordan-Wigner. Esta verificação trata da codificação, não do circuito, então nenhuma aproximação de Trotter entra nela. Ambas as evoluções temporais são calculadas exatamente, por exponenciação de matriz dos respectivos Hamiltonianos. Qualquer discrepância apontaria, portanto, para a codificação e não para uma fórmula de produto:
>>> time = 0.8
>>> state_jw = np.zeros(2**num_sites, dtype=complex)
>>> state_jw[sum(o << j for j, o in enumerate(occupations))] = 1.0
>>> evolved_jw = expm(-1j * time * jw_matrix) @ state_jw
>>> evolved_flow = expm(-1j * time * flow_matrix) @ (isometry @ state_jw)
>>>
>>> for j in range(num_sites):
...     v_flow = to_matrix(
...         SparseObservable.from_sparse_list([("ZZ", [j, j + 1], 1.0)], num_qubits)
...     )
...     v_jw = to_matrix(SparseObservable.from_sparse_list([("Z", [j], 1.0)], num_sites))
...     density_flow = (1 - np.vdot(evolved_flow, v_flow @ evolved_flow).real) / 2
...     density_jw = (1 - np.vdot(evolved_jw, v_jw @ evolved_jw).real) / 2
...     print(f"site {j}:  {density_flow:.10f}  {density_jw:.10f}")
site 0:  0.6507935456  0.6507935456
site 1:  0.5963201678  0.5963201678
site 2:  0.3365016619  0.3365016619
site 3:  0.4163846247  0.4163846247
As densidades concordam até dez casas decimais.
O que levar daqui
-
Agrupe antes de mapear. Os conjuntos de fluxo são definidos no grafo de interação fermiônico direcionado, então o agrupamento é escolhido enquanto a estrutura do problema ainda está disponível. O atributo
groupso leva para o circuito, onde um únicodecompose()o transforma em uma portaEvolutionpor conjunto de fluxo. -
Ancillas compram estrutura. Gastar um Qubit extra transforma um conjunto de fluxo inteiro em Paulis de peso 1, cuja evolução não precisa de portas de emaranhamento. A Ref. [1] observa essa troca de forma geral. Razões maiores de Qubits por férmion admitem circuitos de evolução mais rasos.
-
Uma codificação personalizada é uma função. Mapeie um único operador de transferência generalizado para uma string de Pauli;
map_transfer_vertex_generators()eMapperFnEvolutionSynthesisfazem o resto. -
O mapeamento e o agrupamento sozinhos não bastam. Dividir a evolução por conjunto de fluxo apenas desacelerou o crescimento linear da profundidade; uma síntese termo a termo de cada conjunto ainda jogava fora o fato de seus termos comutarem. Somente fornecer uma
EvolutionSynthesisque conhece os conjuntos de fluxo tornou a profundidade constante. Codificações personalizadas, agrupamento e síntese personalizada são complementares: os três são necessários. -
Duas fórmulas de produto, dois trabalhos. O
FermionicLieTrotterfixa a aproximação no espaço fermiônico, onde o agrupamento ainda é visível, então só ele define o erro de Trotter e o número de passos. AEvolutionSynthesisdo lado dos Qubits decide apenas quão barato é realizar cada conjunto: a etapa 9 confirma que as duas escolhas dão a mesma unitária. Separar as duas é o que permite ajustar a precisão e o custo de forma independente. Veja Sintetizar uma porta Evolution no espaço fermiônico. -
Verifique. Uma codificação que satisfaz as relações de comutação ainda pode representar um Hamiltoniano diferente se um prefator ou sinal estiver errado. Verificar uma relação de entrelaçamento (ou, mais barato, o espectro) detecta isso.
O FlowSetSynthesis acima é deliberadamente escrito para esta codificação em uma cadeia 1D. Ele faz correspondência de padrões com os rótulos de Pauli específicos que a codificação produz e gera um erro diante de qualquer outra coisa, em vez de recorrer silenciosamente a uma fórmula de produto genérica. Uma implementação geral tem duas metades. Ler a estrutura dos conjuntos de fluxo a partir dos groups do operador é o que um F2FSynthesisPlugin para uma evolução já faz. Derivar o Clifford diagonalizante a partir do grupo estabilizador, como descrito na Seção IV C da Ref. [1], é a metade que continua específica da codificação.
Além disso, deslocalizar a paridade faz o termo de interação ter peso 2 em vez de ser diagonal em Qubits individuais, que é o custo correspondente aos termos de salto mais baratos.
A seguir: duas dimensões
Tudo acima é unidimensional, e deliberadamente. Em uma cadeia, os conjuntos de fluxo são apenas as duas orientações das setas, e a codificação precisa de um único ancilla. Nenhuma das duas simplificações sobrevive em duas dimensões, que é onde codificações locais são necessárias.
Em uma rede planar, um conjunto de fluxo é um caminho direcionado (ou uma união de caminhos direcionados disjuntos em vértices) pelo grafo de interação, e encontrar um pequeno conjunto desses caminhos que cubra todas as arestas se torna um problema combinatório por si só, em vez de uma classificação de duas linhas. As codificações também mudam de caráter; em vez de um único ancilla para a cadeia inteira, adicionam um por sítio ou célula da rede. Verstraete-Cirac emparelha cada sítio fermiônico com seu próprio Qubit auxiliar, uma razão de Qubits por modo de , enquanto Derby-Klassen coloca um no centro de cada plaqueta ímpar, para uma razão de . O layout do registrador passa então a ter uma estrutura genuinamente bidimensional, e o grupo estabilizador sobre o qual é preciso projetar deixa de ser trivial. O Hamiltoniano codificado só é fiel em um subespaço, o que muda tanto a preparação de estado quanto a receita de verificação da etapa 4.
As peças que este guia constrói são as que se transferem: CustomF2QLayout para um registrador cujo tamanho difere do número de modos, map_transfer_vertex_generators() para a codificação em si, MapperFnEvolutionSynthesis para integrá-la ao transpilador, e uma EvolutionSynthesis personalizada para fazer a estrutura de conjuntos de fluxo valer a pena. Apenas a codificação e a decomposição em conjuntos de fluxo são diferentes.
O guia de conjuntos de fluxo 2D continua a partir daqui, trabalhando a codificação de Verstraete-Cirac em uma rede quadrada: quatro conjuntos de fluxo, um Clifford de profundidade 2 para cada um, e a projeção no estabilizador de que a verificação então precisa.
A. Gandon, S. Piccinelli, M. Rossmannek, F. Tacchino, A. Baiardi, J. Nys, and I. Tavernelli, Stabilizer-based quantum simulation of fermion dynamics with local qubit encodings (2026), arXiv:2512.11418v2.