Simule a dinâmica de Bose-Hubbard com uma escolha de codificação
Este guia constrói um circuito para a dinâmica temporal do modelo de Bose-Hubbard unidimensional, desde escrever o Hamiltoniano até conferir as densidades de sítio evoluídas com uma referência exata. O que torna esse caminho interessante é uma única ideia:
Não escolha uma codificação de bóson para qubit ao construir o circuito. Construa o circuito sobre modos bosônicos e deixe que o transpilador decida como esses modos se tornam qubits.
Para bósons, quase sempre é necessário adiar a codificação. Um modo bosônico comporta um número arbitrário de partículas, então seu espaço de Fock tem dimensão infinita e nenhuma codificação existe até que você escolha primeiro uma truncagem (o número de níveis de ocupação que você mantém). No código, a truncagem é dada como a maior ocupação que um modo pode ter, max_occupation , de modo que um modo que mantém os níveis tem max_occupation = 2 e .
Isso faz da truncagem um parâmetro da codificação, e não da física, e é um parâmetro que você quer variar: pequeno demais e a resposta fica errada, grande demais e o circuito fica desnecessariamente largo. Se você adia a codificação para o momento da transpilação, pode varrer a truncagem sem alterar o circuito, o Hamiltoniano ou o agrupamento.
O guia de operadores para a estrutura de dados de operadores, o guia de mappers para as codificações e a receita para escrever um mapper personalizado, e o guia de transpilação para as etapas do transpilador mencionadas ao longo do texto.
Truncagem e o que ela custa
Quando você trunca um modo em níveis, quebra o comutador canônico no nível mais alto mantido [1], de modo que nenhuma codificação é um isomorfismo de álgebras: uma codificação bosônica mapeia estados e operadores que atuam dentro do subespaço truncado. Duas consequências importam para tudo o que segue:
-
deve limitar a ocupação alcançável pela dinâmica, e não apenas a do estado inicial.
-
O mapeamento não comuta com a ordenação normal, então decida uma vez se seu Hamiltoniano é definido na forma normalmente ordenada e mantenha a consistência.
O guia de mappers deriva o defeito e mostra as duas consequências em código em execução.
1. O Hamiltoniano
O modelo de Bose-Hubbard em uma rede com ligações é
com . A interação conta pares de bósons em um sítio, portanto exige que um sítio comporte duas partículas ao mesmo tempo. Na forma normalmente ordenada, , que é a forma usada a seguir.
A geometria entra apenas pela lista de arestas, então nada é específico de uma cadeia:
>>> from qiskit_bosons.operators import BosonOperator, ann, cre
>>>
>>> def bose_hubbard(edges, num_sites, tunneling, interaction):
...     """Build the normal-ordered Bose-Hubbard Hamiltonian on an arbitrary lattice."""
...     terms = {}
...     for i, j in edges:
...         terms[(cre(i), ann(j))] = -tunneling
...         terms[(cre(j), ann(i))] = -tunneling
...     for i in range(num_sites):
...         # U/2 * n_i (n_i - 1), already normal-ordered
...         terms[(cre(i), cre(i), ann(i), ann(i))] = 0.5 * interaction
...     return BosonOperator.from_dict(terms)
>>>
>>> num_sites = 4
>>> edges = [(i, i + 1) for i in range(num_sites - 1)]
>>> hamiltonian = bose_hubbard(edges, num_sites, tunneling=1.0, interaction=2.0)
>>> print(f"Number of terms: {len(hamiltonian)}")
Number of terms: 10
Duas propriedades merecem ser conferidas primeiro. O Hamiltoniano precisa ser Hermitiano para que seja unitário, e ele conserva o número total de bósons:
>>> hamiltonian.is_hermitian()
True
>>> hamiltonian.conserves_particle_number()
True
Agora a questão bosônica: quantos níveis este operador exige?
>>> hamiltonian.max_occupation()
2
O termo de interação aplica dois operadores de criação a um modo, então um modo precisa comportar dois bósons para que o termo atue. Isso é uma ocupação máxima de 2, que é o número que LevelSpec recebe como max_occupation. Um modo que mantém as ocupações tem níveis, então max_occupation >= 2 é o mesmo requisito que .
Este é apenas um limite inferior: ele vem de uma única aplicação do operador, e a aplicação repetida ao longo de uma evolução temporal pode ir além. Ele descarta cortes que certamente são pequenos demais, e a etapa 6 define, para este modelo e estado, quão grande o corte precisa ser. mode_occupations() informa o limite para cada modo separadamente, que é com o que um corte por modo é comparado.
2. Agrupe antes de mapear
A evolução é trotterizada, e a forma como o Hamiltoniano é particionado decide o que é entregue à síntese. Duas considerações apontam na mesma direção.
Primeiro, uma física: o termo de hopping individual não é Hermitiano. Somente o par é. Se você evolui sob um único termo não Hermitiano, a operação não é unitária, e o operador mapeado carregaria coeficientes complexos que PauliEvolutionGate rejeita. Os dois termos de hopping de cada ligação devem, portanto, permanecer juntos.
Segundo, uma de eficiência: todos os termos de interação no sítio são diagonais na base de ocupação e comutam entre si, então podem compartilhar um único grupo e ser sintetizados juntos. O mesmo vale para as ligações que não tocam nenhum sítio em comum. Em uma cadeia, uma ligação sim, outra não forma esse conjunto: as ligações 0 e 2 atuam em pares disjuntos de modos, então seus termos de hopping comutam e podem compartilhar um grupo, e a ligação 1 forma um grupo próprio. Se você agrupa as ligações pares e ímpares, precisa portanto de três grupos, enquanto um grupo por ligação precisa de quatro. Menos grupos significam menos fatores e também um circuito mais raso: com o código de Gray em max_occupation = 2, a profundidade de dois qubits é 95 contra 139. A rede decide quais ligações podem compartilhar um grupo, e é por isso que a partição é escolhida aqui.
O atributo groups leva essa decisão para o circuito: uma porta Evolution sobre um operador agrupado se decompõe em uma subevolução por grupo. A partição é escolhida no nível bosônico, enquanto a estrutura da rede ainda está visível, e sobrevive intacta ao mapeamento. O guia de agrupamento cobre as verificações que um agrupamento deve passar.
>>> def group_of(actions, edges):
...     """Assign each term to the even bonds, the odd bonds, or the on-site group."""
...     creations = sorted(mode for action, mode in actions if action)
...     annihilations = sorted(mode for action, mode in actions if not action)
...     if creations == annihilations:
...         return 2  # diagonal: the on-site interaction group
...     bond = tuple(sorted(set(creations) | set(annihilations)))
...     return edges.index(bond) % 2  # bonds 0 and 2 share a group, bond 1 has its own
>>>
>>> hamiltonian.groups = [group_of(actions, edges) for actions, _ in hamiltonian.iter_terms()]
>>> hamiltonian.num_groups()
3
Cada grupo precisa ser Hermitiano por si só, que é o que o emparelhamento anterior garante. groups_are_hermitian() verifica todos os grupos em uma única chamada:
>>> from qiskit_bosons.operators.terms import groups_are_hermitian
>>> groups_are_hermitian(hamiltonian)
[True, True, True]
Para ver o que cada grupo contém, separe os grupos:
>>> for index, group in enumerate(hamiltonian.split_out_groups()):
...     print(f"group {index}: {len(group)} terms, hermitian={group.is_hermitian()}")
group 0: 4 terms, hermitian=True
group 1: 2 terms, hermitian=True
group 2: 4 terms, hermitian=True
O agrupamento em pares e ímpares é uma escolha, e a alternativa é fácil de medir. Se você der a cada ligação um grupo próprio, precisa de quatro grupos, e o mesmo circuito passa a custar mais profundidade de dois qubits. A profundidade é contada depois que o circuito é reduzido com o código de Gray em max_occupation = 2, que a etapa 4 explica:
>>> from qiskit.transpiler import PassManager
>>> from qiskit_bosons.circuit import BosonicCircuit
>>> from qiskit_bosons.circuit.library import Evolution
>>> from qiskit_bosons.mappers import LevelSpec
>>> from qiskit_bosons.transpiler.presets import generate_preset_occupation_pass_manager
>>>
>>> def two_qubit_depth(operator):
...     """The two-qubit depth of one evolution under ``operator``, lowered with the Gray code."""
...     probe = BosonicCircuit(num_sites)
...     probe.append(Evolution(num_sites, operator, time=0.4), probe.modes)
...     pass_manager = generate_preset_occupation_pass_manager(LevelSpec(2, "gray"))
...     pass_manager.qubit = PassManager()
...     lowered = pass_manager.run(probe.decompose())
...     return lowered.decompose(reps=6).depth(lambda instruction: len(instruction.qubits) == 2)
>>>
>>> per_bond = bose_hubbard(edges, num_sites, tunneling=1.0, interaction=2.0)
>>> per_bond.groups = [
...     len(edges) if sorted(m for a, m in actions if a) == sorted(m for a, m in actions if not a)
...     else edges.index(tuple(sorted({m for _, m in actions})))
...     for actions, _ in per_bond.iter_terms()
... ]
>>> per_bond.num_groups(), two_qubit_depth(per_bond)
(4, 139)
>>> hamiltonian.num_groups(), two_qubit_depth(hamiltonian)
(3, 95)
3. O circuito bosônico
Observe o que está ausente no circuito. Não há truncagem, nem codificação, nem número de qubits. Ele atua sobre quatro modos bosônicos:
>>> from qiskit_bosons.circuit import BosonicCircuit
>>> from qiskit_bosons.circuit.library import Evolution, InitializeModes
>>>
>>> total_time = 0.4
>>> occupation = [1, 1, 0, 0]  # one boson on each of the first two sites
>>>
>>> circuit = BosonicCircuit(num_sites)
>>> circuit.append(InitializeModes(occupation), circuit.modes)
>>> circuit.append(Evolution(num_sites, hamiltonian, time=total_time), circuit.modes)
>>> dict(circuit.count_ops())
{'InitializeModes': 1, 'Evolution': 1}

Os fios são modos bosônicos, não qubits. Observe que InitializeModes recebe inteiros, e não flags: um modo pode comportar qualquer número de bósons, então um estado de Fock é uma lista de números de ocupação.
Um único decompose() transforma o agrupamento da etapa 2 em uma porta por grupo:
>>> decomposed = circuit.decompose()
>>> dict(decomposed.count_ops())
{'Evolution': 3, 'InitializeModes': 1}
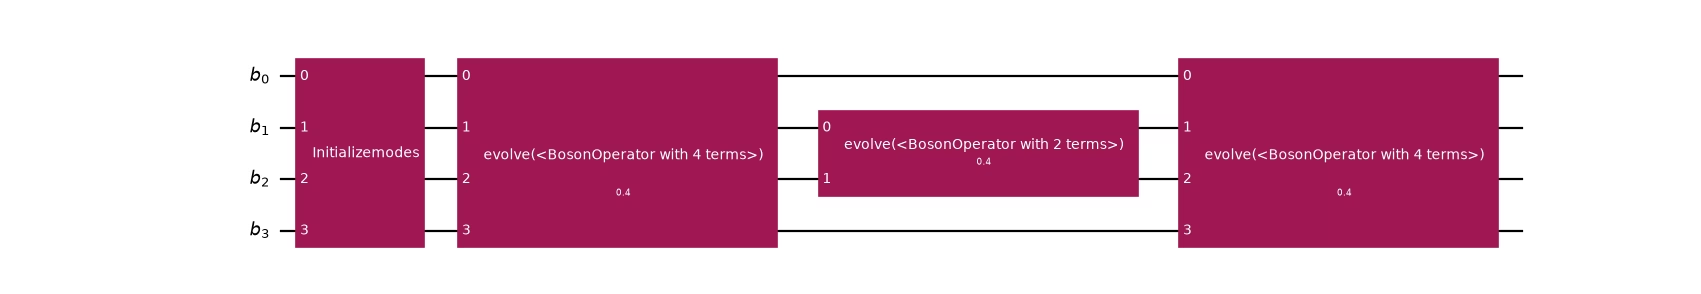
O primeiro grupo contém as ligações nos modos 0 e 1 e nos modos 2 e 3, então sua porta abrange os quatro modos, assim como o grupo no sítio. A ligação do meio tem uma porta própria nos modos 1 e 2.
Se você pular essa decomposição, o agrupamento é simplesmente ignorado. O método que faz a divisão é a synthesis da porta, com BosonicLieTrotter como padrão; Sintetizar uma porta Evolution no espaço bosônico mostra as alternativas.
4. Escolha a codificação no momento da transpilação
Aqui está a vantagem. O mesmo circuito é reduzido quatro vezes, com quatro valores diferentes de LevelEncoding, mudando um único argumento. Um LevelSpec associa a codificação à truncagem de cada modo, e o preset a seguir deriva o layout, a preparação de estado e o mapeamento do operador a partir dessa única especificação (veja Descreva a truncagem com um LevelSpec). Uma string como "gray" é aceita sempre que um LevelEncoding é.
>>> from qiskit.transpiler import PassManager
>>> from qiskit_bosons.mappers import LevelEncoding, LevelSpec
>>> from qiskit_bosons.transpiler.presets import generate_preset_occupation_pass_manager
>>>
>>> max_occupation = 2  # the largest occupation per mode, so d = max_occupation + 1 = 3 levels
>>>
>>> encodings = (
...     LevelEncoding.UNARY_PROJECTED,
...     LevelEncoding.UNARY_UNPROJECTED,
...     LevelEncoding.STANDARD_BINARY,
...     LevelEncoding.GRAY,
... )
>>> for encoding in encodings:
...     pass_manager = generate_preset_occupation_pass_manager(
...         LevelSpec(max_occupation, encoding)
...     )
...     pass_manager.qubit = PassManager()  # keep the circuit as the pipeline synthesized it
...     qubit_circuit = pass_manager.run(decomposed)
...     basis = qubit_circuit.decompose(reps=6)
...     two_qubit = basis.depth(lambda instruction: len(instruction.qubits) == 2)
...     print(f"{encoding!s:18s} qubits={qubit_circuit.num_qubits:2d}  2q-depth={two_qubit:4d}")
unary_projected    qubits=12  2q-depth= 645
unary_unprojected  qubits=12  2q-depth= 383
standard_binary    qubits= 8  2q-depth= 218
gray               qubits= 8  2q-depth=  95
Esses números contradizem um palpite natural. As codificações unárias usam qubits por modo contra para os códigos compactos, e em os códigos compactos vencem nos dois eixos ao mesmo tempo: menos qubits e muito menos portas de emaranhamento. As duas variantes unárias diferem no operador que emitem, não no layout: LevelEncoding.UNARY_PROJECTED carrega um projetor em cada outro qubit de um modo, o que a torna a mais cara das quatro para evoluir, e LevelEncoding.UNARY_UNPROJECTED omite os projetores e concorda com ela no subespaço one-hot. O guia de mappers mostra os dois operadores lado a lado e explica por que o código de Gray supera o binário padrão (SB) nos termos de hopping.
Sawaya et al. relatam a mesma ordem [2]:
embora o código unário tenda a exigir mais qubits, mas menos operações, é frequente que o código SB ou de Gray seja mais eficiente tanto em número de qubits quanto em número de operações
A conclusão deles é que o melhor código depende do Hamiltoniano e de , o que é o argumento mais forte para não fixar a escolha no circuito.
Sob uma codificação de níveis, um modo abrange vários qubits, então o registrador de qubits é mais largo que o registrador de modos. O preset usa OccupationB2QLayout, que deriva a largura do registrador a partir do LevelSpec. O guia de transpilação percorre as etapas que o preset executa.
5. Verifique com a dinâmica exata
Nenhuma das etapas anteriores estabelece que o circuito está correto. Para isso, compare as densidades de sítio após a evolução com uma referência exata calculada sobre o Hamiltoniano codificado.
A referência precisa ser calculada no mesmo espaço truncado em que o circuito trabalha, porque comparar com um cálculo sem truncagem misturaria o erro de Trotter com o erro de truncagem, que são coisas diferentes e vale a pena separá-las (veja Truncar o espaço de Fock).
>>> import numpy as np
>>> from qiskit.quantum_info import SparsePauliOp, Statevector
>>> from scipy.sparse.linalg import expm_multiply
>>> from qiskit_bosons.mappers.library import occupation_encoding
>>>
>>> def sparse_matrix(operator, encoding):
...     """Map a bosonic operator and hand back a sparse qubit matrix."""
...     spec = LevelSpec(max_occupation, encoding).resolve(num_sites)
...     observable = occupation_encoding(operator, spec)
...     return SparsePauliOp.from_sparse_observable(observable).to_matrix(sparse=True)
>>>
>>> def fock_index(occupation, encoding):
...     """The computational basis index encoding a product Fock state."""
...     spec = LevelSpec(max_occupation, encoding).resolve(num_sites)
...     return sum(
...         encoding.level_to_bits(n) << offset for n, offset in zip(occupation, spec.offsets)
...     )
>>>
>>> def densities(state, encoding):
...     """The per-site boson number <n_m> of an encoded state vector."""
...     out = []
...     for mode in range(num_sites):
...         number = BosonOperator.from_dict({(cre(mode), ann(mode)): 1.0})
...         matrix = sparse_matrix(number, encoding)
...         out.append(float((state.conj() @ (matrix @ state)).real))
...     return out
Com isso em mãos, a evolução exata no espaço truncado:
>>> encoding = LevelEncoding.GRAY
>>> num_qubits = LevelSpec(max_occupation, encoding).resolve(num_sites).total_width
>>>
>>> initial = np.zeros(2**num_qubits, dtype=complex)
>>> initial[fock_index(occupation, encoding)] = 1.0
>>>
>>> evolved_exact = expm_multiply(
...     -1j * total_time * sparse_matrix(hamiltonian, encoding), initial
... )
>>> reference = densities(evolved_exact, encoding)
>>> for site, value in enumerate(reference):
...     print(f"site {site}: {value:.6f}")
site 0: 0.993834
site 1: 0.858853
site 2: 0.141309
site 3: 0.006004
Os bósons se espalham da extremidade ocupada da cadeia em direção à vazia, e os dois bósons são conservados:
>>> bool(np.isclose(sum(reference), 2.0))
True
Agora o circuito. Observe que a referência anterior foi construída diretamente a partir de initial, então o circuito comparado com ela deve conter apenas a evolução, porque a porta InitializeModes prepararia de novo um estado que já está preparado.
>>> from qiskit_bosons.circuit.library.synthesis import BosonicLieTrotter
>>>
>>> def trotter_densities(steps, encoding):
...     """Site densities after `steps` first-order Trotter steps of the grouped evolution."""
...     circuit = BosonicCircuit(num_sites)
...     circuit.append(
...         Evolution(
...             num_sites, hamiltonian, time=total_time, synthesis=BosonicLieTrotter(reps=steps)
...         ),
...         circuit.modes,
...     )
...     pass_manager = generate_preset_occupation_pass_manager(
...         LevelSpec(max_occupation, encoding)
...     )
...     qubit_circuit = pass_manager.run(circuit.decompose())
...     # decompose BEFORE evolving: see the warning that follows
...     basis = qubit_circuit.decompose(reps=6)
...     state = np.asarray(Statevector(initial).evolve(basis).data)
...     return densities(state, encoding)
>>>
>>> for steps in (1, 2, 4, 8, 16):
...     error = max(
...         abs(a - b) for a, b in zip(trotter_densities(steps, encoding), reference)
...     )
...     print(f"steps={steps:2d}  max density error = {error:.4f}")
steps= 1  max density error = 0.0843
steps= 2  max density error = 0.0389
steps= 4  max density error = 0.0183
steps= 8  max density error = 0.0088
steps=16  max density error = 0.0043
O erro cai pela metade quando o número de passos dobra, que é a assinatura de uma fórmula de produto de primeira ordem. Essa é a evidência de que a discrepância é erro de Trotter e de que a codificação é fiel.
As repetições vêm da synthesis da porta, que trotteriza no espaço bosônico, onde o agrupamento ainda existe: cada passo aplica cada grupo uma vez, e os passos se seguem um ao outro. Isso é diferente de entregar um LieTrotter com reps > 1 ao plugin de síntese em nível de qubit. Ali, cada grupo já é sua própria PauliEvolutionGate, então a fórmula apenas subdivide os termos dentro de um grupo e nunca intercala os grupos. Os grupos não comutam entre si, então isso deixa um único passo de Trotter externo, cujo erro não diminui por maior que seja reps. Sintetizar uma porta Evolution no espaço bosônico compara os dois e cobre ordens superiores.
A chamada anterior a decompose() é essencial. evolve() usa a definição exata de uma PauliEvolutionGate e ignora completamente a fórmula de produto. Se você verifica com um circuito não decomposto, vê uma concordância quase perfeita até para uma síntese deliberadamente errada. O circuito não decomposto também força a construção de um operador denso , enquanto um circuito decomposto aplica as portas uma de cada vez. Outros simuladores podem tratar a porta de forma diferente, então essa verificação depende do simulador, enquanto o hardware sempre precisa da forma decomposta.
Por fim, a verificação central: a física não deve depender de qual codificação foi escolhida.
>>> def exact_densities(encoding):
...     """Exact truncated-space densities, computed under a given encoding."""
...     width = LevelSpec(max_occupation, encoding).resolve(num_sites).total_width
...     start = np.zeros(2**width, dtype=complex)
...     start[fock_index(occupation, encoding)] = 1.0
...     evolved = expm_multiply(
...         -1j * total_time * sparse_matrix(hamiltonian, encoding), start
...     )
...     return densities(evolved, encoding)
>>>
>>> all(
...     bool(np.allclose(exact_densities(name), reference, atol=1e-10))
...     for name in encodings
... )
True
Os números de qubits, as estruturas de Pauli e as profundidades dos circuitos diferem, e a física concorda até dez casas decimais. A codificação é uma escolha de implementação, e é por isso que ela pertence ao transpilador. As duas variantes unárias concordam aqui porque o estado simulado permanece no subespaço one-hot; fora dele, elas diferiam.
6. A truncagem é um parâmetro de convergência
A etapa final é específica de bósons. Tudo até aqui fixou max_occupation = 2, ou seja, . No entanto, a truncagem não é uma escolha livre: é um parâmetro de convergência, e uma resposta só é confiável depois que deixa de se mover (veja Truncar o espaço de Fock).
O circuito não carrega truncagem, então o próprio circuito não muda quando o corte muda: apenas a transpilação é repetida. O que muda é o tamanho do que sai, e uma varredura só é tão barata quanto aqui porque o sistema é minúsculo. A referência a seguir é uma simulação clássica exata da dinâmica truncada, o que é possível para quatro sítios e cresce exponencialmente com o número de qubits. Para um problema além desse alcance, não há referência exata para comparar, e a convergência precisa ser julgada por outros meios.
>>> def densities_at_cutoff(max_occ, encoding=LevelEncoding.GRAY):
...     """Exact truncated-space densities at a given cutoff."""
...     spec = LevelSpec(max_occ, encoding).resolve(num_sites)
...
...     start = np.zeros(2**spec.total_width, dtype=complex)
...     start[
...         sum(encoding.level_to_bits(n) << offset for n, offset in zip(occupation, spec.offsets))
...     ] = 1.0
...
...     def matrix(operator):
...         observable = occupation_encoding(operator, spec)
...         return SparsePauliOp.from_sparse_observable(observable).to_matrix(sparse=True)
...
...     evolved = expm_multiply(-1j * total_time * matrix(hamiltonian), start)
...     out = []
...     for mode in range(num_sites):
...         number = BosonOperator.from_dict({(cre(mode), ann(mode)): 1.0})
...         out.append(float((evolved.conj() @ (matrix(number) @ evolved)).real))
...     return out
>>>
>>> previous = None
>>> for max_occ in (1, 2, 3, 4):
...     current = densities_at_cutoff(max_occ)
...     # Report the drift bucketed rather than to full precision: after it reaches machine
...     # epsilon, the exact digits are arithmetic noise and vary between BLAS builds.
...     if previous is None:
...         drift = "--"
...     else:
...         gap = max(abs(a - b) for a, b in zip(current, previous))
...         drift = f"{gap:.0e}" if gap > 1e-12 else "< 1e-12"
...     print(f"d={max_occ + 1}  "
...           + " ".join(f"{x:.6f}" for x in current)
...           + f"   drift={drift}")
...     previous = current
d=2  0.993986 0.858173 0.141827 0.006014   drift=--
d=3  0.993834 0.858853 0.141309 0.006004   drift=7e-04
d=4  0.993834 0.858853 0.141309 0.006004   drift=< 1e-12
d=5  0.993834 0.858853 0.141309 0.006004   drift=< 1e-12
Em max_occupation = 1 (), cada sítio comporta no máximo um bóson, então o termo de interação, que precisa de dois em um sítio, não consegue atuar, e as densidades ficam erradas em cerca de . Quando você adiciona o terceiro nível, o resultado captura a interação, e a partir de max_occupation = 3 o resultado fica estacionário até a precisão de máquina: convergido.
O motivo de parar em max_occupation = 2 é o número de partículas. O Hamiltoniano conserva o número de bósons, e este estado tem dois, então nenhum sítio pode jamais ter mais de dois, seja qual for o tempo de evolução e quer a interação seja repulsiva ou atrativa. Se você evoluir até em vez de , ou inverter o sinal de , as densidades em max_occupation = 2 e acima permanecem inalteradas até .
O que de fato eleva o requisito é o número de bósons. Três bósons na mesma cadeia mudam cerca de entre max_occupation = 2 e 3 após a mesma evolução curta, e cerca de após . Isso é uma afirmação sobre este modelo e uma quantidade conservada, e é um limite apenas para operadores que conservam o número de partículas; não é uma regra geral, então o corte precisa ser varrido, não adivinhado.
A varredura também tem um preço do lado do circuito, que a referência exata não mostra. O mesmo circuito bosônico, reduzido com o código de Gray em cada corte:
>>> for max_occ in (1, 2, 3, 4):
...     pass_manager = generate_preset_occupation_pass_manager(
...         LevelSpec(max_occ, LevelEncoding.GRAY)
...     )
...     pass_manager.qubit = PassManager()
...     lowered = pass_manager.run(decomposed)
...     depth = lowered.decompose(reps=6).depth(lambda instruction: len(instruction.qubits) == 2)
...     print(f"d={max_occ + 1}  qubits={lowered.num_qubits:2d}  2q-depth={depth:4d}")
d=2  qubits= 4  2q-depth=   8
d=3  qubits= 8  2q-depth=  95
d=4  qubits= 8  2q-depth= 217
d=5  qubits=12  2q-depth=1176
Cada nível extra custa profundidade, e o número de qubits salta sempre que passa por uma potência de dois. Quando você converge em , portanto, troca precisão por tamanho do circuito, de modo que a varredura é mais do que uma verificação numérica.
Observe também que estar quase certo é uma coincidência do observável: as densidades de sítio quase não se movem, enquanto o estado subjacente está qualitativamente errado (ele não tem componente duplamente ocupada). Se um observável converge, isso não mostra que outro convergiu.
O que levar daqui
-
A codificação é uma preocupação do transpilador. O circuito bosônico do passo 3 não menciona truncamento, codificação nem número de qubits. Quatro codificações o converteram em quatro circuitos diferentes, todos reproduzindo a mesma física. Nada antes do transpilador precisou mudar.
-
Para bósons, isso não é apenas conveniente. O truncamento é um parâmetro de convergência que precisa ser varrido, e ele vive dentro da codificação. Um circuito construído para uma codificação fixa teria que ser reconstruído para cada valor de .
-
Agrupe antes de mapear, e agrupe pensando na hermiticidade. Um único termo de salto (hopping) não é hermitiano e não pode ser exponenciado; o par de termos de uma ligação, por outro lado, é hermitiano e, portanto, pode ser exponenciado. Decida a partição no nível bosônico, onde a rede ainda é visível. Isso é fisicamente necessário, e o atributo
groupsexiste para levar essa decisão adiante. -
Não presuma que a codificação de baixo peso é a mais barata. Em , os códigos compactos superam as duas variantes unárias ao mesmo tempo em qubits e portas, e a variante projetada é a mais cara de todas. Meça; o ponto de cruzamento depende de .
-
O truncamento quebra a álgebra, de uma forma quantificável. Apenas no nível retido mais alto, por . É também por isso que o mapeamento não comuta com a ordenação normal.
Próximos passos
Duas direções ampliam este exemplo. Se você substituir a lista de arestas da cadeia pelas ligações de uma rede quadrada, nenhuma outra mudança é necessária, porque a função bose_hubbard definida antes já é independente da geometria. Uma codificação personalizada sua (um código bloco-unário, por exemplo, que interpola entre o unário e o compacto) também se encaixa pelo mesmo ponto de extensão MapperFnEvolutionSynthesis que o preset usa.
-
Princípios de design das representações de operadores explica a estrutura de dados de operador por trás do Hamiltoniano.
-
Mapear representações de operadores aborda as codificações e como escrever seu próprio mapeador.
-
Transpilar circuitos bosônicos percorre as etapas que o preset executa.
-
Sintetizar uma porta Evolution no espaço bosônico mostra como reduzir o erro de Trotter no espaço bosônico.
Toda profundidade informada refere-se a um registrador abstrato e totalmente conectado. O mapeamento para a conectividade de um hardware real é uma etapa separada, e os blocos de qubits por modo de uma codificação de ocupação dão ao roteador uma estrutura bem diferente da de um qubit por modo.
[1]
R. Somma, G. Ortiz, E. Knill, and J. Gubernatis, Quantum Simulations of Physics Problems (2003), arXiv:quant-ph/0304063, Sec. 4, Eq. 22.
[2]
N. P. D. Sawaya, T. Menke, T. H. Kyaw, S. Johri, A. Aspuru-Guzik, and G. G. Guerreschi, Resource-efficient digital quantum simulation of d-level systems for photonic, vibrational, and spin-s Hamiltonians, npj Quantum Information 6, 49 (2020), arXiv:1909.12847.