Use diferentes normas Lp para o truncamento de termos de Pauli
Nota: Antes de ler este guia, você deve ler o guia Truncar termos de Pauli, que descreve o truncamento de termos de Pauli de baixo peso incorporado ao método backpropagate com base em um TruncationErrorBudget especificado.
Neste guia, você vai aprender sobre o argumento nomeado p_norm do backpropagate, que pode ser usado para mudar a norma Lp usada para estimar o erro incorrido pelos termos de Pauli truncados.
Construa um circuito de exemplo
Este guia usa o mesmo circuito de exemplo do guia Truncar termos de Pauli:
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "qiskit": "qiskit", "qiskit_addon_obp": "qiskit-addon-obp", "qiskit_addon_utils": "qiskit-addon-utils", "rustworkx": "rustworkx"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import rustworkx.generators
from qiskit.synthesis import LieTrotter
from qiskit_addon_utils.problem_generators import (
    PauliOrderStrategy,
    generate_time_evolution_circuit,
    generate_xyz_hamiltonian,
)
from qiskit_addon_utils.slicing import combine_slices, slice_by_gate_types

# Generate a linear chain of 10 qubits
num_qubits = 10
linear_chain = rustworkx.generators.path_graph(num_qubits)

# Use an arbitrary XY model
hamiltonian = generate_xyz_hamiltonian(
    linear_chain,
    coupling_constants=(0.05, 0.02, 0.0),
    ext_magnetic_field=(0.02, 0.08, 0.0),
    pauli_order_strategy=PauliOrderStrategy.InteractionThenColor,
)
# Evolve for some time
circuit = generate_time_evolution_circuit(
    hamiltonian, synthesis=LieTrotter(reps=3), time=2.0
)
# slice the circuit by gate type
slices = slice_by_gate_types(circuit)

# For visualization purposes only, recombine the slices with barriers between them and draw the resulting circuit
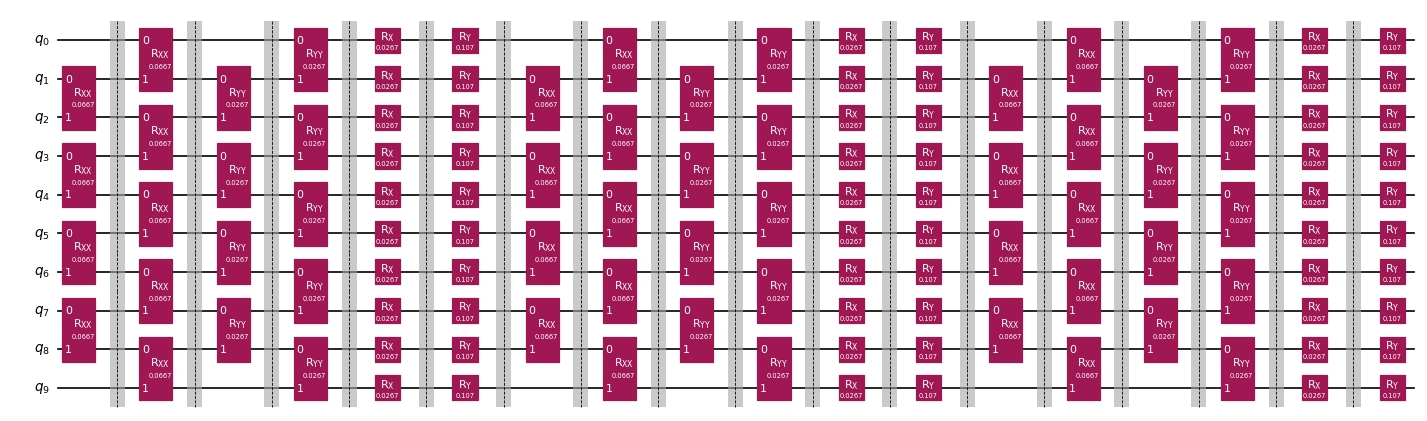
combine_slices(slices, include_barriers=True).draw("mpl", fold=50, scale=0.6)
Defina um observável para a magnetização total:
from qiskit.quantum_info import SparsePauliOp

obs = SparsePauliOp.from_sparse_list(
    [("Z", [i], 1.0) for i in range(num_qubits)], num_qubits=num_qubits
)
Como referência, calcule o valor esperado exato:
from qiskit.primitives import StatevectorEstimator

estimator = StatevectorEstimator()
job = estimator.run([(circuit, obs)])
res = job.result()
exact_exp = res[0].data.evs
print(exact_exp)
9.318197859862146
Use a norma L1
Por padrão, e como você já viu no guia Truncar termos de Pauli, p_norm=1, o que significa que o erro é estimado como:
onde é o estado quântico, é a diferença real entre o observável exato e o truncado (que é desconhecida), é o conjunto de termos de Pauli que foram truncados e é o coeficiente do termo de Pauli.
Essa desigualdade é um limite superior rigoroso, mas muito frouxo para a maioria dos cenários.
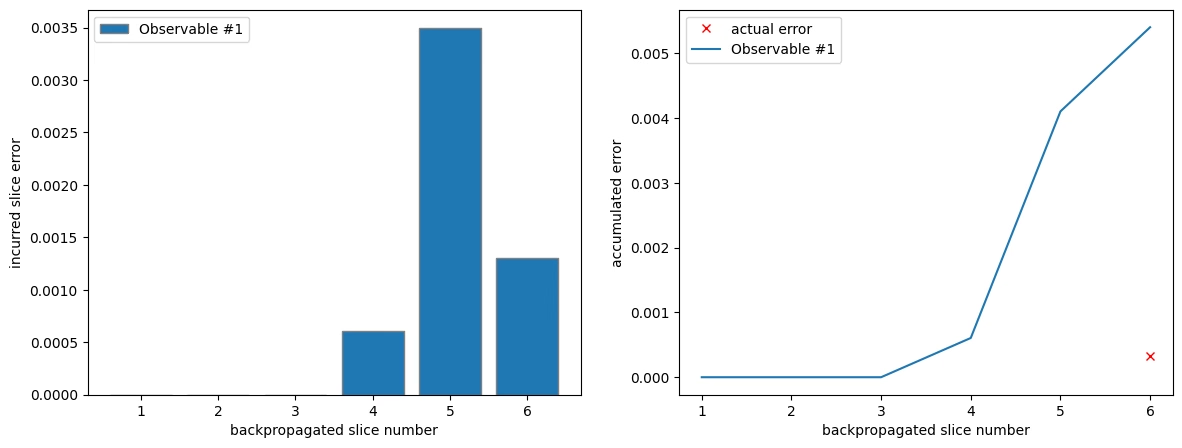
Este guia faz a retropropagação de seis fatias do circuito de exemplo, usando um erro constante por fatia de 0.001. Esse valor deve ser entendido como o orçamento dentro do p_norm dado.
from qiskit_addon_obp.utils.truncating import setup_budget

l1_truncation_error_budget = setup_budget(max_error_per_slice=0.001, p_norm=1)
print(l1_truncation_error_budget)
TruncationErrorBudget(per_slice_budget=[0.001], max_error_total=inf, p_norm=1)
from qiskit_addon_obp import backpropagate

max_slices = 6
l1_bp_obs, l1_remaining_slices, l1_metadata = backpropagate(
    obs,
    slices[-max_slices:],
    truncation_error_budget=l1_truncation_error_budget,
)
l1_reduced_circuit = combine_slices(
    slices[:-max_slices] + l1_remaining_slices
)
print(
    f"Backpropagated {max_slices - len(l1_remaining_slices)} circuit slices."
)
print(
    f"New observable contains {len(l1_bp_obs)} terms and {len(l1_bp_obs.group_commuting(qubit_wise=True))} commuting groups."
)
Backpropagated 6 circuit slices.
New observable contains 116 terms and 10 commuting groups.
Agora podemos calcular o valor esperado do observável retropropagado, bem como o erro em relação à referência exata:
estimator = StatevectorEstimator()
job = estimator.run([(l1_reduced_circuit, l1_bp_obs)])
res = job.result()
l1_exp = res[0].data.evs
l1_error = exact_exp - l1_exp
print(l1_exp, l1_error)
9.317869899338842 0.00032796052330397174
Por fim, podemos plotar o erro incorrido durante a retropropagação de cada fatia, bem como o erro acumulado. O erro acumulado é a soma dos erros das fatias. Podemos ver que o erro acumulado é um limite superior muito frouxo para o erro real.
from matplotlib import pyplot as plt
from qiskit_addon_obp.utils.visualization import (
    plot_accumulated_error,
    plot_slice_errors,
)

fig, axes = plt.subplots(1, 2, figsize=(14, 5))
axes[1].plot([6], [l1_error], "x", color="red", label="actual error")
plot_slice_errors(l1_metadata, axes[0])
plot_accumulated_error(l1_metadata, axes[1])
Use a norma L2
Pode-se argumentar que a norma L2 é uma aproximação melhor do erro incorrido do que a norma L1. Isso porque podemos supor que o estado quântico é sorteado de um ensemble aleatório de Haar, caso em que o erro incorrido segue uma distribuição com média nula e uma variância que pode ser limitada aproximadamente pela norma L2:
Embora o limite não seja rigoroso, ele só será violado em casos patológicos.
Novamente fazemos a retropropagação de seis fatias do circuito de exemplo, usando um erro máximo por fatia de 0.001 (desta vez, interpretado na norma L2).
l2_truncation_error_budget = setup_budget(max_error_per_slice=0.001, p_norm=2)
print(l2_truncation_error_budget)
TruncationErrorBudget(per_slice_budget=[0.001], max_error_total=inf, p_norm=2)
max_slices = 6
l2_bp_obs, l2_remaining_slices, l2_metadata = backpropagate(
    obs,
    slices[-max_slices:],
    truncation_error_budget=l2_truncation_error_budget,
)
l2_reduced_circuit = combine_slices(
    slices[:-max_slices] + l2_remaining_slices
)
print(
    f"Backpropagated {max_slices - len(l2_remaining_slices)} circuit slices."
)
print(
    f"New observable contains {len(l2_bp_obs)} terms and {len(l2_bp_obs.group_commuting(qubit_wise=True))} commuting groups."
)
Backpropagated 6 circuit slices.
New observable contains 84 terms and 6 commuting groups.
Novamente, calculamos o valor esperado do observável retropropagado e o erro em relação à referência exata:
estimator = StatevectorEstimator()
job = estimator.run([(l2_reduced_circuit, l2_bp_obs)])
res = job.result()
l2_exp = res[0].data.evs
l2_error = exact_exp - l2_exp
print(l2_exp, l2_error)
9.317829770853422 0.00036808900872387085
Plotar os erros incorridos por fatia e o erro acumulado resulta em um quadro semelhante ao anterior.
fig, axes = plt.subplots(1, 2, figsize=(14, 5))
axes[1].plot([6], [l2_error], "x", color="red", label="actual error")
plot_slice_errors(l2_metadata, axes[0])
plot_accumulated_error(l2_metadata, axes[1])
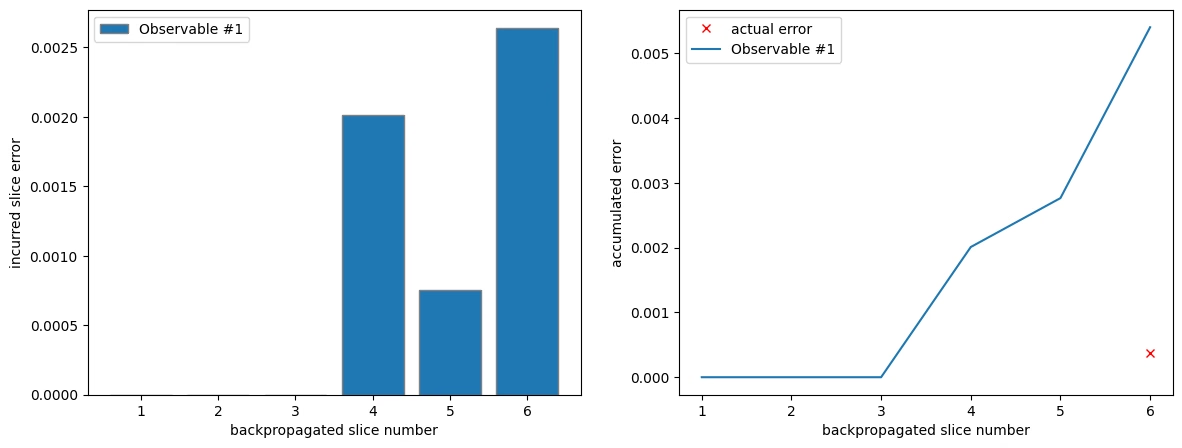
Observe que o erro acumulado é, de novo, a soma dos erros de cada fatia. Esse é outro limite frouxo, devido à desigualdade de Minkowski, já que precisamos calcular esse limite de forma recursiva:
onde o novo subscrito indica a iteração de fatia atual, fazendo de o erro real na iteração de retropropagação , de o erro de truncamento aproximado da iteração e de o conjunto de termos de Pauli truncados na iteração .